1-Bit Bonsai Image 4B:面向本地设备的图像生成模型
Bonsai Image 4B 是首个可在 iPhone 上本地运行的 4B 参数图像生成模型,通过 1-bit 和三值量化技术将内存占用降低 6-8 倍,支持在手机端生成 512x512 图像仅需 9.4 秒。
入选理由:1-bit Bonsai Image 4B 将扩散 Transformer 内存从 7.75GB 压缩至 0.93GB,压缩比达 8.3x,适合内存受限设备。
traeai 专题雷达
追踪 Ollama、llama.cpp、vLLM、LM Studio、量化、GPU/CPU 推理、私有化部署与端侧模型应用。
想在本地或私有环境运行大模型,比较工具链、性能成本和部署方案。
本地推理把 AI 能力从云 API 扩展到隐私、成本、低延迟和离线场景,是长期基础设施方向。
这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。
持续抓取与 本地 LLM 推理 相关的高分文章、播客、视频和推文。
把最近变化、反复出现的观点和争议点整理成稳定摘要。
自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。
按相关度、评分和更新时间筛出的可读内容。
Bonsai Image 4B 是首个可在 iPhone 上本地运行的 4B 参数图像生成模型,通过 1-bit 和三值量化技术将内存占用降低 6-8 倍,支持在手机端生成 512x512 图像仅需 9.4 秒。
入选理由:1-bit Bonsai Image 4B 将扩散 Transformer 内存从 7.75GB 压缩至 0.93GB,压缩比达 8.3x,适合内存受限设备。
自适应对冲请求可将p99延迟降低74%,其核心是用实时学习的延迟分布动态触发对冲,而非静态阈值或重试;DDSketch实现O(1)内存量化估算,配合令牌桶限流防止负载雪崩。
入选理由:在100个下游服务、各1%慢请求率的扇出架构中,63%的顶层请求会被至少一个慢请求拖累,导致单服务健康指标失真。
中国AI公司突破三值量化技术,使600亿参数模型可在手机运行,节省6倍显存且性能损失极小。
入选理由:三值量化可节省6倍显存,保留97%模型能力,支持在8GB内存手机运行600亿参数模型。
腾讯混元开源 Hy-MT1.5-1.8B-1.25bit 翻译模型:仅440MB,支持33种语言+5种方言,1.25-bit量化无损精度,手机端全离线运行,性能超越Google Translate及部分商用API。
入选理由:25-bit超低比特量化实现440MB体积,较FP16压缩7.5倍且零精度损失
本书深入讲解如何构建多智能体AI系统,通过LangGraph、MCP、A2A协议及Ollama实现状态管理、工具集成、跨框架协调及本地LLM推理,以实战代码构建学习加速器,展现生产级架构设计。
入选理由:使用LangGraph进行状态化智能体编排,解决多智能体系统可靠性问题。
Redis之父antirez为DeepSeek V4 Flash打造专用推理引擎ds4.c,仅支持Apple Silicon,在Mac上实现高达58.52 token/s的推理速度。
入选理由:ds4.c使用Metal-only架构,专用于Apple Silicon设备,无框架依赖。
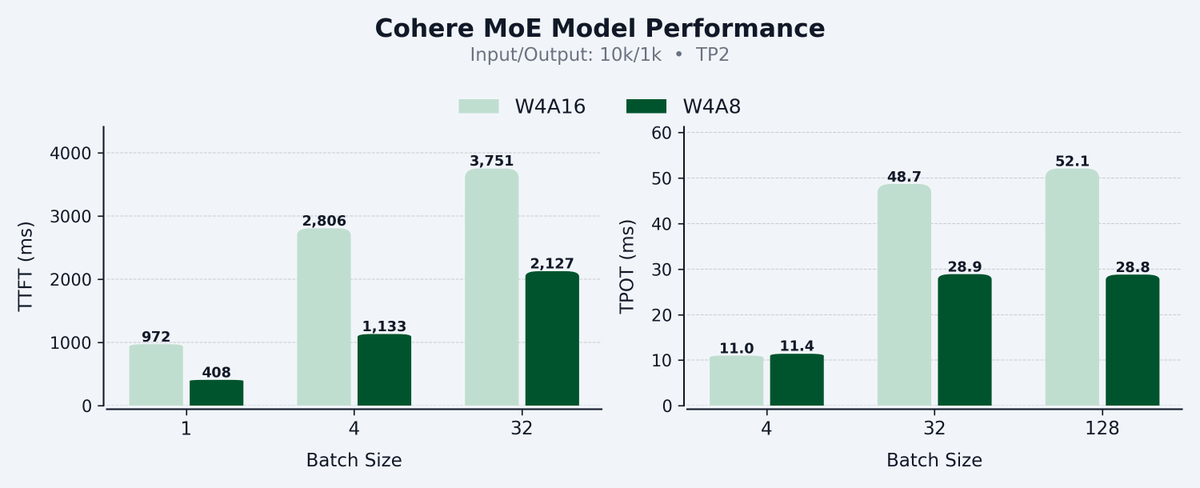
Cohere实现了生产级W4A8推理优化,并集成到vLLM中,显著提升性能。
入选理由:结合4-bit权重和8-bit激活实现内存与计算平衡。
微软研究院联合高校提出ADeLe评估框架,通过18项核心能力维度对大模型与任务进行双向量化评分。该方法能构建模型能力画像,以约88%的准确率预测未知任务表现,并精准定位模型失败原因,有效弥补传统基准测试缺乏解释性与预测力的缺陷。
入选理由:ADeLe将模型与任务映射至18项核心能力维度(0-5分),实现需求与能力的结构化对齐。
架构变更案例(Architectural Change Cases)是评估架构决策随时间演进而非仅记录当前状态的工具,通过量化变更概率与逆转成本来对抗系统衰退。它补充了ADR的静态视角,结合事前验尸和混沌工程识别隐性假设,特别适用于应对AI代码生成带来的可维护性风险及业务环境的不确定性。
入选理由:架构变更案例包含QAR变化、变更概率、受影响决策列表及T恤尺寸估算的逆转成本。
Claude Opus 4.8多项能力已达Mythos级别,但‘诚实性’仅为渐进式改进;新增可调思考时长与红acted推理块,反映对模型蒸馏的警惕;Anthropic估值近1万亿美元,算力来自Musk/Google/NVIDIA/Microsoft等。
入选理由:Opus 4.8支持用户自定义思考时长(原仅自适应模式),并引入更多红acted推理块以防止技能蒸馏
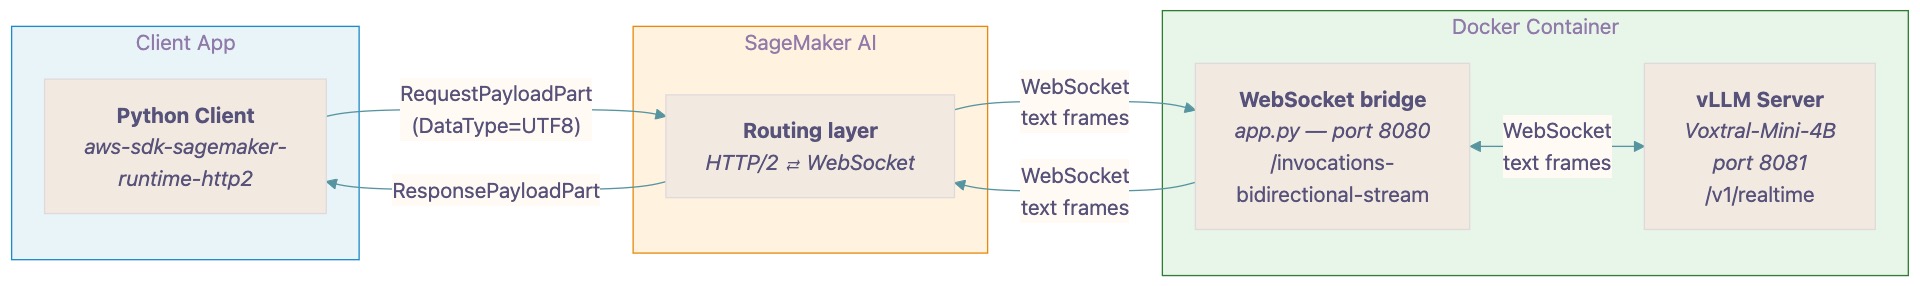
AWS推出SageMaker AI与vLLM结合方案,实现双向流式语音转文本推理,支持实时语音助手、直播字幕等应用,显著降低延迟。
入选理由:SageMaker AI提供原生HTTP/2双向流式传输(端口8443),自动处理协议转换
AI代理系统的最优组织结构取决于任务复杂度与模型类型,Google研究通过150+实验发现:集中式或混合架构对OpenAI模型更有效,而Google模型在去中心化协作中表现更优。
入选理由:超过150次实验证明,OpenAI模型在集中式管理架构下性能提升37%,优于去中心化模式。
vLLM从V0到V1的升级聚焦推理后端正确性,修复了logprob语义、运行时默认值和飞行中权重更新等关键问题,确保强化学习训练中的结果可靠。
入选理由:vLLM V1优先解决推理后端的正确性问题,而非直接优化性能。
Google MaxText 新增单机 TPU 上的监督微调(SFT)和强化学习(RL)支持,集成 Tunix 和 vLLM,简化 LLM 后训练流程。
入选理由:MaxText 现支持在单机 TPU(如 v5p-8)上运行 SFT 和 RL,降低后训练门槛。
无需订阅,本地免费运行AI模型,LM Studio教程展示如何在Mac、Windows和Linux上安装并选择适合硬件的模型。
入选理由:LM Studio支持Mac、Windows和Linux,安装简单。
系统提示中的时间戳和推理努力变化会影响缓存,优化提示可提升代码代理性能。
入选理由:系统提示中添加时间戳会破坏缓存机制,导致性能下降
长周期智能体工作负载需要优化模型推理效率,Together AI 和 Ollama 提出通过前缀缓存减少重复计算。
入选理由:智能体每次请求都需发送完整对话历史,导致推理效率下降。
本地小型LLM在处理教科书内容时表现良好,但在处理最新研究论文时几乎失效,表明模型对新内容的适应能力不足。
入选理由:本地小型LLM在处理教科书内容时得分12到20分(满分20),但在处理最新研究论文时得分降至0到9分(满分15)。
Qdrant 1.20.1 版本显著提升了性能,包括减少 50% 的读取量和加速量化过程。
入选理由:HNSW 图搜索在冷存储中减少了 50% 的读取量。
权重仅量化技术通过减少模型权重的存储和计算需求,显著提升推理效率,尤其适用于Transformer模型。
入选理由:权重仅量化可将FP16权重存储减少一半,例如INT8权重。
Llama.cpp v1.0.0 发布,强调开源与去中心化,推动 AI 技术普及与多平台支持。
入选理由:Llama.cpp v1.0.0 已发布,为 AI 应用开发提供稳定基础。
操作融合与快速注意力内核可提升Transformer推理性能,vLLM和CUDA图是关键实现手段。
入选理由:操作融合可减少30%以上的内核启动次数和内存流量
Inkling 2 Small模型在Ollama上线,具备594B参数和1M上下文窗口,适用于视觉和金融推理任务。
入选理由:Inkling 2 Small是594B参数的混合专家模型,支持1M上下文窗口。
ollama发布594B参数的Mixture-of-Experts模型,支持图像输入和1M上下文,专为代理编码和知识工作设计。
入选理由:inkling-2-small模型参数量达594B,采用17B激活专家架构
美团开源LongCat-2.5,参数达1.6万亿,支持长程任务与国产算力适配,采用W4A4量化方案降低推理成本。
入选理由:LongCat-2.5参数量达1.6万亿,每个token激活约480亿参数,支持百万上下文长度。
开发者体验与AI代理体验存在本质差异,Scope基准测试为数据库产品选型提供量化评估标准。
入选理由:Scope基准测试已验证18个托管数据库的代理适配能力
Moonshot AI发布Kimi K3.1 Pro,支持104万token上下文窗口,MoE架构含2.8T参数,在代码生成等基准测试中超越竞品模型。
入选理由:Kimi K3.1 Pro采用MoE架构,总参数2.8T,激活参数104B,支持1048576 token上下文窗口
斯坦福AI实验室提出Joules-to-GDP(J2G)框架,量化AI计算的能源经济价值。
入选理由:J2G框架通过任务/模型/硬件三维度评估AI能源效率
Weaviate 1.40版本发布,新增删除向量和4位旋转量化功能,显著提升存储效率与查询性能。
入选理由:删除命名向量功能可释放磁盘和索引内存,通过API调用实现。
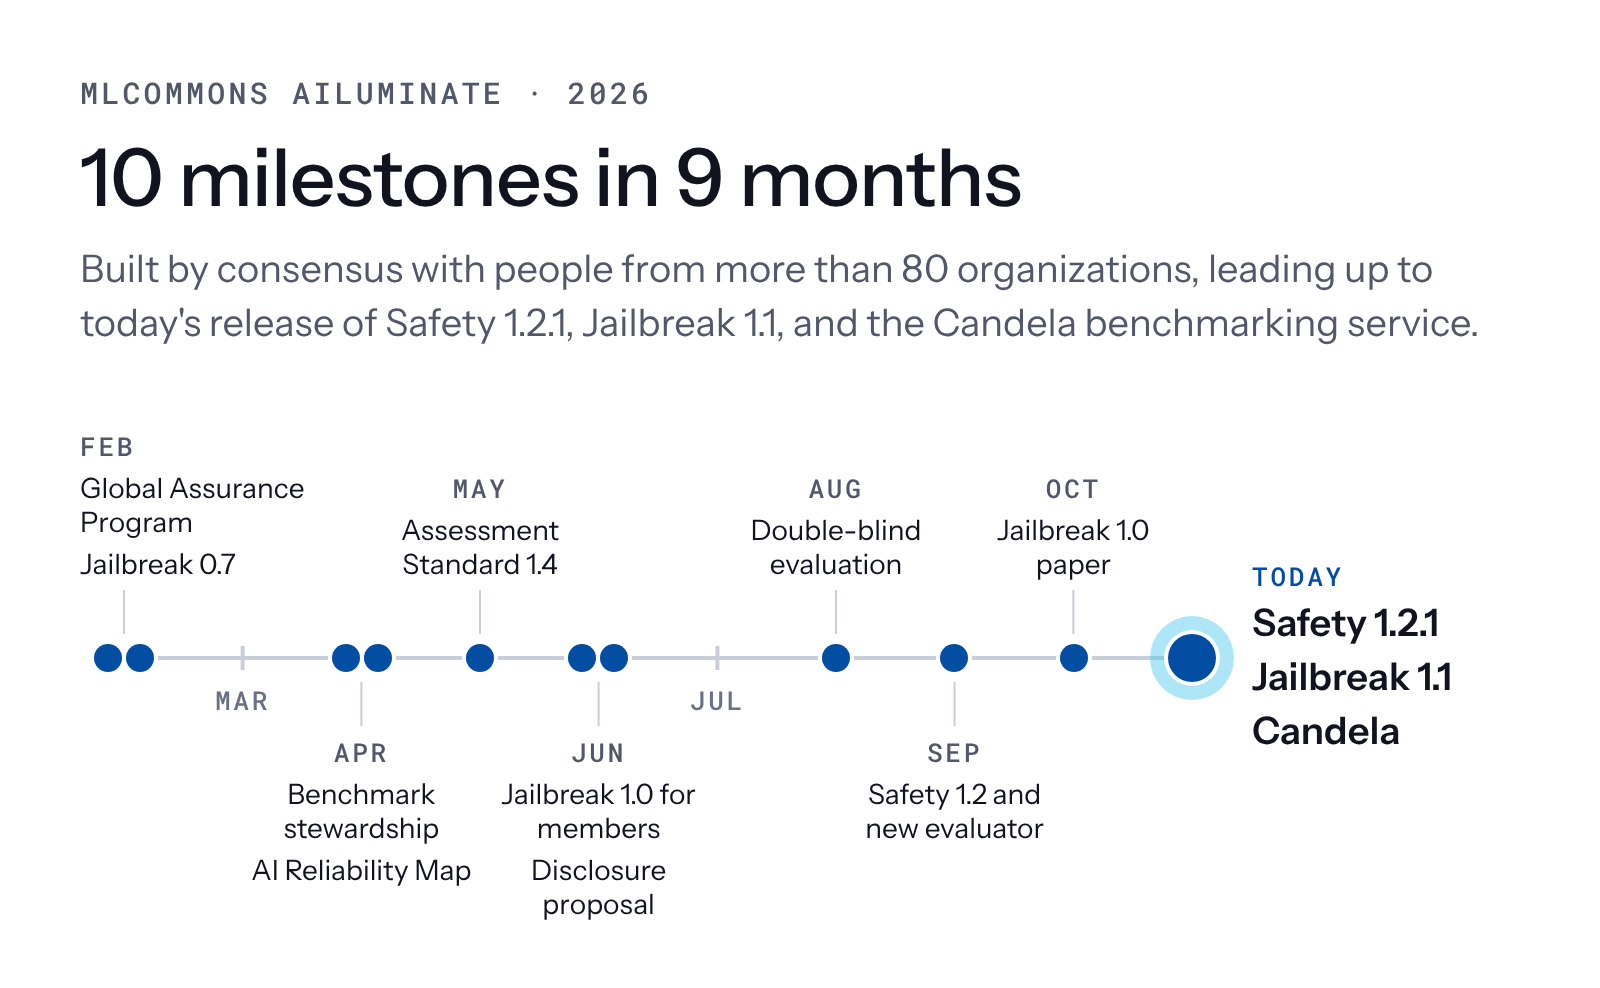
MLCommons发布AILuminate Safety 1.2.1和Jailbreak 1.1基准,提供AI系统安全性和抗攻击能力的量化评估,27个系统测试结果公开。
入选理由:AILuminate Safety 1.2.1新增自定义评估器和百分位数评分机制