Unity Catalog 的自动治理功能现已一般可用
Databricks1803 字 (约 8 分钟)
90
Databricks 在 Unity Catalog 中推出了 ABAC 行过滤和列屏蔽策略、治理标签和自动数据分类功能,实现了动态的数据保护和治理。
入选理由:Databricks 推出了 ABAC 策略,实现了一次定义多次应用的数据访问控制。
精选文章#Unity Catalog#ABAC#数据治理#自动化分类中英混合
产品
别名:UC
Databricks统一数据目录服务
已跟踪 30 条高相关材料
最近变化
2026-11-17 · Azure Government Beta版集成Unity Catalog与无服务器计算,支持US Gov Virginia/Azure Arizona数据驻留
为什么值得关注
Unity Catalog 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
ABAC row filtering and column masking policies, governed tags, and data classification are now generally available in Unity Catalog
Databricks · 9 分
Databricks 在 Unity Catalog 中推出了 ABAC 行过滤和列屏蔽策略、治理标签和自动数据分类功能,实现了动态的数据保护和治理。
Scaling Enterprise Conversational Intelligence: Cross-industry Technology and Functional Solutions Powered by Databricks Genie
Databricks · 8.7 分
Databricks Genie通过统一、受治理的自然语言交互,将跨行业与功能型企业智能落地到财务、法务、IT等通用场景,显著缩短洞察获取周期并加速决策。
Observability for any agent, anywhere: Production-ready tracing with OpenTelemetry & Unity Catalog on Databricks
Databricks · 8.7 分
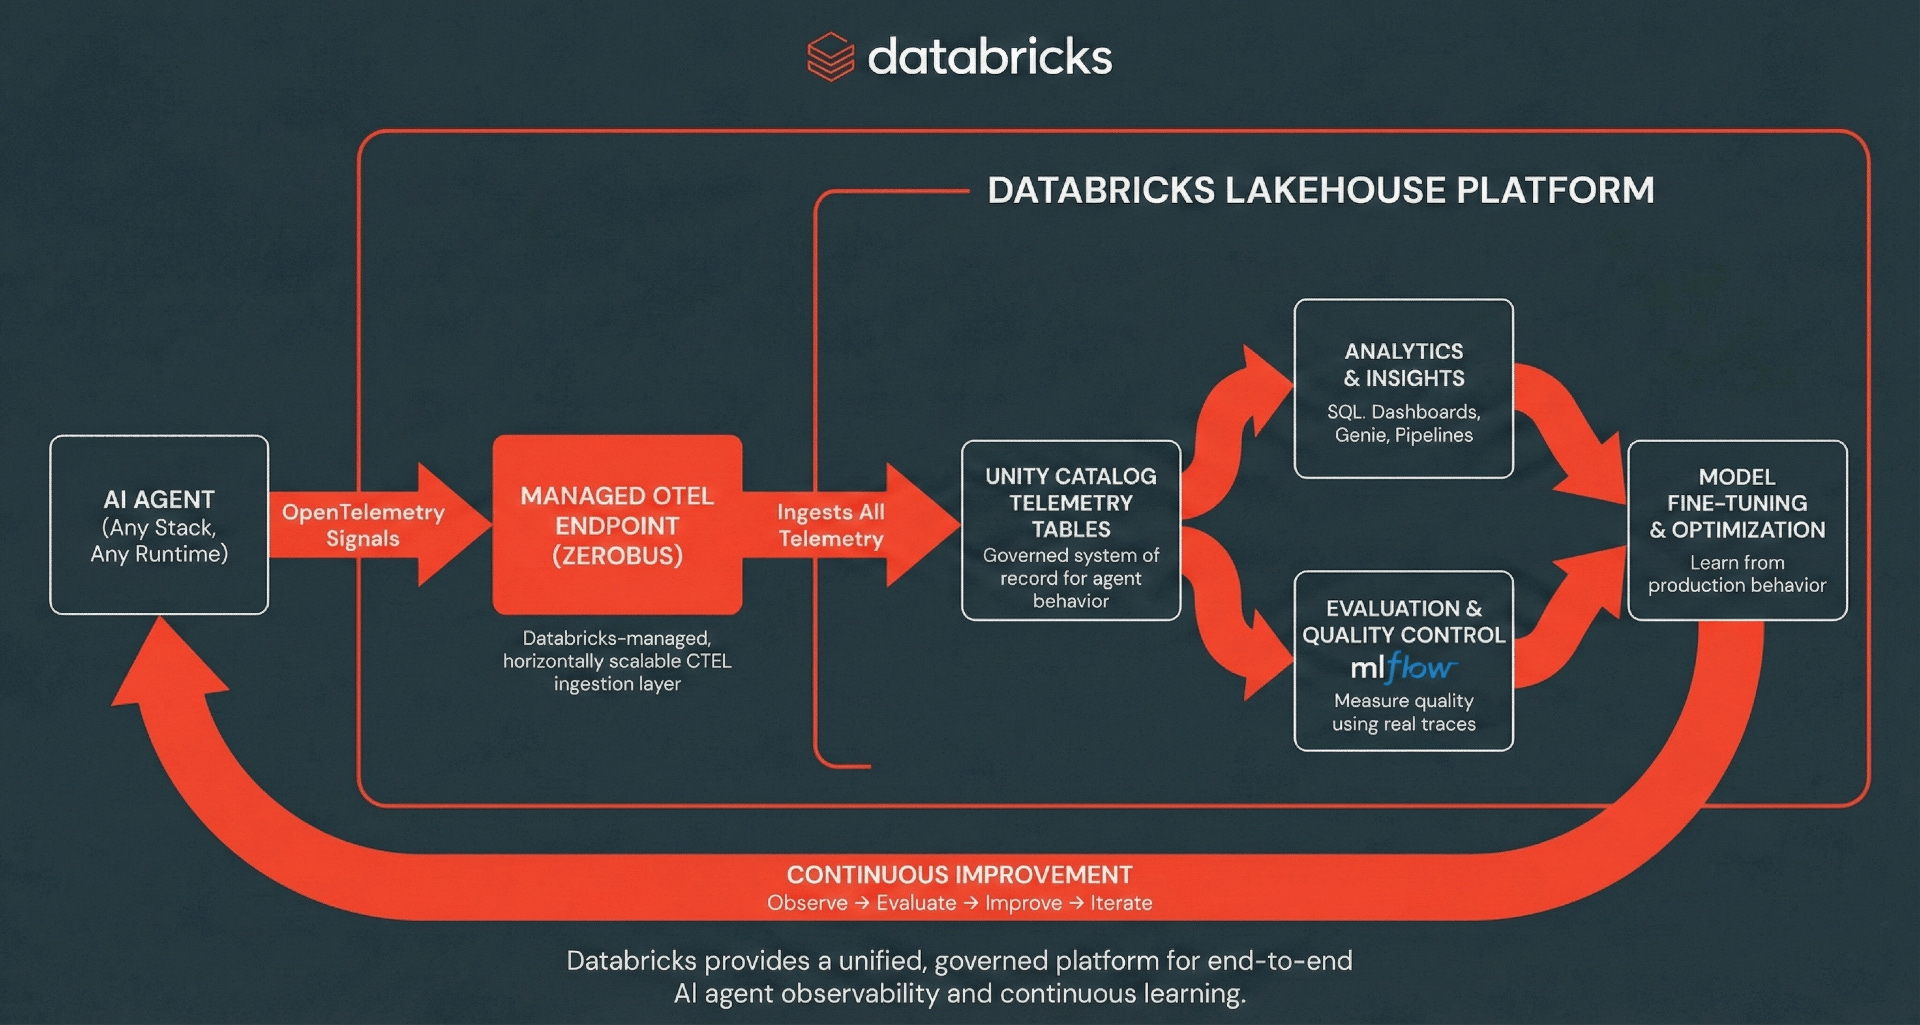
Databricks 推出基于 Unity Catalog 和 OpenTelemetry 的生产级 AI Agent 可观测性方案,将 traces 以 Delta 表形式统一存储于 Lakehouse,实现低成本长期保留、SQL 分析、PII 治理与 MLflow 评估闭环...
已收录 30 条与 Unity Catalog 相关的内容,按评分排序。
Databricks 在 Unity Catalog 中推出了 ABAC 行过滤和列屏蔽策略、治理标签和自动数据分类功能,实现了动态的数据保护和治理。
入选理由:Databricks 推出了 ABAC 策略,实现了一次定义多次应用的数据访问控制。
Databricks Genie通过自然语言民主化数据访问,将跨行业与通用功能型企业智能落地到财务、法务、IT等场景,显著缩短洞察获取周期并加速决策。
入选理由:AI4BI Command Center提供决策者统一、受治理的智能界面,含上下文洞察、主动预警与what-if能力,提升决策效率30%+。
Databricks 推出基于 Unity Catalog 和 OpenTelemetry 的 AI Agent 可观测性方案,将 traces 以 Delta 表形式统一存储于 Lakehouse,实现低成本长期保留、SQL 分析、PII 治理与 MLflow 评估闭环。
入选理由:Databricks 支持通过 OTLP/gRPC 将 OpenTelemetry traces 实时写入 Unity Catalog Delta 表,实现零基础设施开销的 serverless ingestion。
Databricks 用 MemAlign 框架优化 Genie Code 生成的 ML 代码评估,通过 LLM 判官实现 9 维度自动化评分,显著缩小与人类专家的差距。
入选理由:MemAlign 使 LLM 判官评分与人类专家一致性提升至 0.85 相关系数。
Azure Databricks政府版Beta发布,提供与商业版相同的数据AI平台能力,满足政府机构数据治理与合规需求。
入选理由:Azure Government Beta版集成Unity Catalog与无服务器计算,支持US Gov Virginia/Azure Arizona数据驻留
Databricks首席解决方案架构师分享如何用Apache Spark与Unity Catalog重构金融风控体系,实现风险建模效率提升百倍。
入选理由:Apache Spark与Unity Catalog组合使复杂风控建模效率提升100倍
本文提供扩展Databricks应用的四阶段指南,涵盖性能目标设定、缓存策略、负载测试及实例优化,确保应用在高负载下保持响应和可靠性。
入选理由:设定p95延迟和峰值用户数是扩展Databricks应用的基础
Databricks通过Zerobus Ingest和Debezium实现无需Kafka的CDC推送,简化数据复制流程。
入选理由:Zerobus Ingest 3.7版本支持直接推送CDC到Delta表,无需Kafka中间件
Databricks MLflow现在支持Claude平台的原生OpenTelemetry可观测性,便于统一调试和分析。
入选理由:Databricks MLflow支持Claude平台原生OpenTelemetry导出,可存储在Unity Catalog中
Databricks推出Lakebase Postgres,该全托管无服务器数据库已在Google Cloud正式发布,通过统一存储层和智能扩展能力降低运维成本。
入选理由:Lakebase Postgres支持自动扩展和零复制分支,可降低30%基础设施成本
Lakeflow Connect通过预置连接器统一生产力工具和AI数据,无需自定义API,直接整合到Databricks平台。
入选理由:Lakeflow Connect支持Jira、Confluence、GitHub等15+工具的原生连接,无需自定义API开发
Databricks的湖仓一体架构在开放性、统一平台和成本效益上全面优于Oracle传统数据仓库,尤其适合AI时代需求。
入选理由:Databricks采用Delta Lake和Iceberg开放格式,避免数据锁定,Oracle依赖专有格式。
在Databricks上运行dbt时,采用增量策略和原生编排可显著降低成本并提升性能。
入选理由:使用replace_where策略可减少30%以上的重复计算开销
Unity Catalog通过支持Apache Iceberg REST catalog spec实现数据可移植性,允许在不同目录间移动表而无需复制数据。
入选理由:Unity Catalog支持Apache Iceberg的REGISTER和UNREGISTER操作,实现零数据复制迁移
Databricks AI研究团队通过AI Runtime实现大规模模型训练,提升8倍实验效率,集成MLflow和Unity Catalog优化GPU资源管理。
入选理由:AI Runtime支持从单GPU到数百GPU的弹性扩展,集成MLflow实现自动化实验
Databricks推出Funke,原生解析HL7v2医疗消息为Spark数据结构,无需FHIR转换或第三方工具。
入选理由:Funke使用Python/PySpark重写,集成Unity Catalog和Spark Declarative Pipelines
Databricks推出Workday Data Connect联邦连接器,实现零拷贝访问Workday数据并集成到Unity Catalog中。
入选理由:零拷贝访问:通过Workday Data Connect连接器,Unity Catalog可直接读取Workday的Iceberg表,无需数据复制。
Databricks推出OBO授权机制,使应用能基于用户权限安全访问数据,无需重新实现数据治理规则。
入选理由:OBO授权结合应用授权,通过API作用域限制操作范围(如sql:restricted-query)
Databricks的Unity Catalog管理表允许用户在自有云存储中控制数据位置,支持Iceberg和Delta格式,并通过开放API实现数据治理。
入选理由:Unity Catalog管理表数据存储在用户拥有的S3/ADLS/GCS等云存储中
Databricks推出的Omnigent和Nimble工具通过统一代理定义和优化搜索,提升效率并降低成本。
入选理由:Omnigent允许一次定义代理,跨多个环境运行,减少重复工作
数据治理不仅是安全控制,更是构建AI基础的关键,通过知识、上下文和本体论实现更高效、可信的AI模型。
入选理由:数据治理的五个支柱(数据、AI、人员、产品、上下文)是构建AI基础的关键。
加拿大货运铁路公司利用Databricks Genie Code将数据管道创建时间从天缩短至分钟,实现90%自动化。
入选理由:Genie Code结合Unity Catalog实现90%的新表摄入自动化
Databricks通过事件驱动预计算和快照服务,将网络配置延迟降低97.5%,实现99.99%可用性。
入选理由:事件驱动架构使RPC p99延迟从5000ms降至125ms
Databricks推出新流程,通过AWS IAM临时委托简化S3连接,提升安全性与效率。
入选理由:新流程将S3连接步骤从140行IAM策略简化为几点击操作
FDA通过整合数据平台和AI工具,实现85%员工日常使用AI系统,将监管研究时间从数天缩短至3分钟。
入选理由:FDA整合8个中心数据至Databricks平台,数据共享时间从4-5天缩短至实时
数据原生AI代理通过将模型与数据平台集成,解决外部代理导致的治理漏洞、性能损耗和成本问题,成为企业AI架构新方向。
入选理由:外部代理导致治理漏洞、多跳延迟和成本碎片化,企业需承担隐藏的扩展税
Databricks推出Feature Views,通过统一定义特征逻辑消除训练/服务偏差,实现高效实时推理。
入选理由:Feature Views通过单一定义消除训练/服务偏差,提升模型性能。
从Azure Synapse迁移到Databricks Lakehouse可简化架构、提升性能并降低成本。
入选理由:Databricks统一平台减少30%治理成本(基于客户案例)
Barracuda通过Databricks Genie实现自然语言日志搜索,使安全分析效率提升并保障多租户数据隔离。
入选理由:Genie将日志查询从SQL转换为自然语言,查询结果秒级返回
AVL 使用 Databricks 的 Impulse 框架,将测量数据分析从传统工具迁移到湖仓一体架构,显著提升效率并实现数据治理。
入选理由:Impulse 通过 Python 表达式实现时间序列分析,无需 Spark 专业知识。