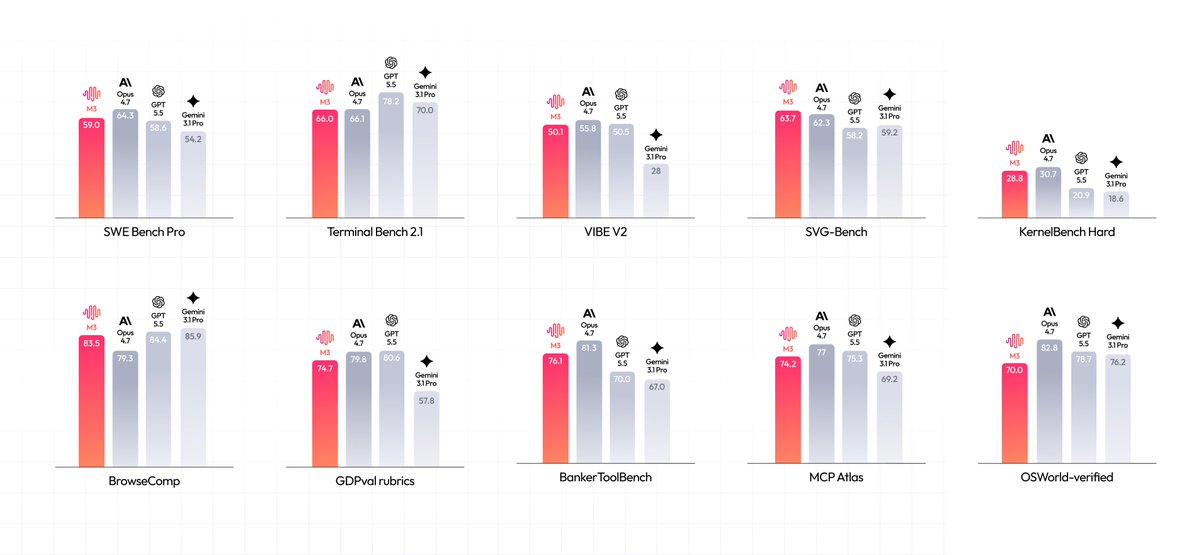
MiniMax-M3 登陆 OpenRouter!
MiniMax-M3 已上线 OpenRouter,是一款支持100万token上下文、前沿编码与代理性能、原生多模态(图像/视频)的开源模型,标志着大模型能力向长文本、多模态和自主执行方向的重要突破。
入选理由:MiniMax-M3 支持1M-token上下文窗口,显著超越主流模型如GPT-4o的32K限制。
公司
别名:OpenRouterAI
AI模型服务平台
已跟踪 30 条高相关材料
最近变化
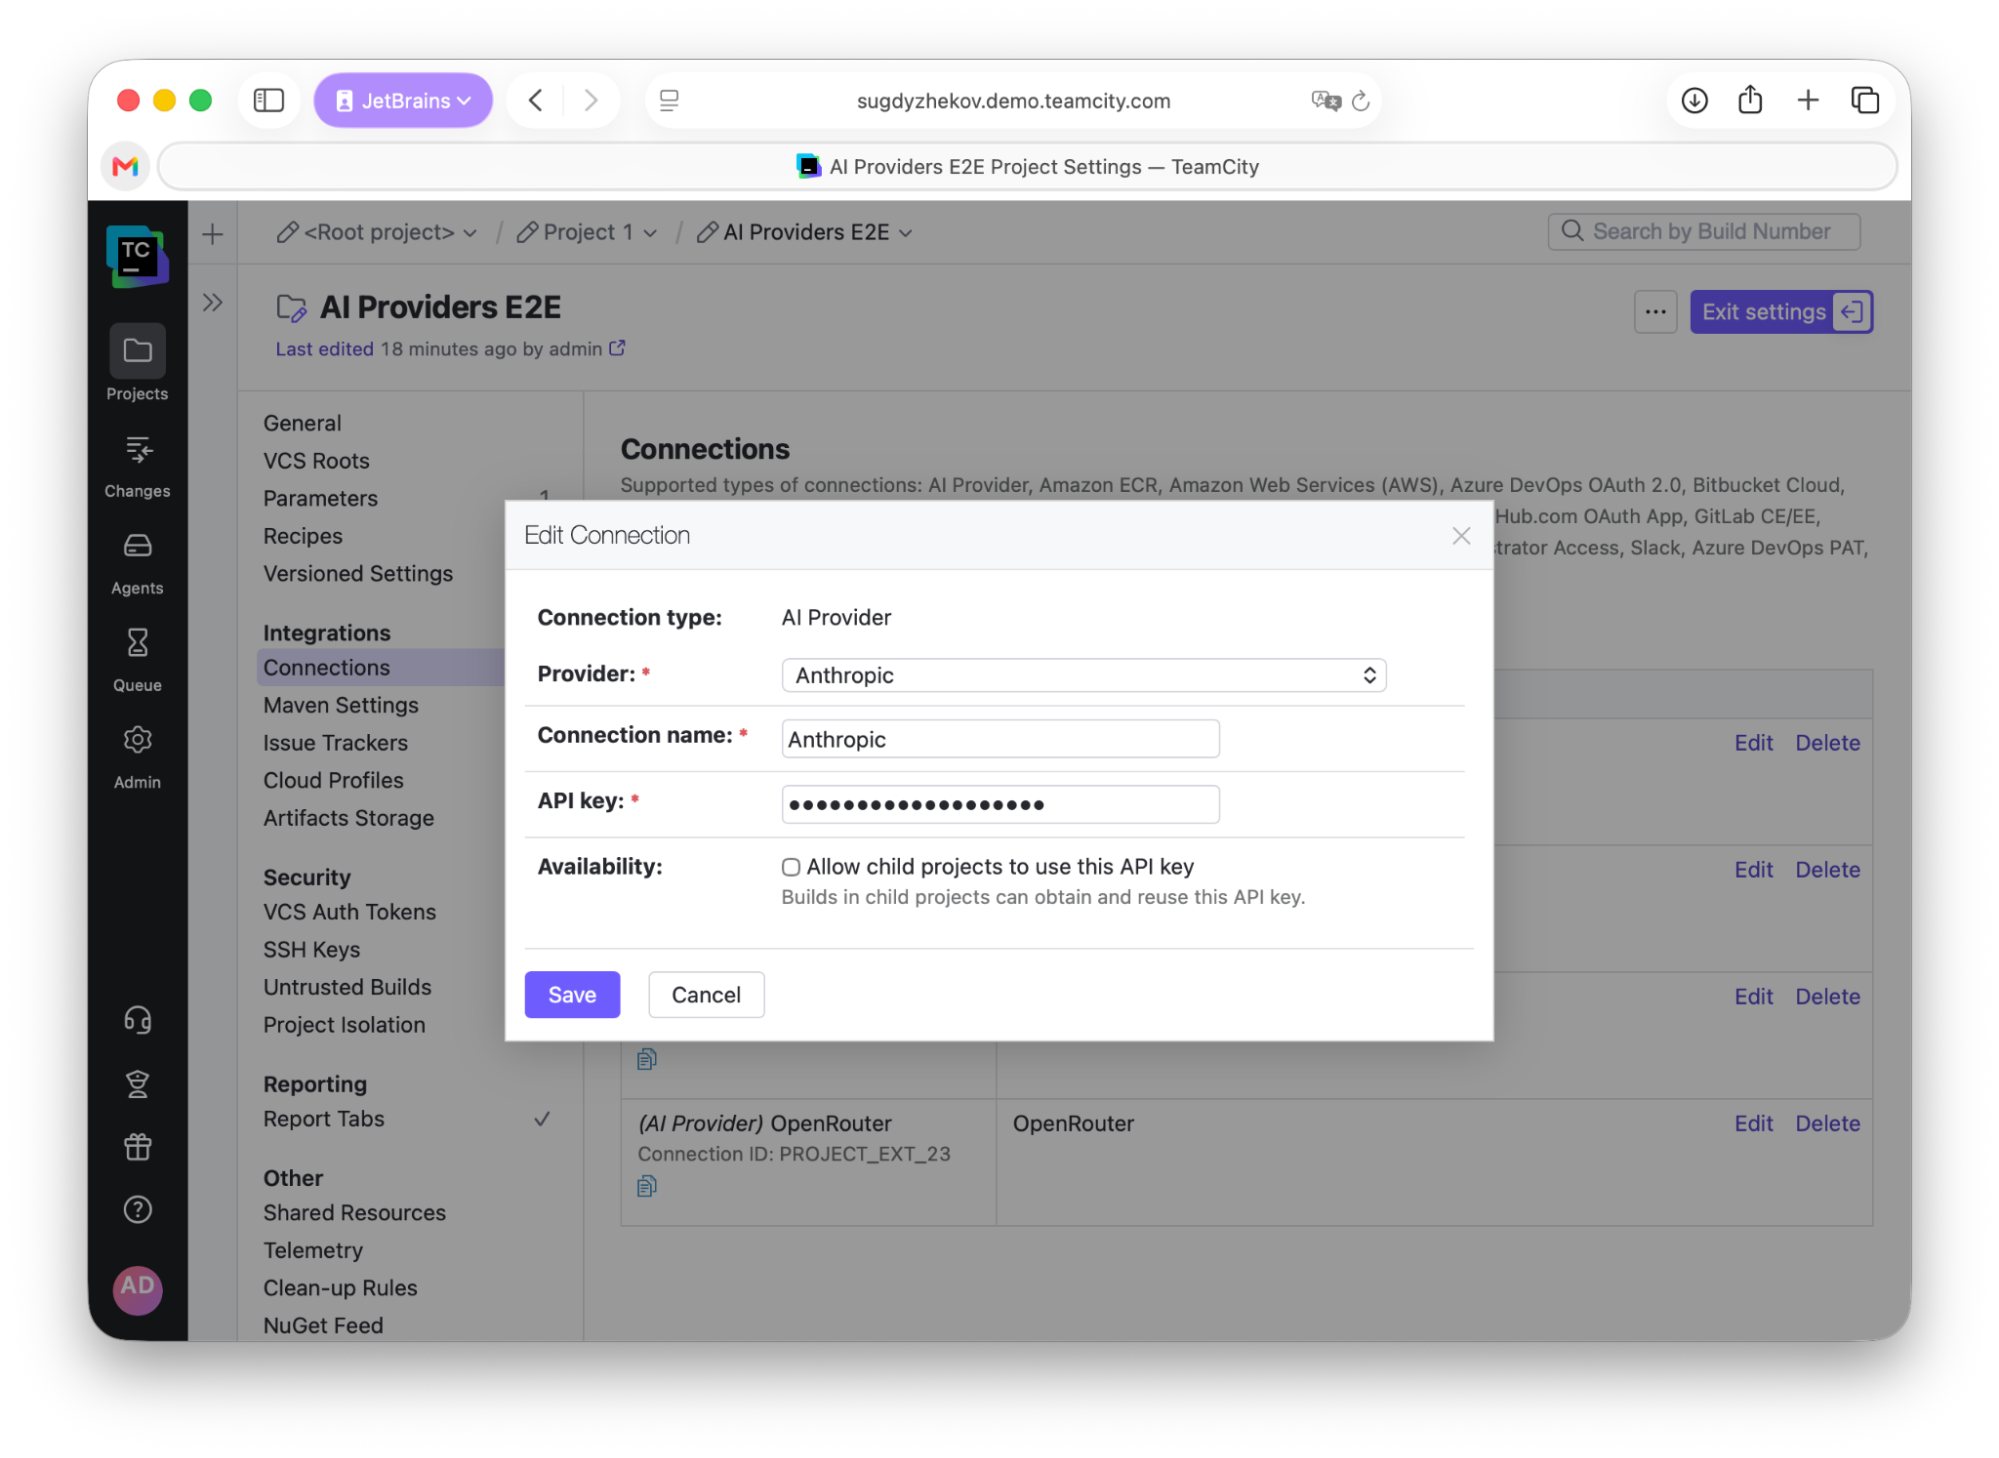
2026-11-16 · TeamCity 新增 AI Agents 插件,支持 Codex 和 Claude Code 直接在构建流程中运行。
为什么值得关注
OpenRouter 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
MiniMax-M3 is live on OpenRouter! A frontier-class open-weight model that combines a 1M-token conte...
OpenRouter(@OpenRouterAI) · 8.7 分
MiniMax-M3 已上线 OpenRouter,是一款支持100万token上下文、前沿编码与代理性能、原生多模态(图像/视频)的开源模型,标志着大模型能力向长文本、多模态和自主执行方向的重要突破。
Run AI Agents in TeamCity
The JetBrains Blog · 8.5 分
TeamCity 现支持在 CI/CD 流程中运行 AI 代理,提升自动化代码审查和文档更新效率。
📈
Mustafa Suleyman(@mustafasuleyman) · 8.5 分
MAI Transcribe 2在OpenRouter上的请求量增长12倍,语音转文本领域整体增长3倍。
已收录 30 条与 OpenRouter 相关的内容,按评分排序。
MiniMax-M3 已上线 OpenRouter,是一款支持100万token上下文、前沿编码与代理性能、原生多模态(图像/视频)的开源模型,标志着大模型能力向长文本、多模态和自主执行方向的重要突破。
入选理由:MiniMax-M3 支持1M-token上下文窗口,显著超越主流模型如GPT-4o的32K限制。
TeamCity 现支持在 CI/CD 流程中运行 AI 代理,提升自动化代码审查和文档更新效率。
入选理由:TeamCity 新增 AI Agents 插件,支持 Codex 和 Claude Code 直接在构建流程中运行。
MAI Transcribe 2在OpenRouter上的请求量增长12倍,语音转文本领域整体增长3倍。
入选理由:MAI Transcribe 2请求量从0.7M增至8.5M,增长12倍
Parallel Decisions模型在OpenRouter上线,提供比OpenAI GPT Luna快13倍、成本低16倍的网络基础决策服务,限时免费试用一周。
入选理由:Parallel Decisions模型在OpenRouter平台提供免费试用,限时7天
Claude Code在User-Agent请求头中泄露用户邮箱,导致隐私问题,用户要求彻底移除该功能。
入选理由:Claude Code通过User-Agent头泄露用户邮箱,导致大量诈骗邮件。
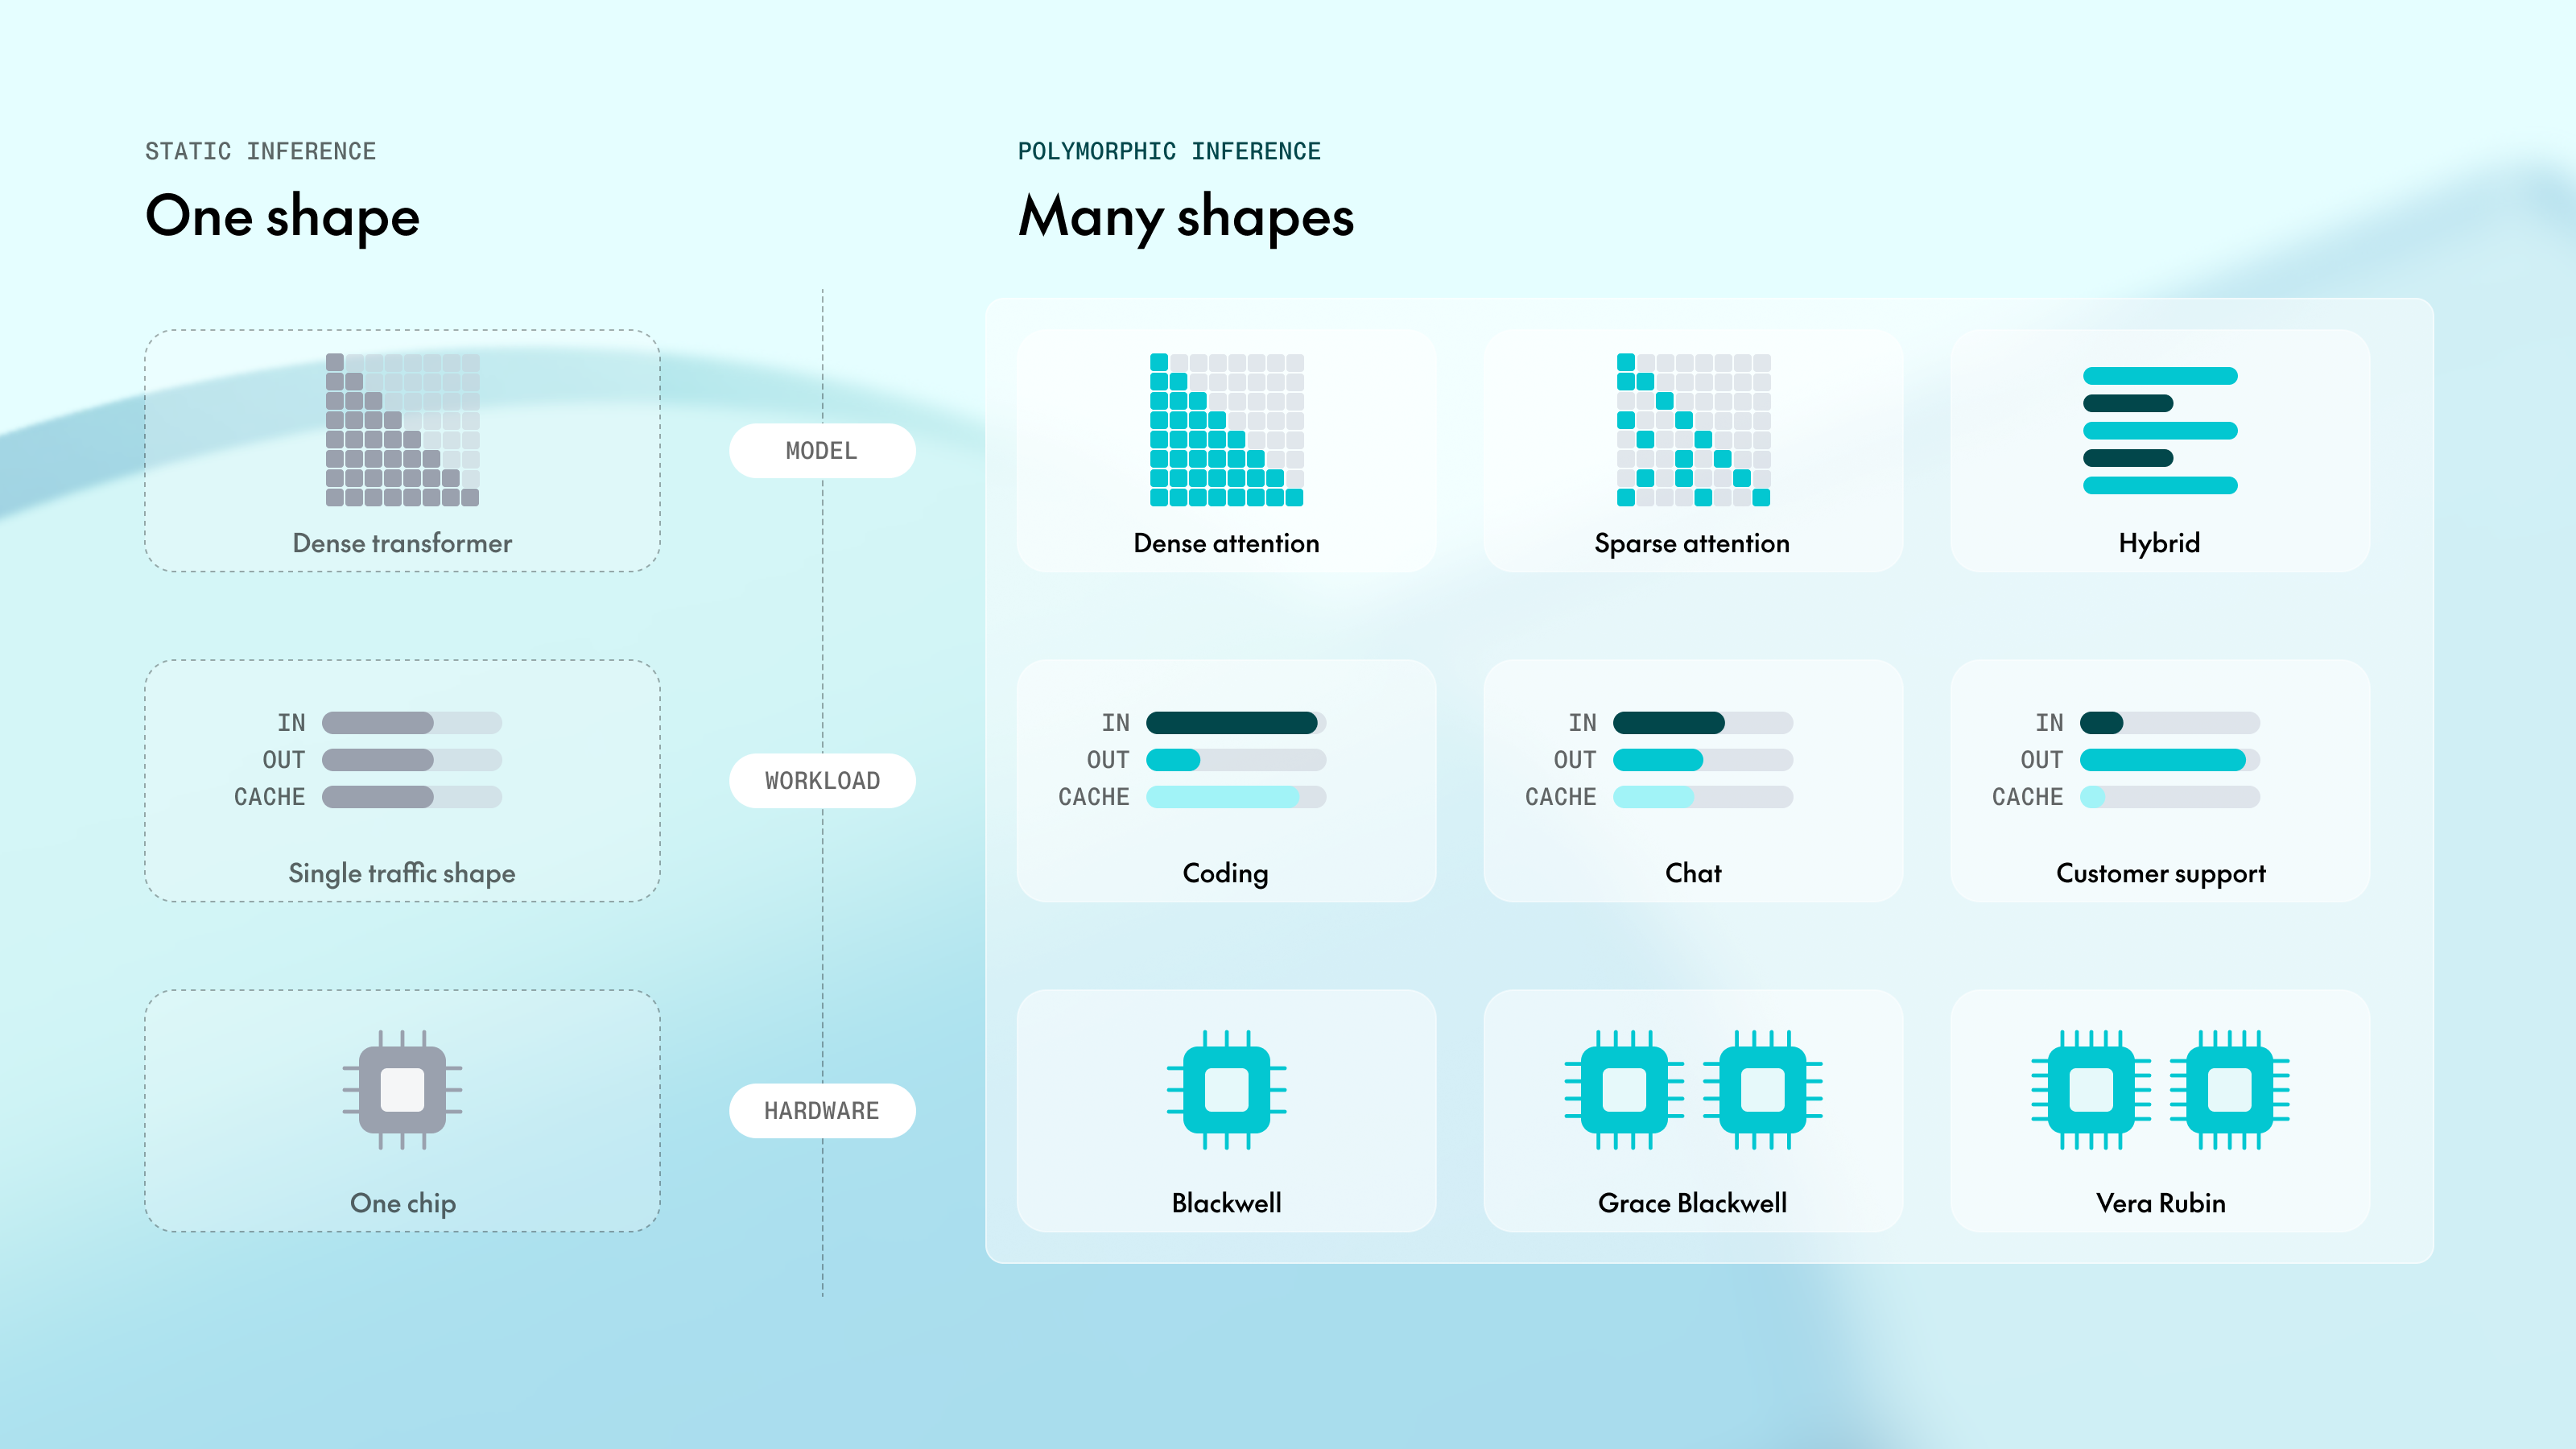
多态推理通过动态适应模型架构和硬件变化,解决开源模型爆炸式增长带来的部署挑战,Together AI提出持续编译技术实现自动优化。
入选理由:80%的OpenRouter流量来自近三个月发布的模型,凸显模型迭代速度挑战
Together Compiler(TKCC)通过持续编译优化AI推理,实现2.6倍TPS提升,适用于多模型、多硬件场景。
入选理由:TKCC在24小时内实现2.6倍TPS提升,覆盖Kimi K3等主流模型
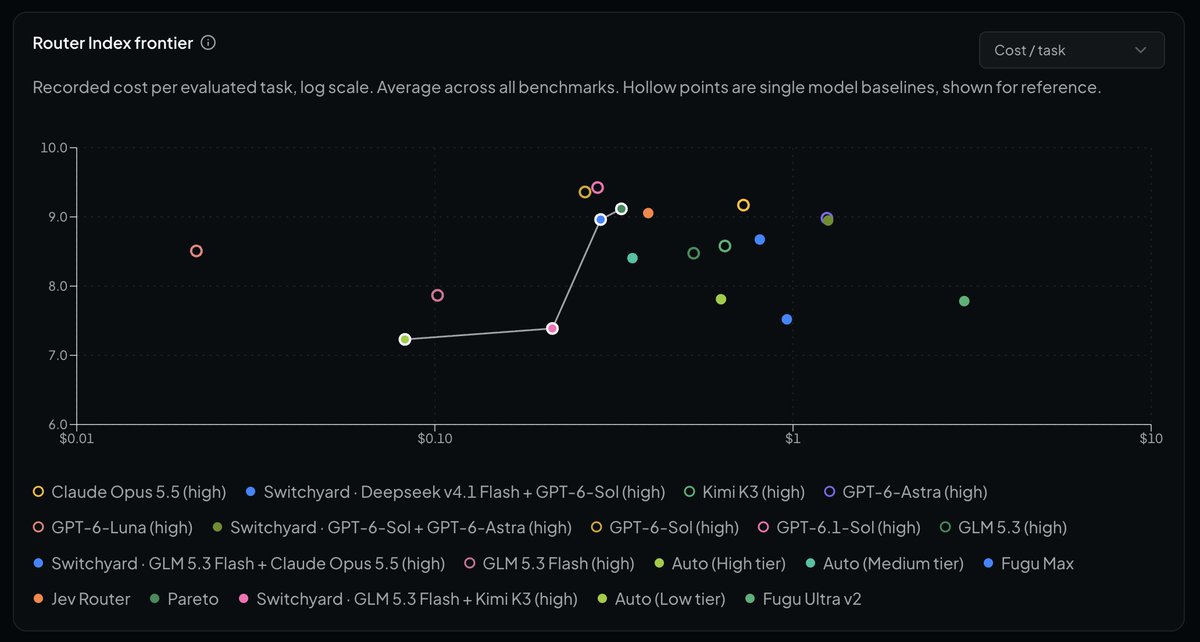
Memdoor项目通过五种Qwen3.8-27B模型协作,在编程问题解决上达到与Fable 5相当的水平,但成本显著高于单模型方案。
入选理由:五模型协作在LiveCodeBench Hard前10题中平均得分9.8,接近Fable 5的9.6
新型恶意软件Volta-Autodoxer利用AI自动收集受害者数据,通过OpenRouter分析生成结构化报告,由Cisco Talos发现。
入选理由:Volta-Autodoxer可窃取密码、OAuth令牌及Discord会话等敏感信息
Pi School 是一门免费、自定进度的开源课程,通过 Pi 本身教授如何使用 Pi Agent,强调模型无关和隐私优先的设计。
入选理由:课程分四阶段教学,从环境搭建到扩展能力,覆盖模型选择、上下文管理等核心实践。
通用模型可实时训练更小的领域特定模型,提升效率并降低安全风险,但存在潜在危害。
入选理由:通用模型能动态生成领域特定模型,减少计算成本30%以上
模型切换可能因缓存重建和延迟影响效率,基准测试可优化选择。
入选理由:模型切换需重建输入缓存,可能增加延迟
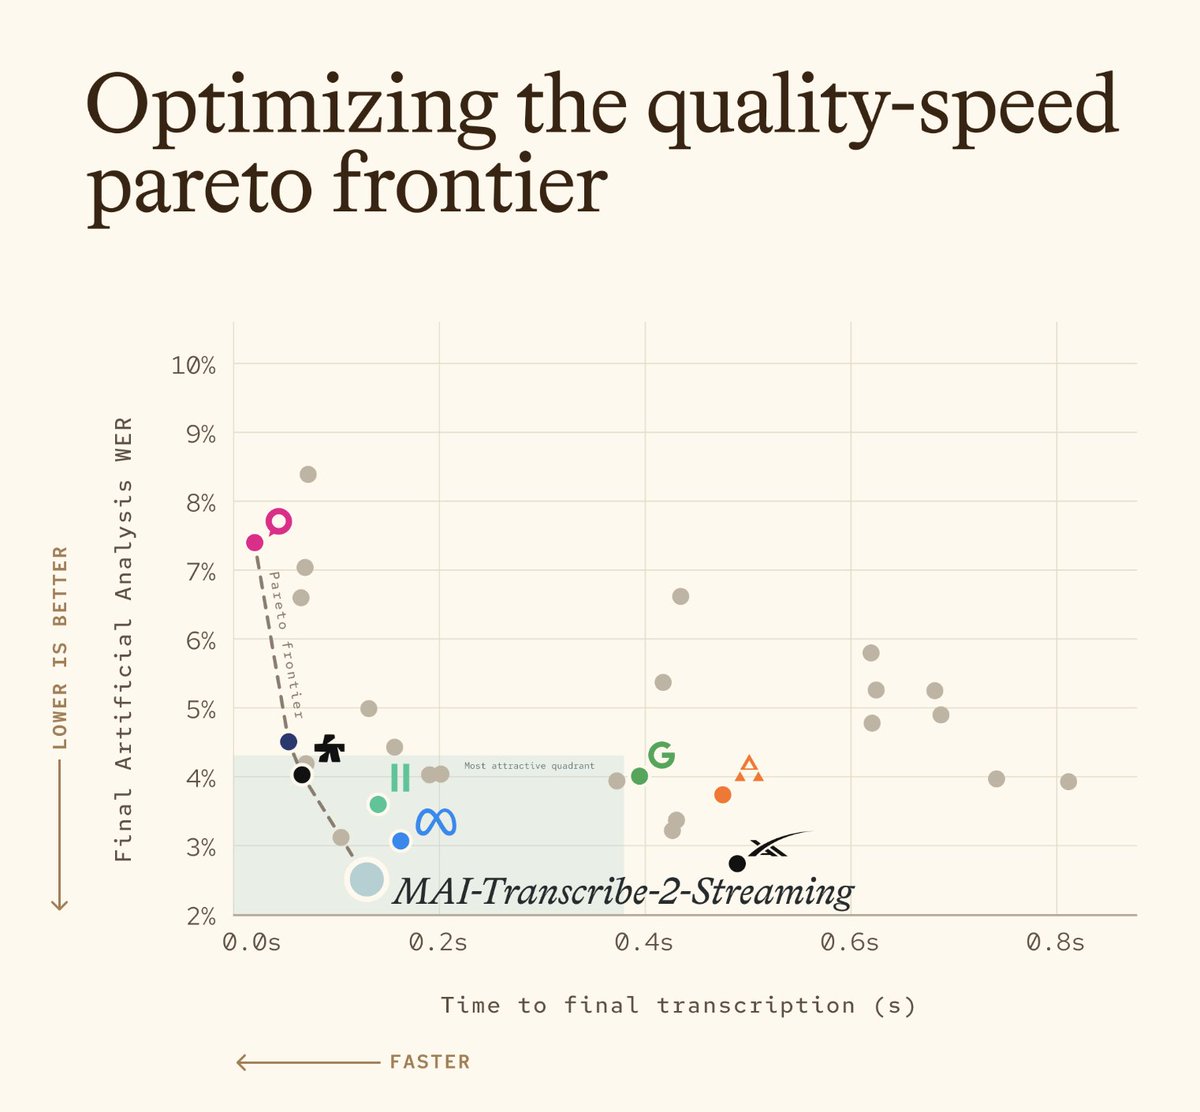
微软发布MAI-Transcribe-2-Streaming模型,实测较ElevenLabs快55%且成本降低60%,在AA-WER指标上达到2.5% WER。
入选理由:MAI-Transcribe-2-Streaming在AA-WER指标上实现2.5% WER,领先行业水平
OpenRouter推出Seedream 5.0 Flash模型,支持14张参考图像进行精确编辑,价格0.018美元/张且输出尺寸不影响价格。
入选理由:Seedream 5.0 Flash支持最多14张参考图像进行精确编辑
Google Cloud 推出 Agent Substrate,为 GKE 提供高密度、可扩展且安全的代理执行基础设施,支持每秒 500 次挂起/恢复操作。
入选理由:Agent Substrate 在 GKE 上实现 10 倍于标准容器运行时的密度提升
工程师可通过OpenCode、OpenAI Codex等工具免费使用先进编码模型,无需订阅或GPU资源。
入选理由:OpenCode Zen提供MiMo-V2.5等免费模型,支持终端操作
本文汇总了癌症疫苗、注意力免疫调节、通用机器人和路由器收购等跨领域进展,为工程师提供前沿动态参考。
入选理由:Merck-Moderna mRNA疫苗使黑色素瘤复发率降低44%(基于Phase III数据)
GPT 5.6 Terra和Luna在OpenRouter大幅折扣导致token使用量激增13.8倍,印证了Jevons悖论。
入选理由:OpenRouter上GPT 5.6 Terra和Luna价格折扣导致token使用量增长13.8倍
OpenRouter的折扣策略导致Luna、Terra和Sol的令牌使用量分别增长13.8倍、5.6倍和1.1倍,符合Jevons悖论。
入选理由:GPT 5.6折扣期间令牌使用量增长13.8倍,验证了Jevons悖论的经济学效应
腾讯推出Hy4模型,参数达770B,支持1M token上下文,推理模式仅high和no_think。
入选理由:Hy4模型总参数770B,活跃参数49B,上下文窗口达1M token
OLX Alpha模型具备100万亿token/day处理能力,可能改变AI行业格局,但其真实来源仍存争议。
入选理由:OLX Alpha支持100万上下文窗口和多模态输入,日处理能力达100万亿token。
中国开源模型在技术进展和企业应用上对美国形成显著优势,但存在国内限制。中美差距源于中国模型的快速迭代与美国开放权重模型的落后。
入选理由:GLM 5.2 是开放权重模型的重大突破,中国模型海外能力远超国内版本
Buzz平台支持多模型配置与免费API接入,Kimi K3表现优异,Juni AI代理在SWE-Bench测试中超越多数竞品。
入选理由:Kimi K3作为主力编码模型可显著提升开发效率
Inkling 是一个开放权重的 MoE 模型,支持多模态推理,参数规模达 975B。
入选理由:Inkling 模型拥有 975B 总参数和 41B 活跃参数,采用 MoE 架构。
腾讯Hy3模型在OpenRouter LLM排行榜登顶,295B MoE参数量,Apache 2.0开源,提供免费API。
入选理由:Hy3模型参数量达295B MoE,性能媲美万亿级旗舰模型
降低图像细节以节省成本的策略在视觉推理任务中可能适得其反,导致成本增加。
入选理由:将图像细节设为“低”导致模型消耗更多推理令牌,成本增加。
推理努力是影响成本的主要因素,限制推理努力可降低50-75%成本,而调整细节对准确性影响更大。
入选理由:限制推理努力可使成本下降50-75%,准确性仅变化1-2点
Milvus在Attu 3.0 beta中引入自带LLM方法,用户可自主控制LLM提供商和数据路径,无需依赖托管服务。
入选理由:Attu 3.0 beta支持OpenAI/Anthropic等5大LLM提供商的自定义接入
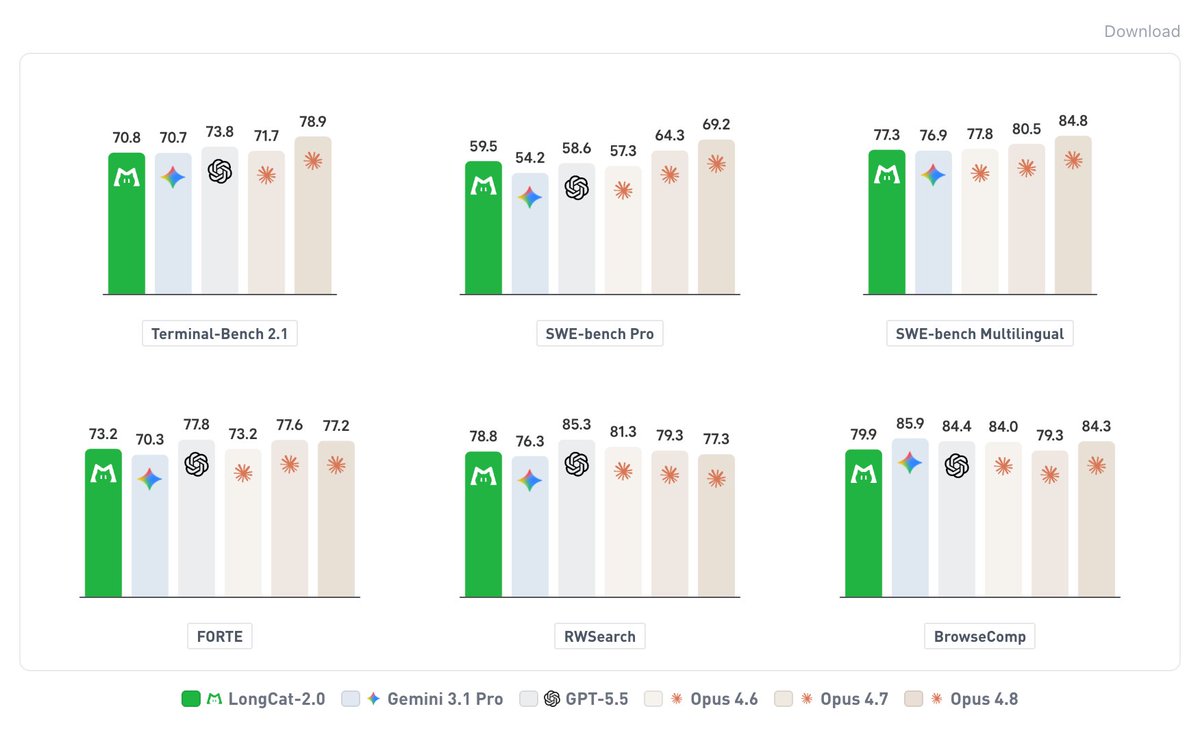
美团发布LongCat-2.0,采用1.6T参数MoE架构,支持1M上下文窗口,训练推理全程依赖国产加速卡。
入选理由:LongCat-2.0使用5-6万张中国国产加速卡训练,实现训推全链路国产化
GLM 5.2在代码审计和设计系统匹配任务中表现优异,成本仅为$3.36,适合替代Claude Code。
入选理由:GLM 5.2在代码审计任务中表现优异,成本仅为$3.36。