企业文档智能:从最小到语料库规模逐砖构建RAG系列
Towards Data Science5486 字 (约 22 分钟)
92
企业级RAG系统应聚焦文档理解与业务逻辑,而非堆叠模型和框架。简单的Python脚本往往比复杂生产系统更有效。
入选理由:多数企业RAG部署效果不佳,因基础解析和检索质量差。
精选文章#RAG#企业AI#文档智能#检索增强生成#LLM应用英文
概念
别名:large language model
大型语言模型
已跟踪 30 条高相关材料
最近变化
2026-11-18 · Artex将攻击时间从数天缩短至数小时,提升攻击效率
为什么值得关注
LLM 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Enterprise Document Intelligence: A Series on Building RAG Brick by Brick, from Minimal to Corpus scale
Towards Data Science · 9.2 分
企业级RAG系统应聚焦文档理解与业务逻辑,而非堆叠模型和框架。简单的Python脚本往往比复杂生产系统更有效。
Coding agents are accelerating different types of software work to different degrees. When we archit...
Andrew Ng(@AndrewYNg) · 9.2 分
Andrew Ng 提出编码智能体对四类软件工作加速程度差异显著:前端 > 后端 > 基础设施 > 研究,并强调团队架构需据此设定合理预期。
From Regex to Vision Models: Which RAG Technique Fits Which Problem
Towards Data Science · 9 分
RAG 技术并非万能,应根据文档结构和问题控制程度选择合适方法:模板化文档用正则表达式,客服对话需 LLM 判断语调,工程图纸必须使用视觉模型。
已收录 30 条与 LLM 相关的内容,按评分排序。
企业级RAG系统应聚焦文档理解与业务逻辑,而非堆叠模型和框架。简单的Python脚本往往比复杂生产系统更有效。
入选理由:多数企业RAG部署效果不佳,因基础解析和检索质量差。
Andrew Ng 提出编码智能体对四类软件工作加速程度差异显著:前端 > 后端 > 基础设施 > 研究,并强调团队架构需据此设定合理预期。
入选理由:前端开发因框架熟稔与浏览器闭环迭代能力,获最大加速;视觉设计短板不影响功能实现速度。
RAG 技术并非万能,应根据文档结构和问题控制程度选择合适方法:模板化文档用正则表达式,客服对话需 LLM 判断语调,工程图纸必须使用视觉模型。
入选理由:模板化文档(如保险单、银行流水)适合用正则表达式提取字段,避免使用高成本的 RAG 流程。
企业数据治理不应依赖聊天机器人,关系型与时间序列数据正迎来专用基础模型的突破,KumoRFM-2在少标注下超越监督与通用基模,但高风险金融与医疗场景需谨慎验证与治理。
入选理由:KumoRFM-2仅用少量标注即可在多表关系数据上预测,超越监督基线与通用基模,显著降低数据科学管线复杂度。
企业部署AI智能体遇阻主因在数据整合质量而非模型能力升级,解决数据问题与组织流程重塑是成功关键。
入选理由:AI智能体部署失败中25%以上可归因于关键知识未实现系统化捕获与整理。
Proxy-Pointer RAG 通过保留文档结构上下文,将知识图谱实体与关系匹配的计算成本降低 90% 以上,实现高效、低延迟的图谱入管,解决了大规模知识图谱的语义蔓延问题。
入选理由:Proxy-Pointer RAG 使用 Skeleton Tree 和 Breadcrumb Injection 技术,使向量检索能精准定位文档完整结构段,而非碎片化块。
AutoTTS框架实现LLM自主搜索测试时扩展策略,仅用$39.9和160分钟即发现优于人工设计的控制器,在数学推理任务中达成更高精度-成本帕累托前沿。
入选理由:AutoTTS将测试时扩展策略搜索成本降至39.9美元和160分钟,显著低于传统人工调参。
MCP(模型上下文协议)由Anthropic于2024年12月提出,是统一AI与外部系统连接的标准化协议,显著降低集成复杂度。
入选理由:MCP由Anthropic在2024年12月提出,是用于标准化LLM与外部数据源连接的协议。
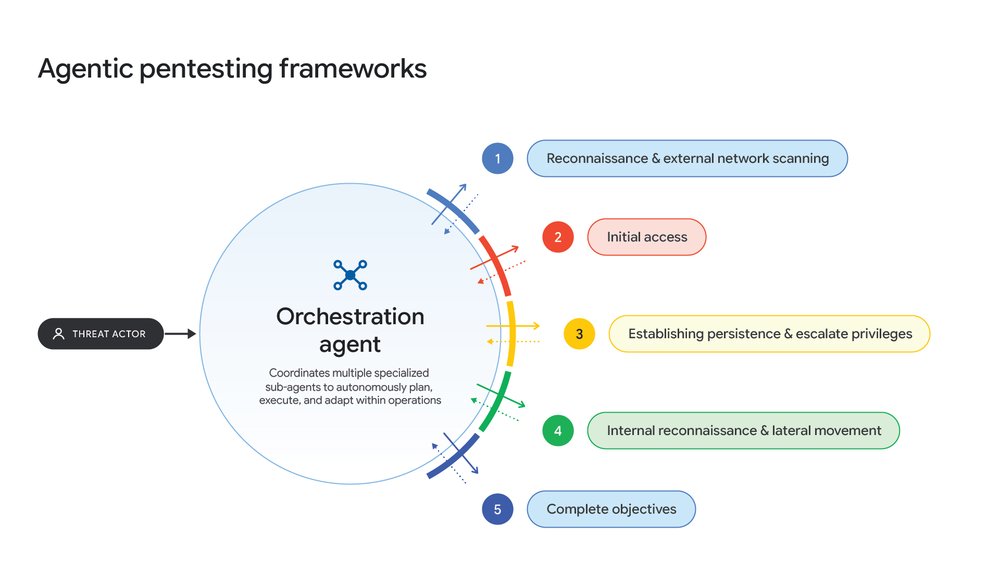
Artex作为AI驱动的渗透测试工具,使黑客能快速发起攻击,威胁企业与政府系统。
入选理由:Artex将攻击时间从数天缩短至数小时,提升攻击效率
AI代理可能被攻击者利用进行恶意活动,需通过权限检查、数据访问控制等措施防范风险。
入选理由:权限检查应在模型处理数据前实施,防止未授权访问。
构建高维输出基准需平衡粒度与人类偏好对齐,ParseBench-2和DPP通过细分维度和规则提升文档解析评估。
入选理由:ParseBench-2将文档解析拆解为6个维度330个场景,错误权重由人类定义(如数字错误扣10+分)
LangSmith注释队列通过人工审核校准LLM情感评分,解决自动化评估偏差问题,提升模型可靠性。
入选理由:人工审核发现20%的LLM评分与实际情感不符,需校准
小型语言模型在连续出现10次正面后,仍有高达82%的概率预测第11次为正面,表现出对赌徒谬误的偏差。
入选理由:小型语言模型在连续正面后仍倾向于预测正面,偏差高达82%。
恶意行为者正在利用生成式AI进行自主攻击,威胁情报显示攻击速度和规模显著提升。
入选理由:攻击者使用自主多代理框架(如ARTEX、CAIRN)加速攻击流程。
优秀的智能代理系统依赖大量确定性步骤,而非单纯依赖LLM代理。
入选理由:最佳的智能代理系统包含大量确定性步骤,而非仅依赖LLM代理。
ParseBench-2 是一个全面的文档解析基准框架,允许用户根据自身需求定义解析偏好并自定义评估指标。
入选理由:ParseBench-2 允许用户根据使用场景定义解析偏好,而非依赖单一的基准指标。
Netflix通过构建本体论驱动的知识图谱,将操作数据转化为AI驱动的可观测性,显著提升故障排查效率。
入选理由:知识图谱使应用回归调查时间从4小时缩短至分钟级
使用生成的术语表可提升LLM在特定领域的准确性,需结合组织内部数据并定期维护。
入选理由:利用内部文档/邮件/代码库生成领域术语表可提升LLM理解准确性
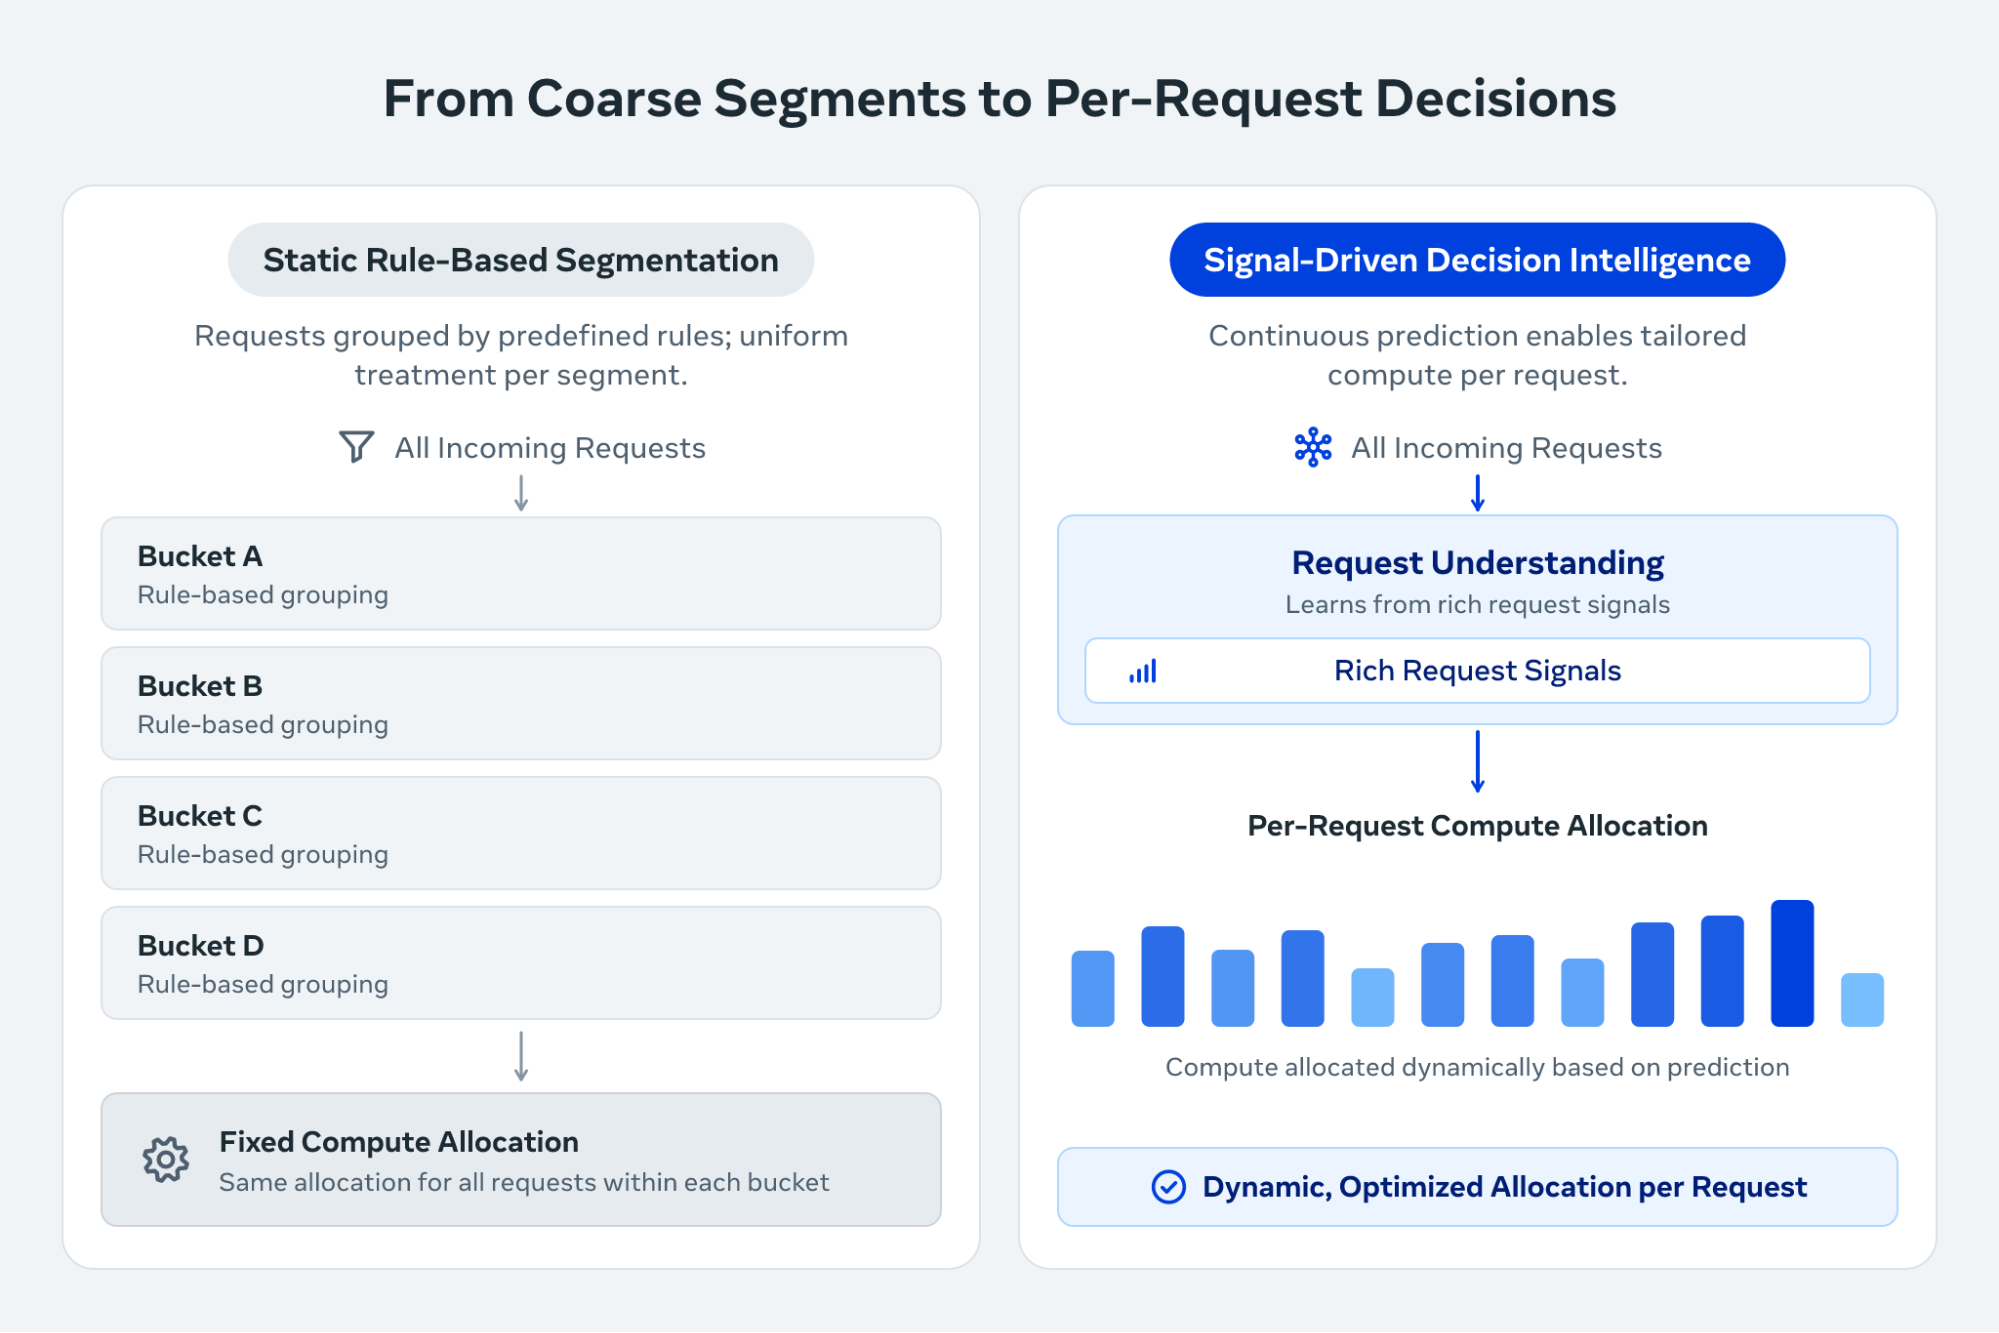
Meta的Intelligent Delivery系统通过机器学习优化计算资源分配,提升广告排名性能约10%。
入选理由:Intelligent Delivery系统自2017年以来提升广告排名性能约10%
LLM评估者在个性化写作任务中表现不稳定,配对比较优于独立评分,最强模型未必最可靠。
入选理由:LLM评估者与人类标注者一致性弱(Pearsonρ≤0.2)
AWS的Keto Specification Analyzer项目通过形式化方法检测规范中的矛盾,提升代码生成准确性。
入选理由:20-40%的模糊提示会导致LLM生成代码准确率下降
Milvus 3.0的StructArray技术通过单次查询获取匹配块及其上下文,提升RAG系统效率。
入选理由:StructArray将文档存储为单个实体,避免额外查询
企业构建AI系统需关注知识库自动化、Agent构建及AI工作流,LLM框架保持稳定。
入选理由:构建知识库需自动化循环:数据源-爬取-清洗-入库-反馈
过度依赖现成AI代理框架会限制LLM效率,自研定制化框架能提升灵活性和性能。
入选理由:自研框架可提升30%以上的定制化效率
Google提出Agile Deliberation框架,通过LLM驱动的交互式流程解决AI图像分类中的主观类别定义难题,实验显示可提升模型性能并减少用户认知负担。
入选理由:Agile Deliberation通过LLM优化循环减少用户疲劳,使模型性能超越标准基线32%
通过视频游戏数据训练机器人可解决现实问题,但需定制化模型而非依赖LLM。
入选理由:Medal平台记录了数万款游戏数据,作为机器人训练的'互联网'替代源
Netflix通过AI代理系统实现性能工程自动化,减少人工干预并提升系统优化效率。
入选理由:Netflix的自主性能代理系统可减少70%的性能问题排查时间
大语言模型通过直接读写神经网络权重实现自主训练,显著提升效率。该技术绕过传统Autoresearch流程,DeepSeek实验显示性能提升达50%。
入选理由:Weight Space Programming使模型自主训练效率提升50%
llm 0.37 版本新增多个模型,优化默认配置,并改进嵌入支持,提升开发者使用体验。
入选理由:新增 gpt-6.1-sol 和 gpt-6.1-terra 模型,支持 OpenAI 兼容端点配置。
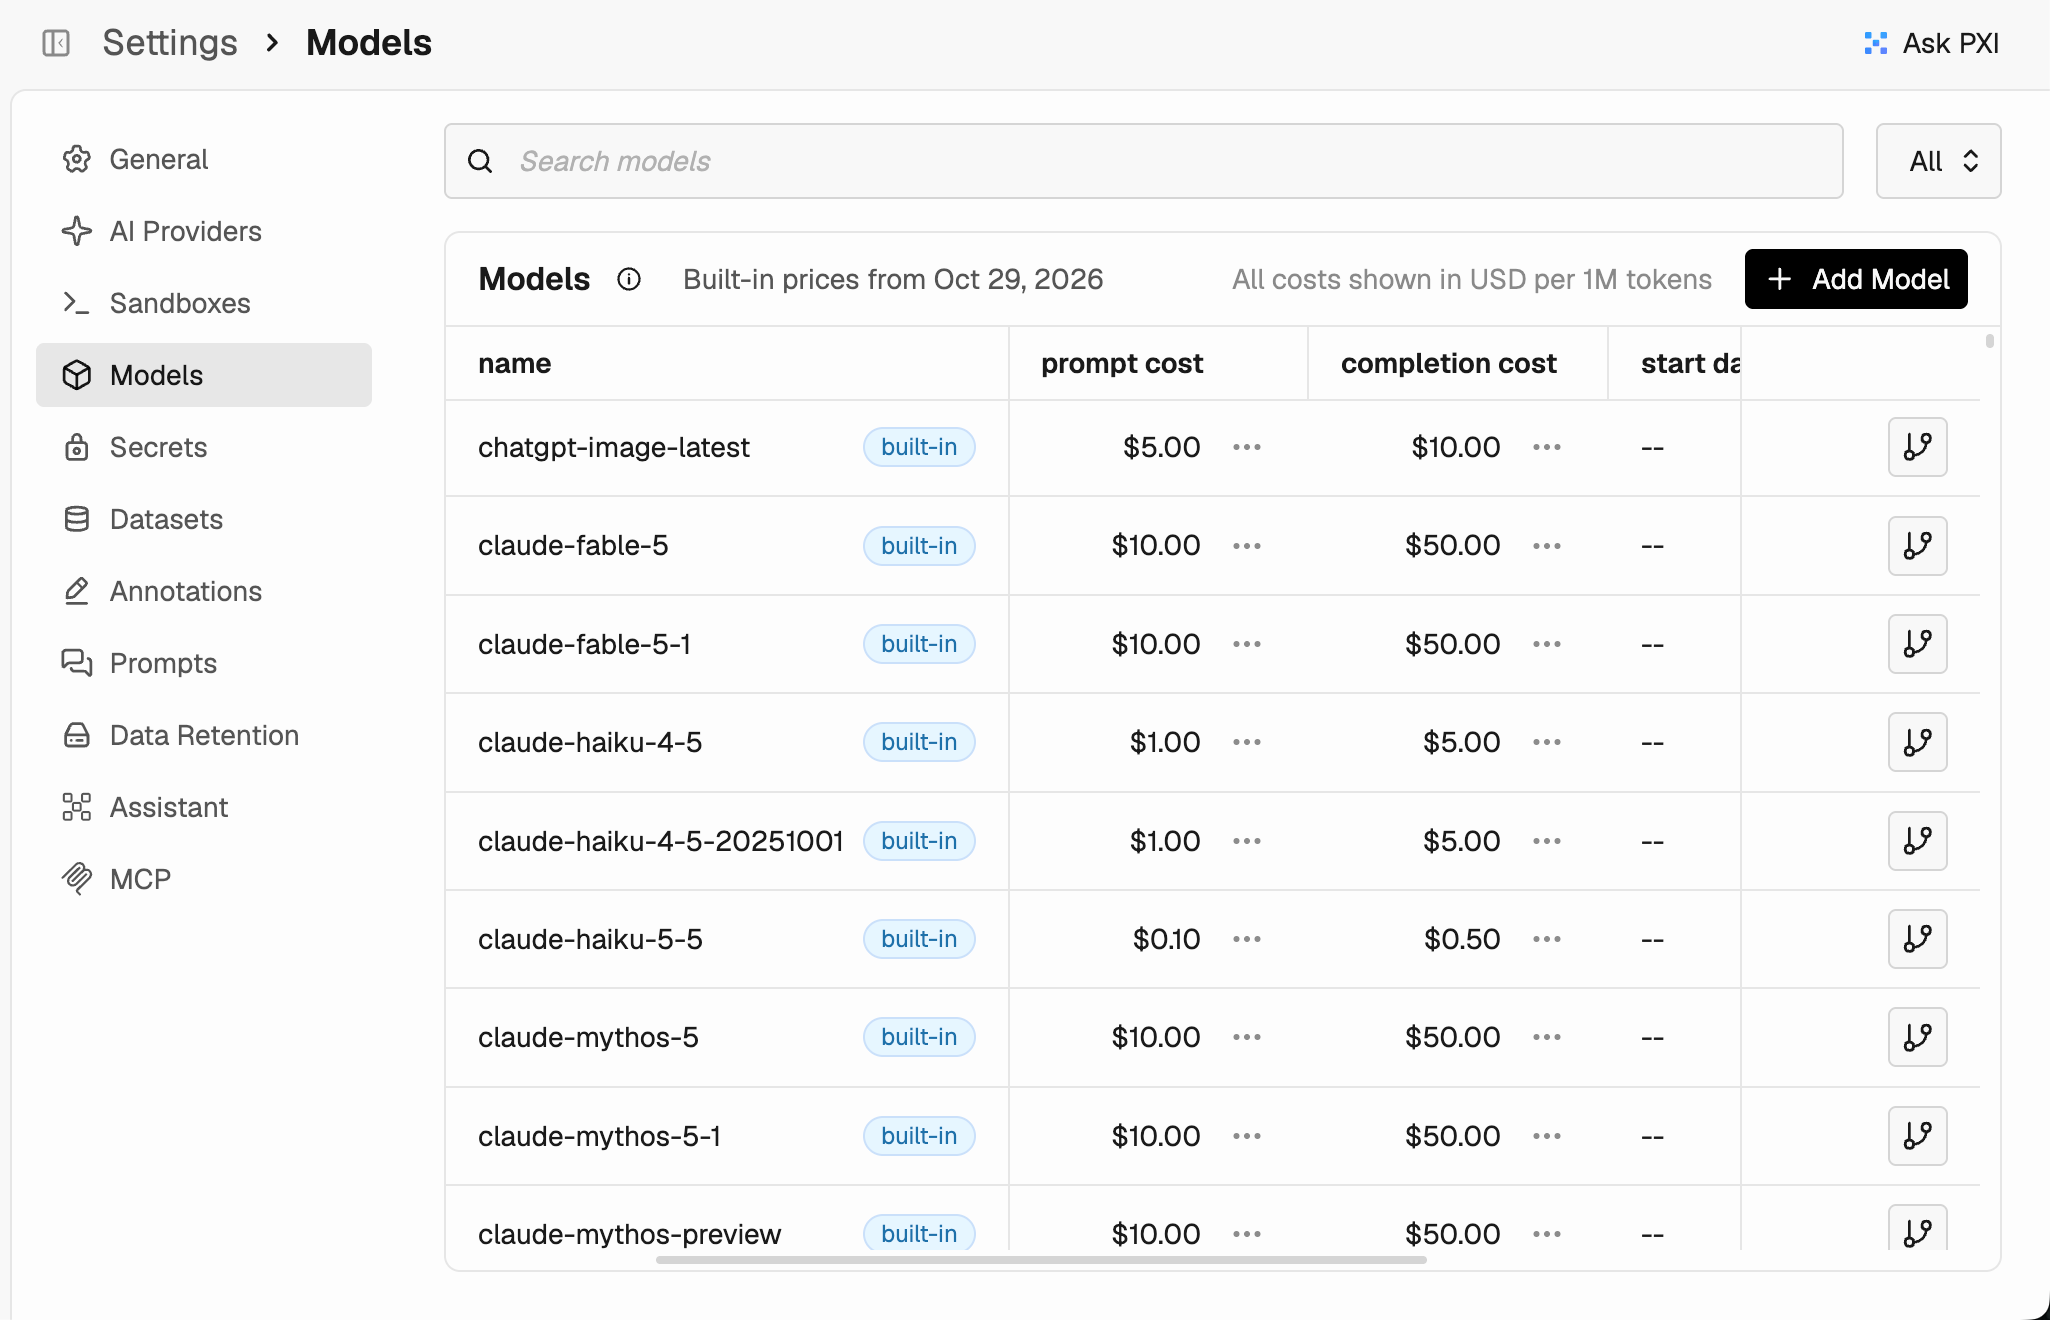
Arize Phoenix实现模型价格自动更新,无需人工干预即可同步最新LLM计费标准,提升成本管理效率。
入选理由:Phoenix通过GitHub每日自动下载LiteLLM价格目录更新模型费率