https://t.co/Q2FiKv4lwK
elvis(@omarsar0)2124 字 (约 9 分钟)
85
2026 年评估论文揭示了当前 AI 模型评估体系的严重缺陷,强调构建可靠评估体系的重要性。
入选理由:2026 年 12 个基准测试中,有 50% 已经饱和,无法区分模型性能。
精选推文#AI#评估#基准测试#模型#研究英文
公司
别名:EpochAIResearch
提供AI在数学研究领域应用数据的分析平台
已跟踪 10 条高相关材料
最近变化
2026-11-16 · 2026 年 12 个基准测试中,有 50% 已经饱和,无法区分模型性能。
为什么值得关注
epoch.ai 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
https://t.co/Q2FiKv4lwK
elvis(@omarsar0) · 8.5 分
2026 年评估论文揭示了当前 AI 模型评估体系的严重缺陷,强调构建可靠评估体系的重要性。
Epoch continues to do some of the best public benchmarking work on AI. This is helpful (and tells us how bad the state of benchmarking is, and how terrible some of our favorite benchmarks are)
Ethan Mollick(@emollick) · 8.5 分
Epoch AI推出Benchmark Reviews项目,揭示当前AI基准测试存在严重缺陷,15个基准中9个被标记为有缺陷。
[AINews] FrontierCode: Benchmarking for Code Quality over Slop
Latent Space · 8.5 分
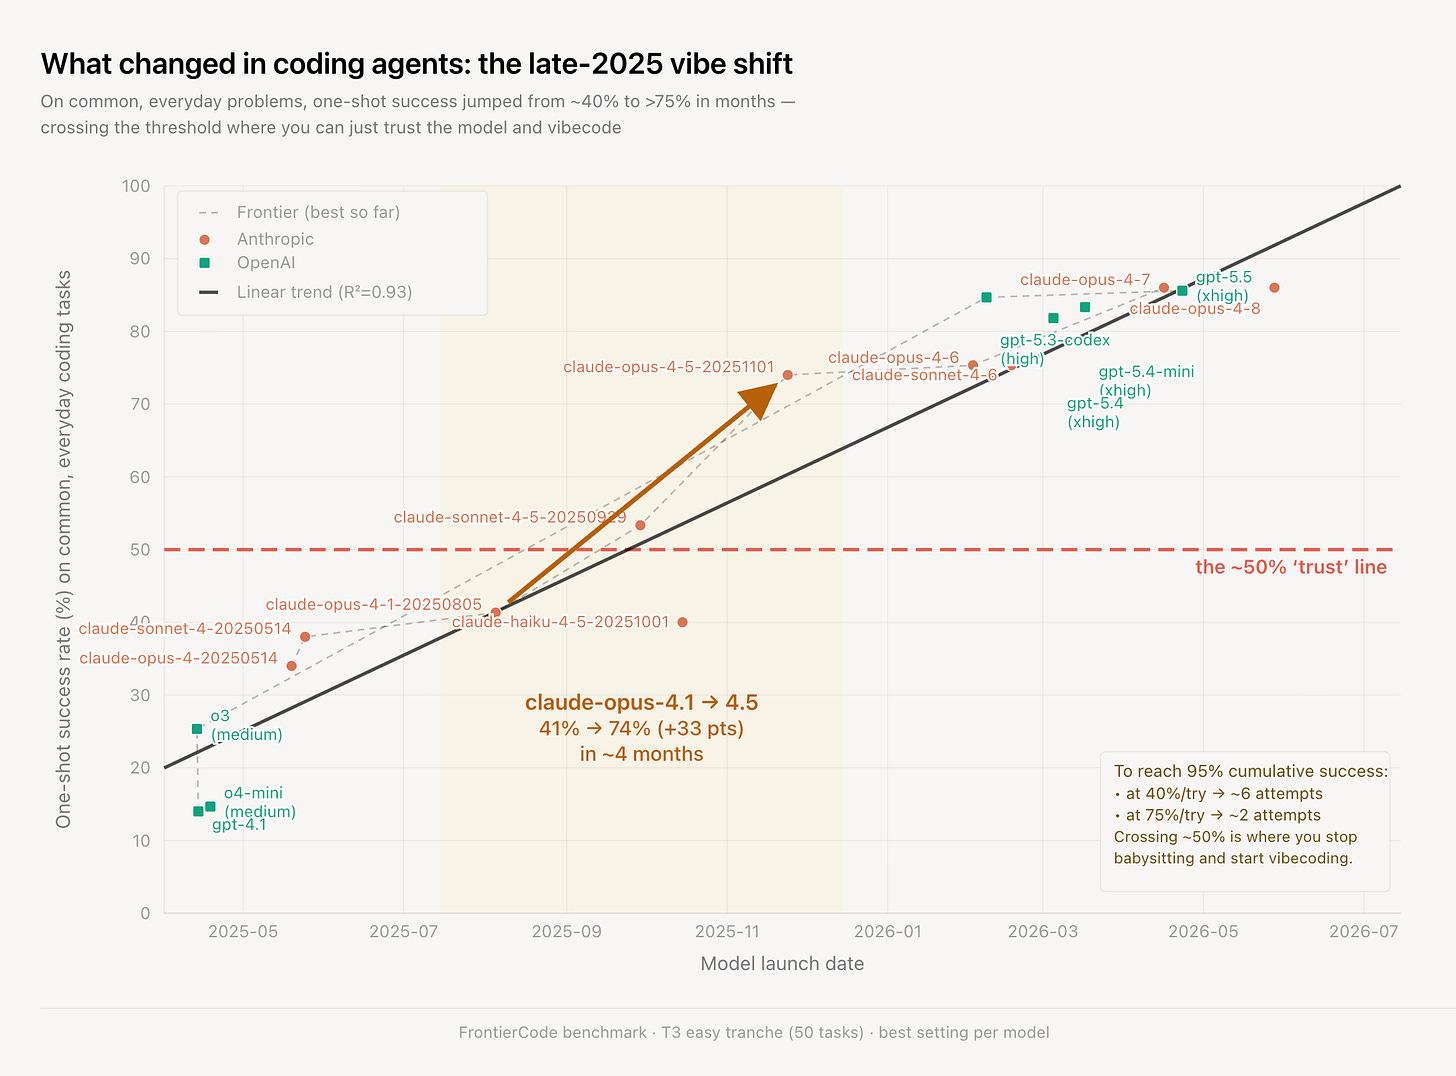
FrontierCode 是一项新的代码质量评估基准,专注于衡量代码是否可合并,而非仅通过单元测试。
已收录 10 条与 epoch.ai 相关的内容,按评分排序。
2026 年评估论文揭示了当前 AI 模型评估体系的严重缺陷,强调构建可靠评估体系的重要性。
入选理由:2026 年 12 个基准测试中,有 50% 已经饱和,无法区分模型性能。
Epoch AI推出Benchmark Reviews项目,揭示当前AI基准测试存在严重缺陷,15个基准中9个被标记为有缺陷。
入选理由:Epoch AI审计发现15个AI基准中9个存在严重缺陷
FrontierCode 是一项新的代码质量评估基准,专注于衡量代码是否可合并,而非仅通过单元测试。
入选理由:FrontierCode 由开源维护者耗时 40 多小时构建,旨在评估代码是否可合并。
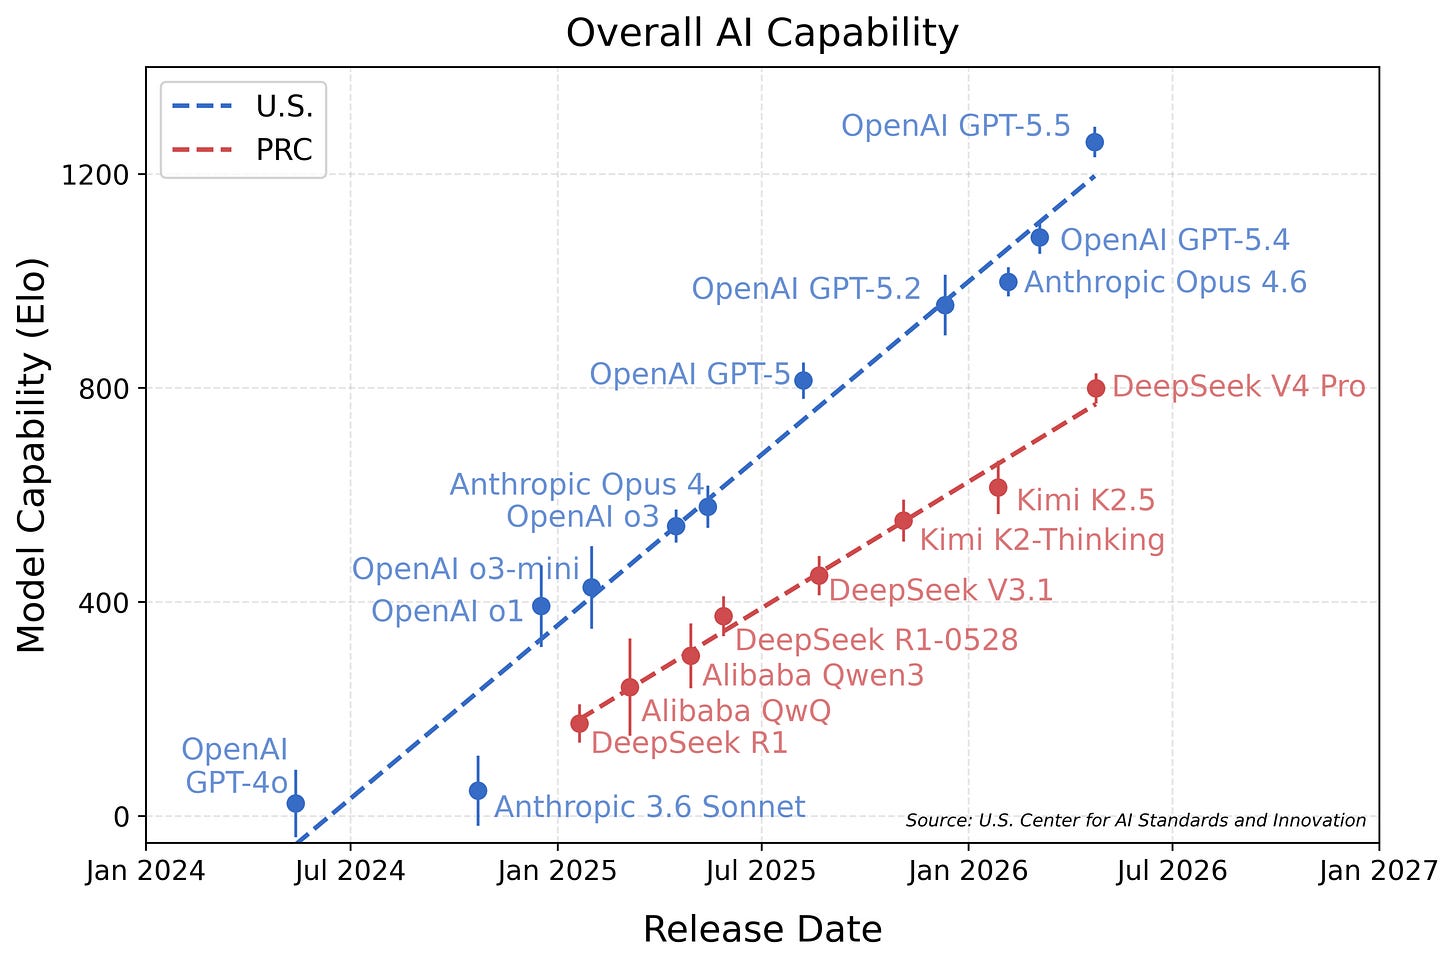
中国开源模型与美国前沿模型能力差距持续扩大,CAISI评估显示差距达3-7个月。
入选理由:CAISI评估显示中国开源模型在多个基准测试中落后于美国模型,差距达3-7个月。
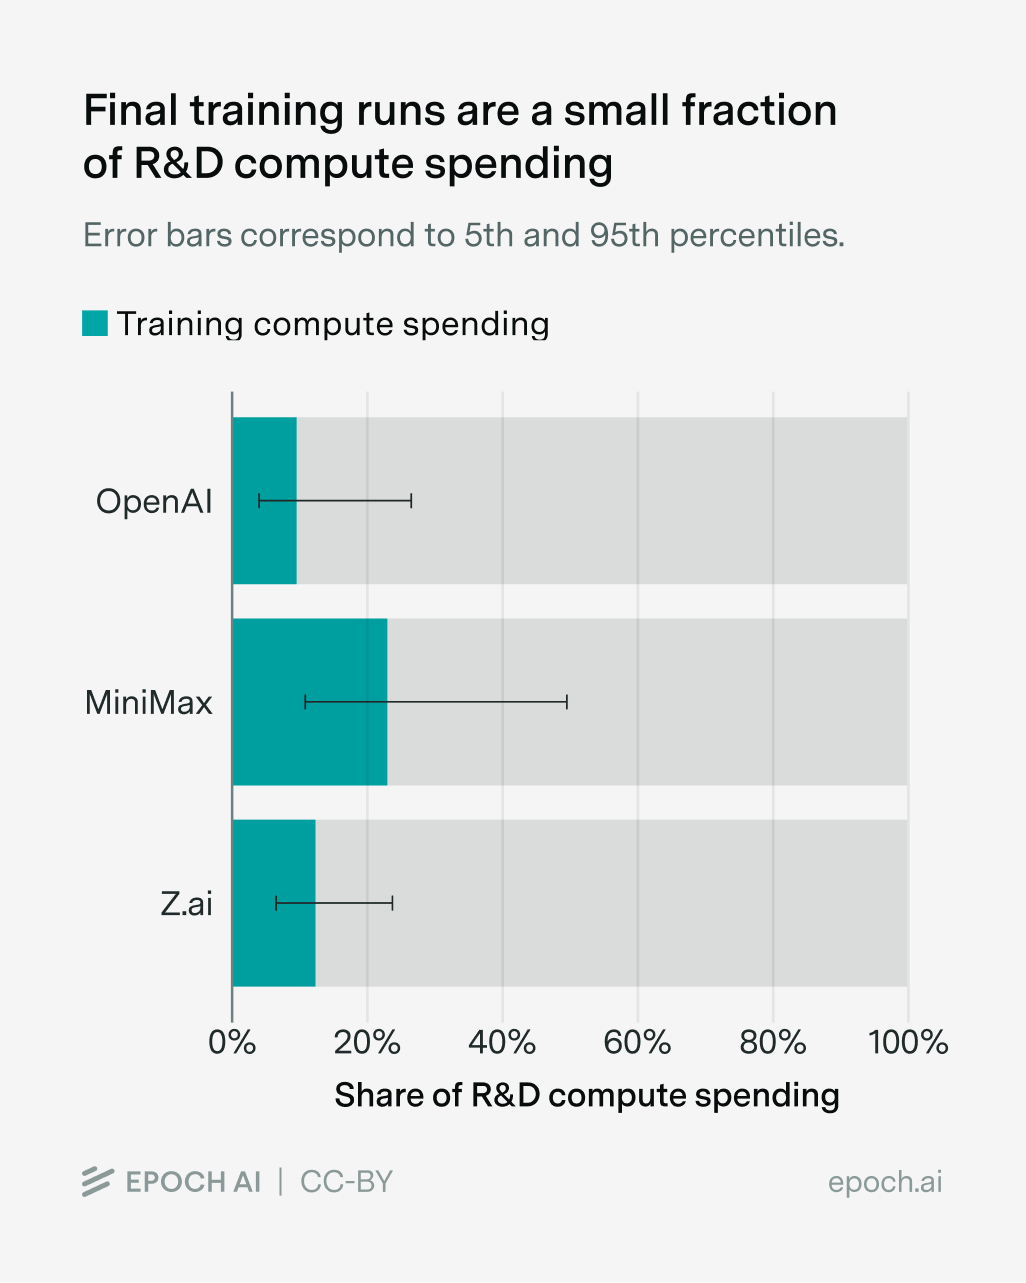
中国开放的AI生态系统通过减少重复研发计算成本,提高了模型开发的效率和可持续性。
入选理由:中国AI生态系统的开放性减少了重复的研发计算成本,使实验室能够持续更长时间。
当前 AI 评估(evals)存在严重缺陷,过度依赖客观指标易误导判断,但合理构建、解读并嵌入 agent 流程仍具关键价值。
入选理由:当前主流 eval(如 Epoch AI、OpenAI 的 benchmark)存在‘虚假精确性’,模型分数相近时实际能力差异显著。
作者预测2026年将是AI发展的关键一年,开放模型将面临更多挑战和机遇。
入选理由:2026年将是AI发展的关键一年,开放模型将面临更多挑战和机遇。
AI芯片中内存成本已占近三分之二,凸显存储性能瓶颈对整体算力效率的影响。
入选理由:AI芯片内存成本达63%,远超其他组件。
FrontierMath评测发现约三分之一题目存在致命错误,Epoch AI将发布修正后的数据集。
入选理由:FrontierMath Tiers 1-4中约33%的题目被标记为致命错误
AI在数学研究中的应用正在加速渗透,预计一年内将成为主流工具。
入选理由:当前已有38%的数学论文明确使用AI辅助研究