3倍速搜索:基于Instructed-Retriever-1的并行测试时缩放
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
公司
别名:Databricks Inc.
提供统一数据分析平台的企业
已跟踪 30 条高相关材料
最近变化
2026-11-17 · Azure Government Beta版集成Unity Catalog与无服务器计算,支持US Gov Virginia/Azure Arizona数据驻留
为什么值得关注
Databricks 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
3x Faster Search: Parallel Test-Time Scaling with Instructed-Retriever-1
Databricks · 9.2 分
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低...
Enabling Evolutionary Database Development: database branching with Lakebase
Databricks · 9.2 分
Databricks Lakebase 通过 copy-on-write 数据库分支技术,首次在生产级规模上实现 Martin Fowler 提出的“每位开发者拥有独立数据库实例”实践,将数据库演化开发从理论变为可操作现实。
Scaling for MHHS: how Octopus Energy achieved a 50x cost reduction in margin data engineering
Databricks · 9.2 分
Octopus Energy 通过重构数据架构,将 MHHS(全英市场半小时间隔结算)带来的 48 倍数据量增长转化为 50 倍成本下降,核心在于三流分离架构 + Delta Lake CDF 增量处理,使每日处理行数从 250 亿降至 3 亿。
已收录 30 条与 Databricks 相关的内容,按评分排序。
Databricks发布Instructed-Retriever-1模型,通过并行测试时计算将搜索延迟降低3倍、首Token时间缩至2秒,且无需牺牲检索质量。该模型统一查询生成与重排序任务,利用多枢轴分组重排和并行查询扩展实现召回率与精确度的帕累托最优,为企业级RAG系统提供低延迟高精度检索新范式。
入选理由:Instructed-Retriever-1使搜索延迟降低3倍以上,TTFT降至约2秒,无需重新配置。
Databricks Lakebase 通过 copy-on-write 数据库分支技术,首次在生产级规模上实现 Martin Fowler 提出的“每位开发者拥有独立数据库实例”实践,将数据库演化开发从理论变为可操作现实。
入选理由:Lakebase 支持秒级创建 TB 级生产数据库的零存储开销分支(O(1) 操作)
Octopus Energy 通过三流分离架构 + Delta Lake CDF 增量处理,应对 MHHS 政策带来的 48 倍数据增长,实现 50 倍成本下降,日处理行数从 250 亿降至 3 亿。
入选理由:采用三流分离架构(Settlement/Half-Hourly/Monthly)适配不同结算粒度,避免单体流水线重复处理未变更数据。
Databricks构建了名为Pantheon的自研时序数据库,支撑每日10万亿监控样本,通过分层存储、指标聚合与Lakehouse集成,解决多云高基数场景下的扩展瓶颈。
入选理由:自研Pantheon基于Thanos改造,支撑每日10万亿样本与50亿活跃时序,降低云成本数百万美元。
Databricks 在 Unity Catalog 中推出了 ABAC 行过滤和列屏蔽策略、治理标签和自动数据分类功能,实现了动态的数据保护和治理。
入选理由:Databricks 推出了 ABAC 策略,实现了一次定义多次应用的数据访问控制。
Superhuman与Databricks合作打造20万QPS AI推理平台,通过Lakehouse架构与模型优化实现低延迟高吞吐。
入选理由:平台峰值达到200,000 QPS,支持超大规模实时推理。
Databricks Genie通过自然语言民主化数据访问,将跨行业与通用功能型企业智能落地到财务、法务、IT等场景,显著缩短洞察获取周期并加速决策。
入选理由:AI4BI Command Center提供决策者统一、受治理的智能界面,含上下文洞察、主动预警与what-if能力,提升决策效率30%+。
以 Apache Spark Real-Time Mode 和 transformWithState 构建统一、低延迟(亚秒级)架构,替代 Flink 或自研方案,支撑百万级玩家的个性化、推荐与内容调度。
入选理由:使用 transformWithState + Real-Time Mode 实现单引擎统一架构,输入处理与定时触发均可达亚秒级精度。
CMS TEAM模型自2026年起强制700+医院管理5类高成本手术的30天全周期成本与质量,传统分析系统无法支撑实时干预;成功关键在于构建统一数据湖仓平台、嵌入式AI工作流与可扩展架构,否则66%医院将因滞后数据而亏损。
入选理由:CMS TEAM要求医院对5类手术(如关节置换、CABG)承担30天全周期成本责任, 未达标者5年内或面临超1000万美元追偿
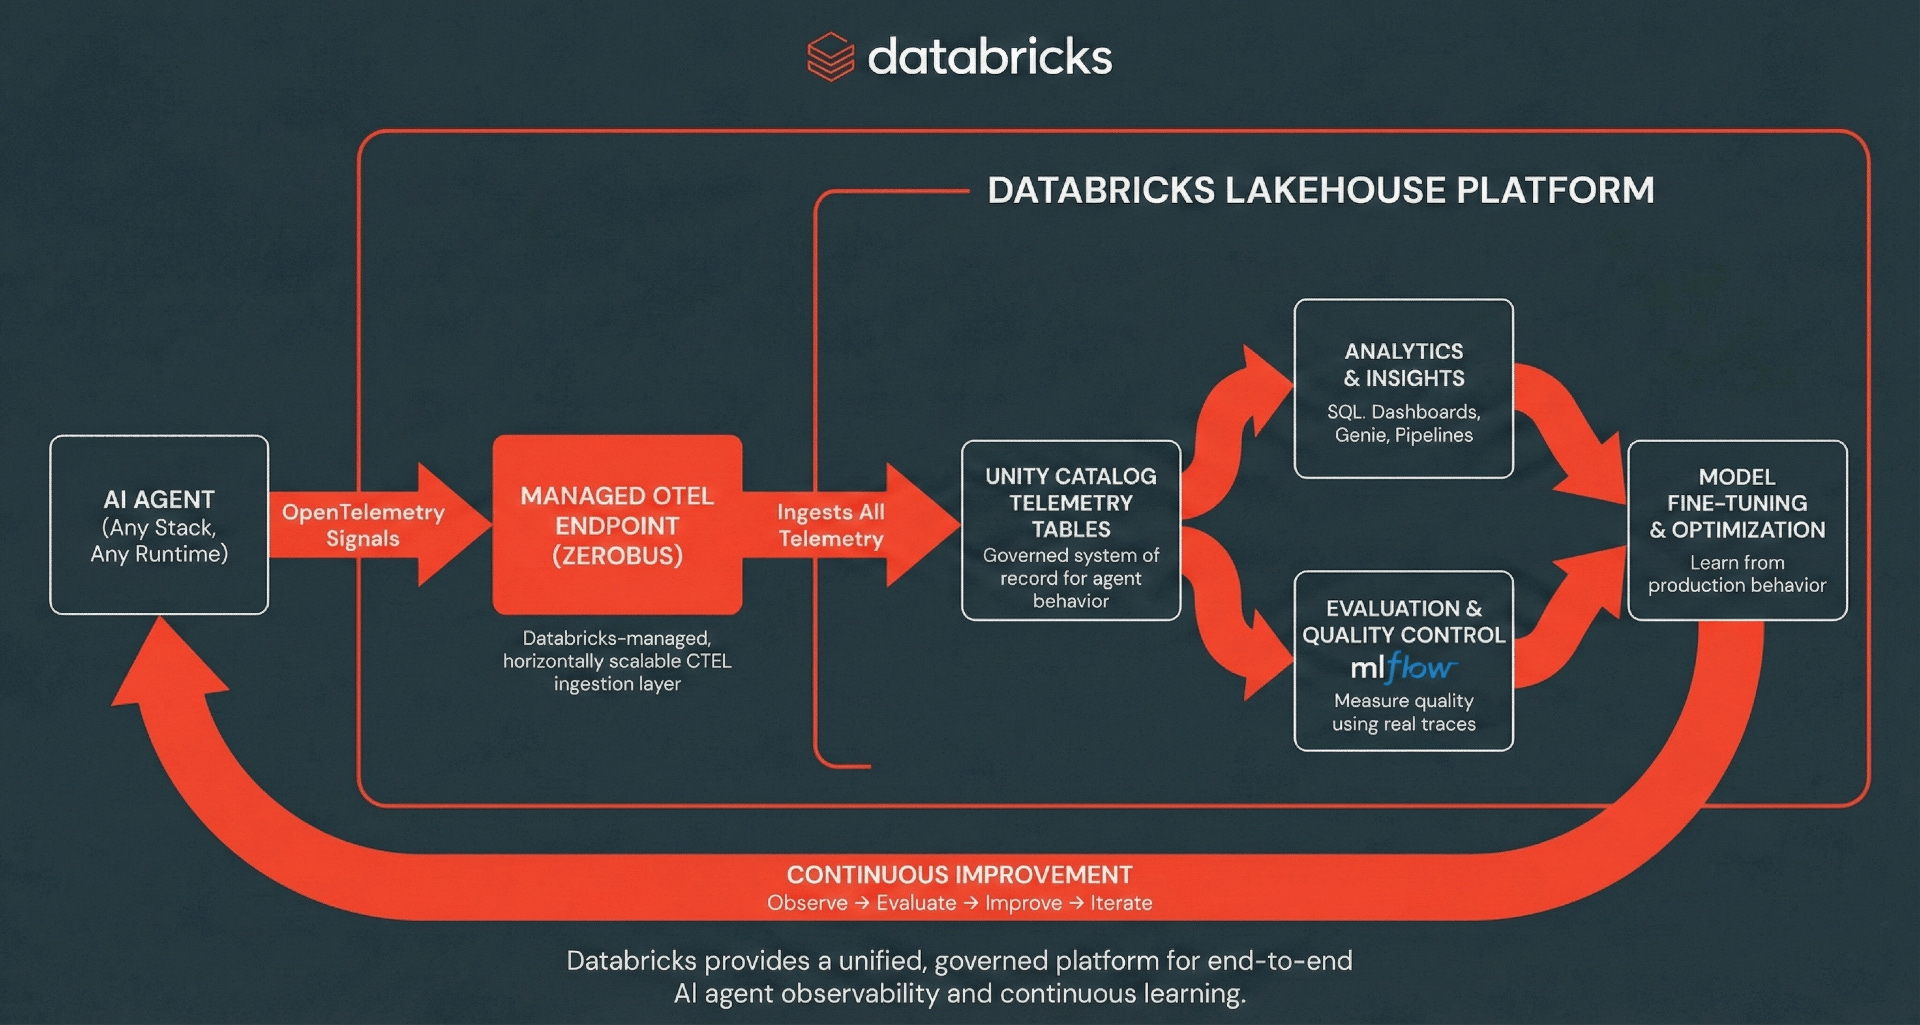
Databricks 推出基于 Unity Catalog 和 OpenTelemetry 的 AI Agent 可观测性方案,将 traces 以 Delta 表形式统一存储于 Lakehouse,实现低成本长期保留、SQL 分析、PII 治理与 MLflow 评估闭环。
入选理由:Databricks 支持通过 OTLP/gRPC 将 OpenTelemetry traces 实时写入 Unity Catalog Delta 表,实现零基础设施开销的 serverless ingestion。
HR团队面临空前压力,84%领导者报告频繁焦虑,95%认为工作量过大;AI虽未带来显著价值,但正成为突破人力瓶颈的核心路径。
入选理由:84% HR领导者报告频繁压力,95%称工作量‘太多且充满压力’
Azure Databricks政府版Beta发布,提供与商业版相同的数据AI平台能力,满足政府机构数据治理与合规需求。
入选理由:Azure Government Beta版集成Unity Catalog与无服务器计算,支持US Gov Virginia/Azure Arizona数据驻留
Databricks 发布 AI 指数,提供企业 AI 模型采用、支出和编码代理性能的实时数据。
入选理由:Databricks AI 指数每周更新,包含 10,000+ 企业的模型使用和支出数据。
Databricks Feature Views 实现了特征定义一次、训练和推理统一,支持实时推荐系统,延迟低至 34 毫秒。
入选理由:使用 Databricks Feature Views 可实现特征定义一次,同时用于训练和在线推理。
Genie One 可通过技能(skills)学习并执行团队的工作流程,确保输出格式和内容的一致性。
入选理由:Genie One 通过技能(skills)学习团队的工作流程,确保输出格式和内容的一致性。
Databricks推出Genie Migrate,支持7种数据仓库迁移,自动化处理80%代码,迁移时间缩短25%。
入选理由:Genie Migrate支持Microsoft SQL Server、Oracle等7种数据仓库的SQL转换
H6.ai通过Lakebase Postgres实现AI驱动的财务自动化,利用copy-on-write分支确保数据隔离和测试。
入选理由:每个客户使用独立Lakebase Postgres数据库实现数据隔离
Databricks首席解决方案架构师分享如何用Apache Spark与Unity Catalog重构金融风控体系,实现风险建模效率提升百倍。
入选理由:Apache Spark与Unity Catalog组合使复杂风控建模效率提升100倍
Databricks通过审计日志和Genie工具可检测凭证驱动攻击,提供六阶段行为分析及响应方案。
入选理由:使用Genie代理可检测身份行为在六阶段的异常变化
本文提供扩展Databricks应用的四阶段指南,涵盖性能目标设定、缓存策略、负载测试及实例优化,确保应用在高负载下保持响应和可靠性。
入选理由:设定p95延迟和峰值用户数是扩展Databricks应用的基础
Databricks通过Zerobus Ingest和Debezium实现无需Kafka的CDC推送,简化数据复制流程。
入选理由:Zerobus Ingest 3.7版本支持直接推送CDC到Delta表,无需Kafka中间件
开放权重模型通过降低企业AI成本、保障数据主权和操作自主性,成为企业AI战略新选择。Databricks的Unity AI Gateway与Omnigent结合可实现统一模型治理。
入选理由:开放权重模型成本比前沿模型降低30%-50%(引用Databricks基准测试)
Apache Spark 4.3 引入了状态化实时处理和SCD Type 2自动CDC,显著提升实时应用性能。
入选理由:Real-Time Mode实现低于150ms的P99端到端延迟,支持流式聚合和去重
Databricks通过UNIQUE约束和RELY优化,实现查询性能提升12倍。
入选理由:UNIQUE约束支持多列组合和可空字段的唯一性声明
Databricks MLflow现在支持Claude平台的原生OpenTelemetry可观测性,便于统一调试和分析。
入选理由:Databricks MLflow支持Claude平台原生OpenTelemetry导出,可存储在Unity Catalog中
Databricks推出Lakebase Postgres,该全托管无服务器数据库已在Google Cloud正式发布,通过统一存储层和智能扩展能力降低运维成本。
入选理由:Lakebase Postgres支持自动扩展和零复制分支,可降低30%基础设施成本
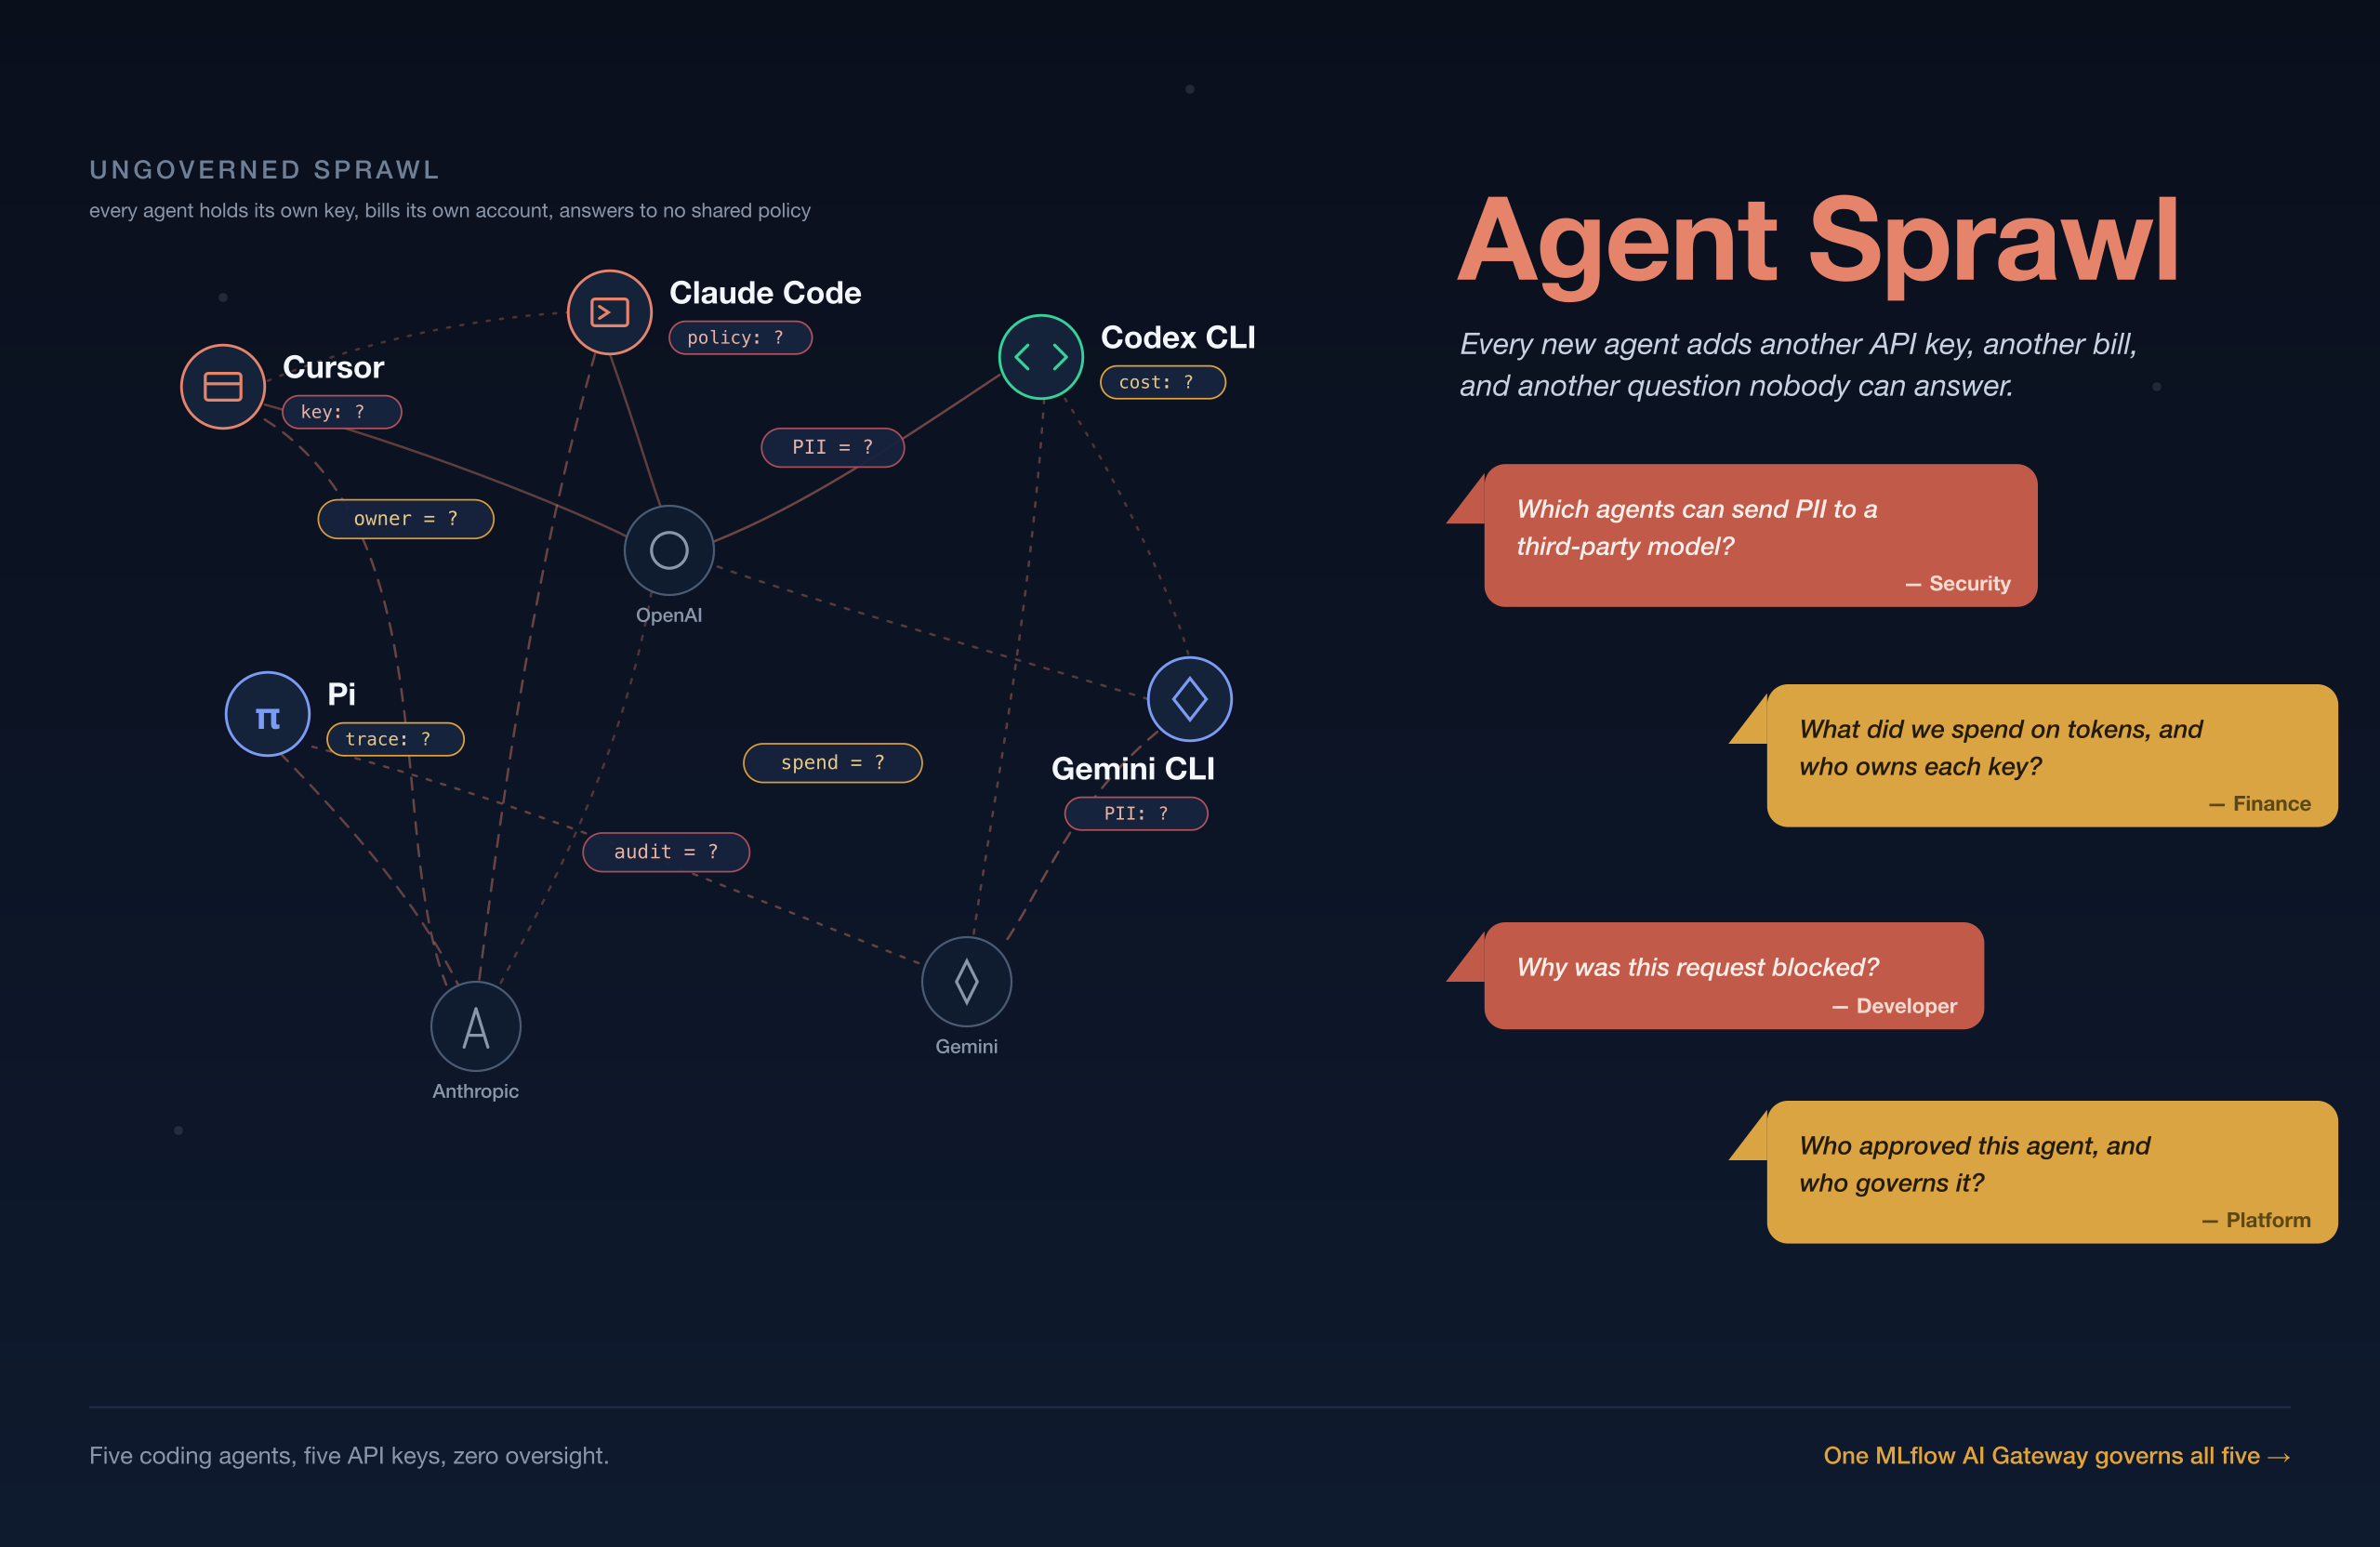
MLflow AI Gateway通过集中管理多个代码代理,解决API密钥分散、费用失控和数据泄露问题,提升治理效率。
入选理由:MLflow AI Gateway统一管理5个以上代码代理的API密钥和预算控制
Lakebase的分支技术通过copy-on-write机制,使CI/CD中的PR数据库创建时间缩短至60秒内,存储效率提升显著。
入选理由:copy-on-write分支使100个并发PR数据库的存储仅增加变更数据
Databricks推出Spark Declarative Pipelines的实时模式(RTM),实现毫秒级延迟,性能比Flink快92%。
入选理由:RTM实现端到端毫秒级延迟,适用于欺诈检测等实时场景
Google Knowledge Catalog通过整合多源语义模型提升AI代理准确性,内部测试显示准确率提升4倍且延迟降低33%。
入选理由:Knowledge Catalog整合Looker、dbt、Snowflake等7种工具的语义模型