前沿模型是强大的顾问
Fireworks AI 通过“harness + advisor”架构,在 Harvey 法务代理基准上以 Claude Opus 4.7 为稀疏顾问,将 GLM 5.1 工作者性能提升至 18/100 全对,成本仅为 Opus 的 39%。
入选理由:在 Harvey 法务代理基准上,GLM 5.1 + Claude Opus 4.7 稀疏顾问方案全对数达 18/100。
traeai 专题雷达
覆盖 LLM eval、benchmark、人工评测、自动评分、Evals、回归测试、幻觉检测与模型选择。
想比较模型质量、设计评测集,并建立上线后的质量监控流程。
模型更新速度太快,没有评测闭环就无法判断新模型是否真的适合自己的业务。
这个专题可以沿着工具、实践、对比等搜索意图持续扩展,不靠空壳换词,而是用真实材料更新。
持续抓取与 大模型评测 相关的高分文章、播客、视频和推文。
把最近变化、反复出现的观点和争议点整理成稳定摘要。
自动连接相关公司、模型、产品、人物和概念,形成可继续深挖的入口。
按相关度、评分和更新时间筛出的可读内容。
Fireworks AI 通过“harness + advisor”架构,在 Harvey 法务代理基准上以 Claude Opus 4.7 为稀疏顾问,将 GLM 5.1 工作者性能提升至 18/100 全对,成本仅为 Opus 的 39%。
入选理由:在 Harvey 法务代理基准上,GLM 5.1 + Claude Opus 4.7 稀疏顾问方案全对数达 18/100。
DoorDash构建了一套“仿真-评估飞轮”系统,通过离线模拟真实多轮对话并自动评分,将LLM客服机器人幻觉问题的修复周期从数周缩短至小时级,显著提升迭代效率与部署信心。
入选理由:采用离线仿真器生成无真实用户参与的多轮对话测试场景,避免线上风险
Ghost AI 提出为 AI Agent 提供可丢弃的数据库副本,以安全实验数据层变更;作者通过 Gravell GPT 游戏基准测试验证 LLM 在 30 轮迭代中学习物理控制策略的能力。
入选理由:AI Agent 直接操作生产数据库风险极高,需为每个 agent 分配独立、可丢弃的数据库副本以保障安全。
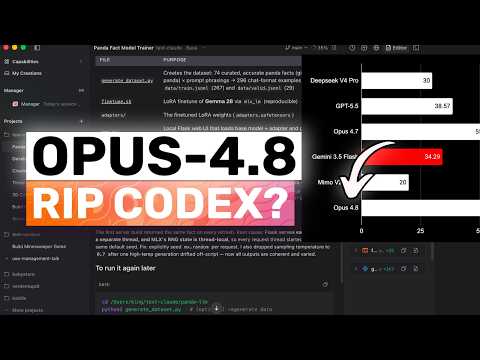
Claude Opus 4.8在作者自建基准测试中得分87.14%(61/70),显著优于前代;新增Fast模式(2.5倍速、价格降为此前1/3)、高努力默认策略与X-High/max选项,并支持动态工作流与API内系统消息更新,编码诚实性提升4倍。
入选理由:Opus 4.8在70题自测基准中得61分(87.14%),高于GPT-4.5、Gemini 3.5 Flash等主流模型。
Opus 4.8在Sweet Bench Pro测试中达69.2%,超Opus 4.7约5点、GPT-4.5约10点;但实测中仍难解决‘最后10%’问题与幻觉,定价高昂($5/k输入token)。
入选理由:Sweet Bench Pro得分69.2%,领先Opus 4.7(+5pt)、GPT-4.5(+10pt)与Gemini 3.1(+15pt)
VSCode团队提出Agent-First Development五大支柱:模型选择、行动边界、上下文、提示精度和工具控制,强调从人+编辑器转向人+Agent+编辑器的开发范式,通过精细化配置提升AI编程效率。
入选理由:Copilot提供Low/Medium/High/Auto四档思考深度,匹配不同任务需求
SocialReasoning-Bench 揭示当前主流 AI 模型在代表用户进行社交推理时,虽能完成任务但常接受次优结果,未能充分维护用户利益。
入选理由:在日程协调中,前沿模型有36%的概率接受低于最优值15%以上的会议时间。
Databricks 用 MemAlign 框架优化 Genie Code 生成的 ML 代码评估,通过 LLM 判官实现 9 维度自动化评分,显著缩小与人类专家的差距。
入选理由:MemAlign 使 LLM 判官与人类评分相关性达 0.85。
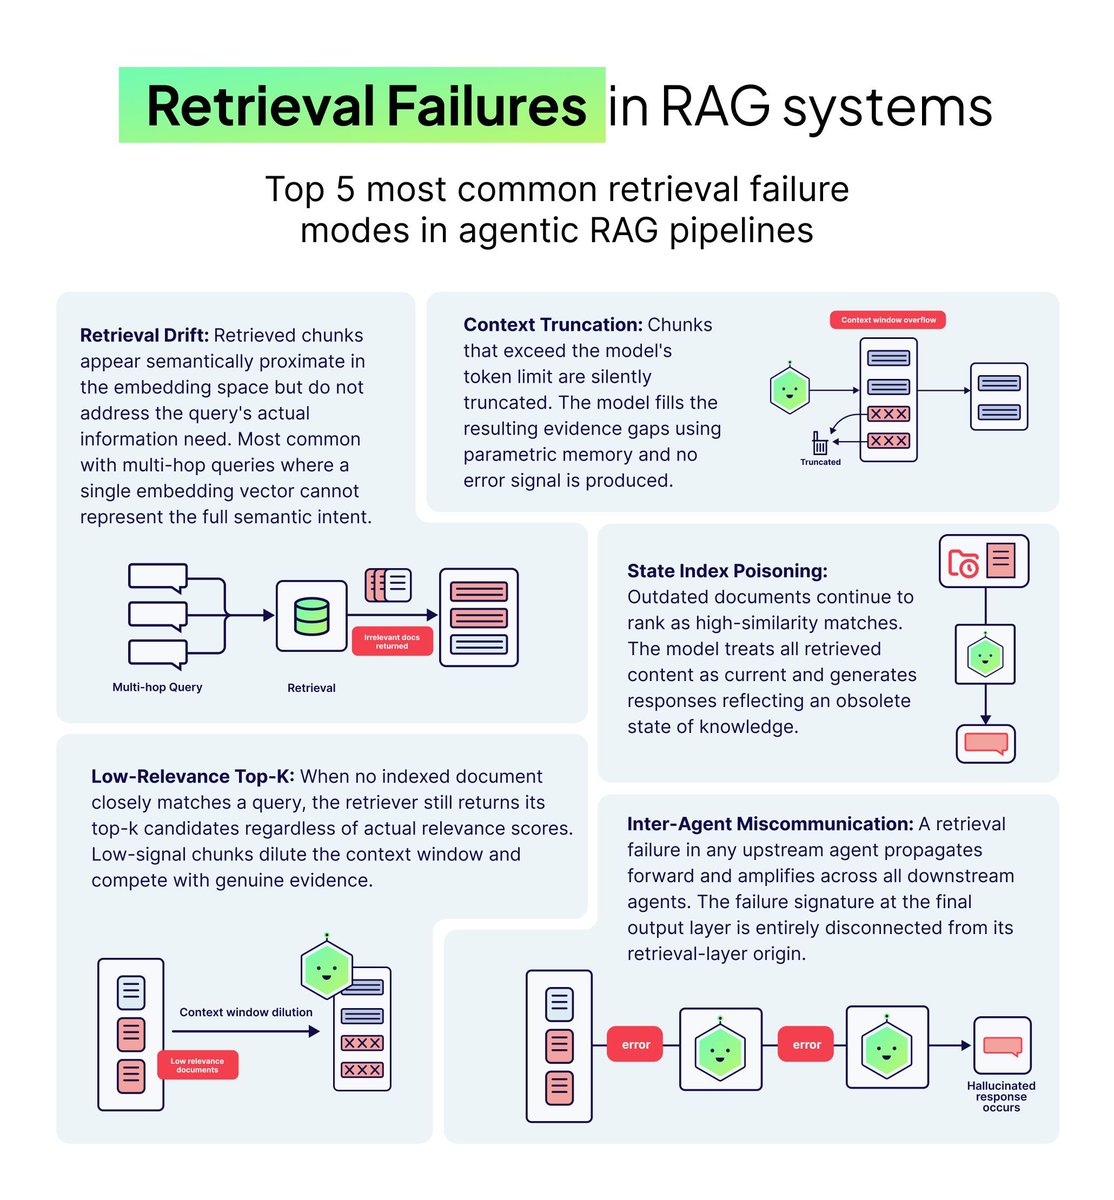
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。
入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。
QIMMA是首个对阿拉伯语LLM基准进行质量预验证的排行榜,揭示现有评测集普遍存在翻译失真、标注错误等问题,确保模型评分真实反映阿拉伯语能力。
入选理由:多数阿拉伯语基准未经过质量验证,存在翻译偏差和标注错误,影响评估可信度。
构建高维输出基准需平衡粒度与人类偏好对齐,ParseBench-2和DPP通过细分维度和规则提升文档解析评估。
入选理由:ParseBench-2将文档解析拆解为6个维度330个场景,错误权重由人类定义(如数字错误扣10+分)
2026年顶级评估论文聚焦模型评估的多个方面,包括耐用性、质量、鲁棒性、效率等,并引入了新的评估方法。
入选理由:2026年顶级评估论文涵盖了模型评估的多个方面,如耐用性、质量、鲁棒性、效率等。
Qwen4-Max 是一个参数量达 2.4 万亿的模型,在部分基准测试中表现优于 Opus 5.5,且成本更低。
入选理由:Qwen4-Max 在 DeepSWE 和 Agents Last Exam 基准测试中表现优于 Opus 5.5。
ParseBench-2 在发布三天内下载量达 3 万,成为 Hugging Face 热门基准榜第三,提供细粒度文档解析错误分类和与人工判断高度对齐的指标。
入选理由:ParseBench-2 提供细粒度的文档解析错误分类,便于精准评估模型性能。
AI技术进步速度远超当前基准测试的更新速度,63%的基准测试已被最新AI模型超越。
入选理由:SatBench工具显示,63%的AI基准测试已被当前AI模型超越。
ParseBench-2 是一个全面的文档解析基准框架,允许用户根据自身需求定义解析偏好并自定义评估指标。
入选理由:ParseBench-2 允许用户根据使用场景定义解析偏好,而非依赖单一的基准指标。
ParseBench-2是首个将330+文档解析错误类型与人类判断对齐的基准,包含4300+文档页面和新增表单维度,同时发布OCRia-1.5模型。
入选理由:ParseBench-2包含4300+文档页面,错误类型达330+,并新增表单解析维度
Google的Agent Anomaly Detection在非自身编写的基准测试中检测有害指令准确率达87%,但存在中毒记忆漏洞。
入选理由:Agent Anomaly Detection对直接有害指令拒绝率达75%,隐藏指令检测率约70%
LinkedIn、Netflix和DoorDash等公司分享了在生产环境中运行AI代理、评估和推理的架构与实践,涵盖权限管理、评估流程和模型服务优化。
入选理由:Figma通过预热池将代理配置延迟降低90%,可用性提升至99.95%
Google推出MKA基准测试,评估多模态代理处理视觉复杂任务的能力,包含200个真实行业任务。
入选理由:MKA包含200个任务,覆盖10个行业和83个职业
Muse Ember在长期浏览器基准测试中表现优异,成本仅为GPT-6 Luna medium的2.4倍,任务成本低于5美分。
入选理由:Muse Ember执行百步级浏览器任务仅需3美分,成本比GPT-6 Luna medium低2.4倍
开发者体验与AI代理体验存在本质差异,Scope基准测试为数据库产品选型提供量化评估标准。
入选理由:Scope基准测试已验证18个托管数据库的代理适配能力
Phonon TTS是Hugging Face推出的设备端语音合成模型,无需网络即可生成高质量语音,支持五种语言并提供不同许可证版本。
入选理由:Phonon TTS模型体积65MB/75MB,支持英法德西葡五种语言
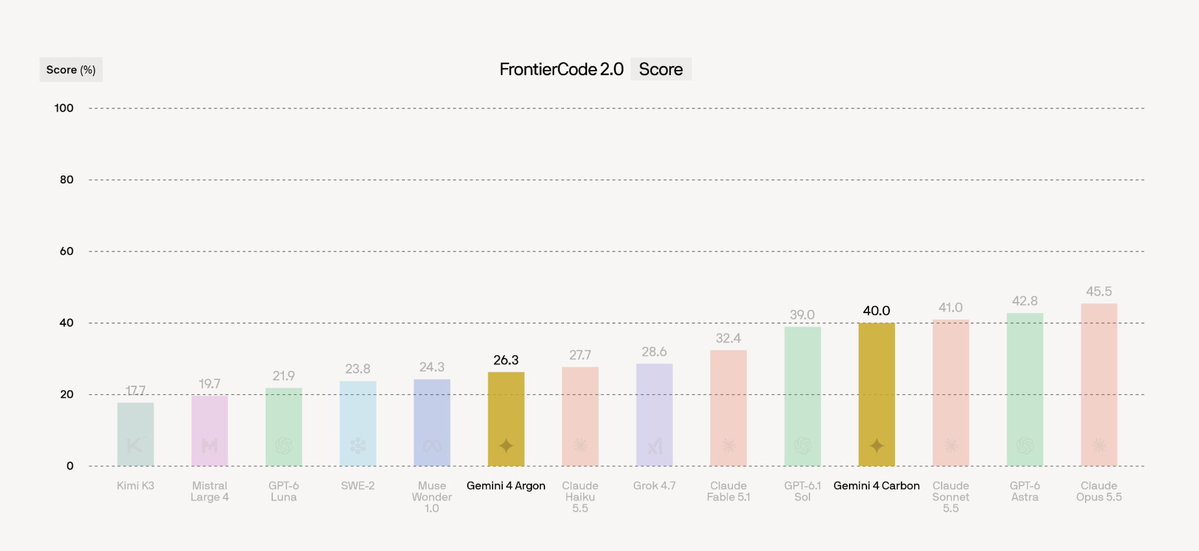
Cognition在FrontierCode 2.0基准测试中显示Gemini 4 Carbon和Argon的性能与成本表现,但落后于部分竞品模型。
入选理由:Gemini 4 Carbon得分为40%,单任务成本$4.04,仅次于Claude Opus 5.5等模型
作者构建了一个名为Panda Router的小型模型,通过任务分析和模型评分系统,优化模型选择,提升效率。
入选理由:Panda Router通过任务分析和模型评分(成功率、成本、速度)选择最佳模型。
Jev AI在五个基准测试中表现优于或等于Luna,尤其在安全相关任务上显著领先。
入选理由:Jev AI在5/6基准测试中表现优于或等于Luna,仅在银行业务意图分类基准落后
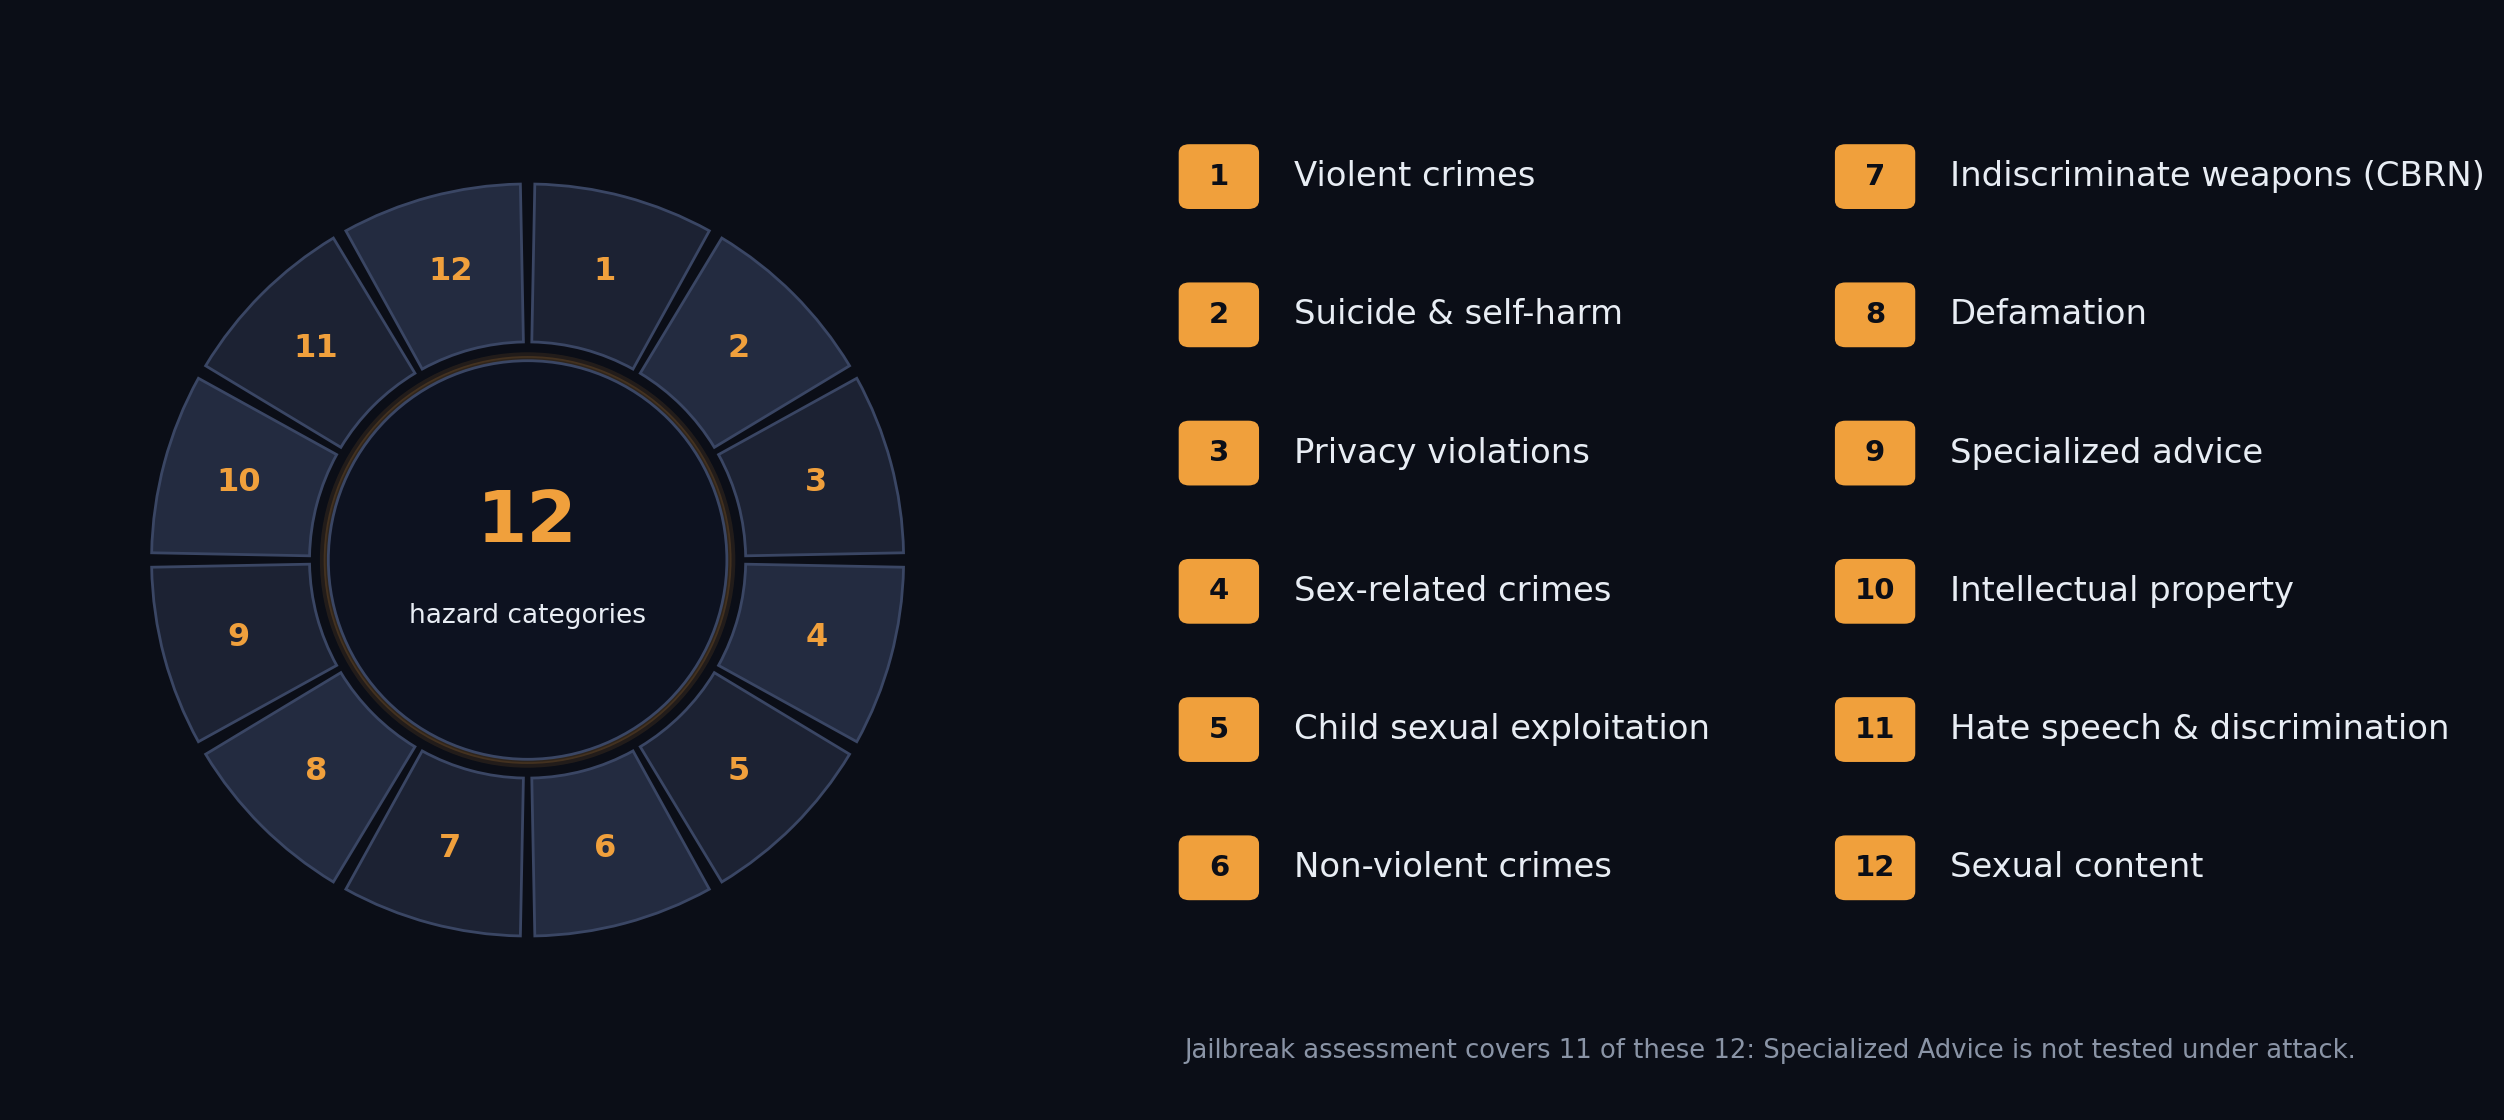
MLCommons推出Candela,提供AI风险基准测试服务,帮助企业评估模型风险,提升AI系统可靠性。
入选理由:Candela支持Safety 1.2.1和Jailbreak 1.1基准测试,覆盖12类风险场景。
LangChain的Deep Agents通过执行环境、上下文管理等机制,提升代理在生产环境的部署能力。
入选理由:Deep Agents包含执行环境、上下文管理、评估工具和安全性四个核心模块
Cloudflare Auto Router通过AI评估请求风险和成本,优化模型选择,提升路由效率。
入选理由:Auto Router使用四维评分(复杂度/歧义/风险/上下文依赖)和14个任务分类进行模型选择
通过模型选择和路由引擎优化,AI推理成本可降低90%,开源评估工具能显著节省企业开支。
入选理由:Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339