Optimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorch
PyTorch Blog2098 字 (约 9 分钟)
85
ExecuTorch框架结合Arm SME2技术可将流式语音识别延迟降低40%,同时通过量化技术减少70%处理时间。
入选理由:使用SME2与INT8量化可使ASR处理时间减少70%
精选文章#PyTorch#ExecuTorch#Arm#语音识别#边缘计算英文
产品
CPU推理库,支持微内核优化
已跟踪 3 条高相关材料
最近变化
2026-10-26 · 使用SME2与INT8量化可使ASR处理时间减少70%
为什么值得关注
XNNPACK 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Optimizing Streaming Speech Recognition on Arm® Edge Devices with ExecuTorch
PyTorch Blog · 8.5 分
ExecuTorch框架结合Arm SME2技术可将流式语音识别延迟降低40%,同时通过量化技术减少70%处理时间。
Native Model Authoring for Edge with LiteRT Tensor API
Google Developers Blog · 8.5 分
Google推出LiteRT Tensor API,解决边缘设备AI模型部署的跨平台兼容性与性能优化难题,支持C++原生编写与多硬件直接运行。
Blazing fast on-device GenAI with LiteRT-LM
Google Developers Blog · 7.5 分
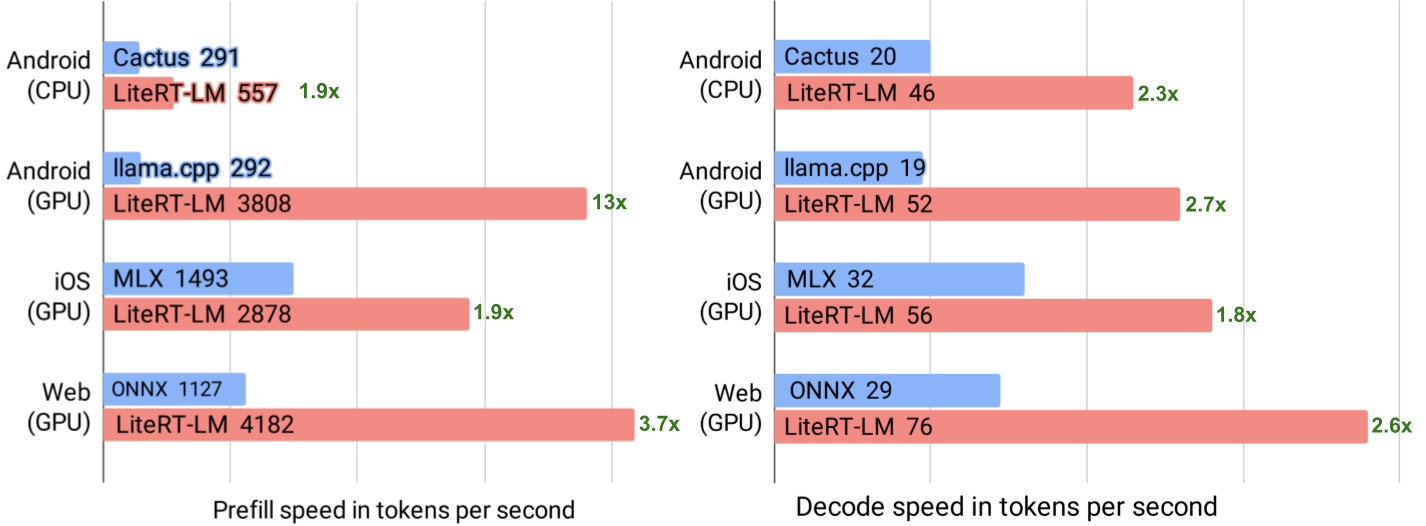
Google AI Edge 发布 LiteRT-LM 推理引擎,专为在边缘设备上高效运行 Gemma 4 模型设计,支持 Android、iOS、Web 多平台,GPU 推理可达 76 tokens/sec,结合 Multi-Token Prediction 技术实现 2.2...
已收录 3 条与 XNNPACK 相关的内容,按评分排序。
ExecuTorch框架结合Arm SME2技术可将流式语音识别延迟降低40%,同时通过量化技术减少70%处理时间。
入选理由:使用SME2与INT8量化可使ASR处理时间减少70%
Google推出LiteRT Tensor API,解决边缘设备AI模型部署的跨平台兼容性与性能优化难题,支持C++原生编写与多硬件直接运行。
入选理由:LiteRT Tensor API允许用C++直接编写计算图,无需为CPU/GPU/NPU重写代码
Google AI Edge 发布 LiteRT-LM 推理引擎,专为在边缘设备上高效运行 Gemma 4 模型设计,支持 Android、iOS、Web 多平台,GPU 推理可达 76 tokens/sec,结合 Multi-Token Prediction 技术实现 2.2 倍加速。
入选理由:LiteRT-LM 在 Android GPU (OpenCL) 上实现 52 tokens/sec 解码速度,iOS (Metal) 达 56 tokens/sec,WebGPU 在 MacBook Pro 上可达 76 tokens/sec