Gemma 4 12B:开发者指南
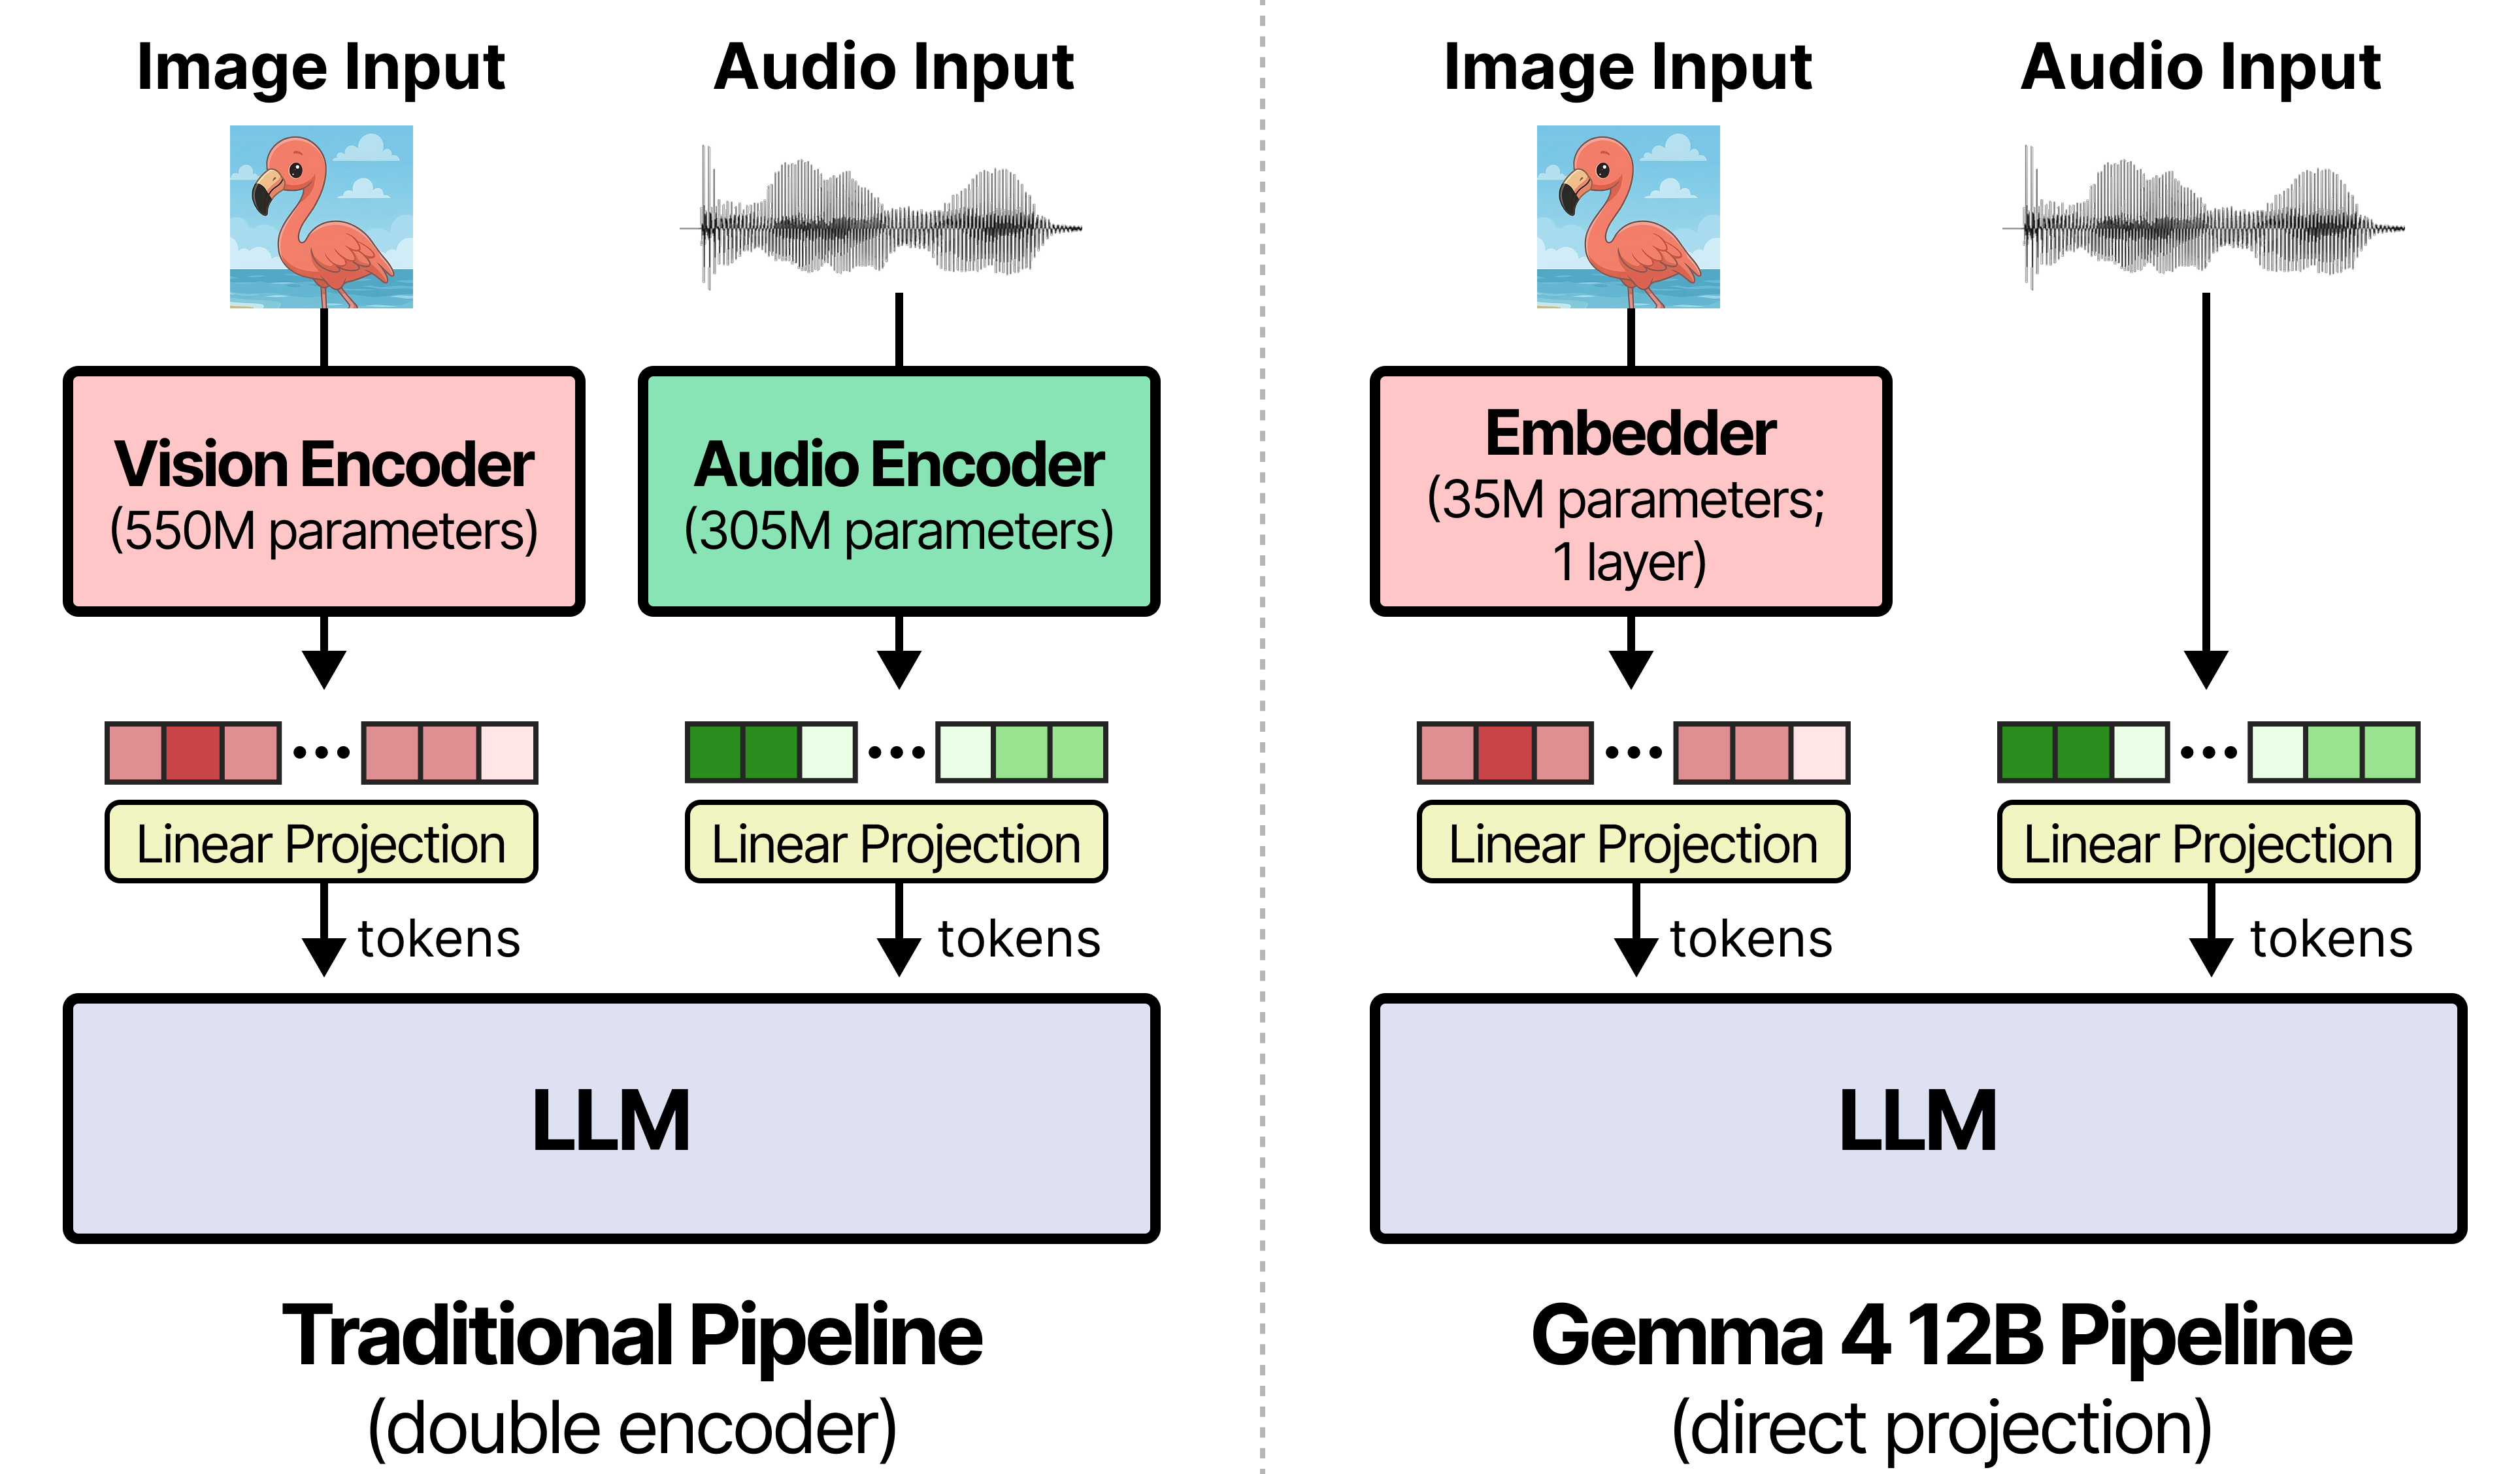
Gemma 4 12B采用无编码器多模态架构,可在16GB显存设备上本地运行并原生支持音频输入。该模型通过移除独立视觉与音频编码器显著降低延迟,配合专用MTP模型提升推理速度,是首个支持macOS桌面端全离线交互的中型多模态模型。
入选理由:Gemma 4 12B移除独立编码器,视觉仅用35M参数嵌入层,音频直接线性投影至LLM输入空间
产品
别名:UnslothAI
支持决策模型训练的机器学习框架
已跟踪 5 条高相关材料
最近变化
2026-11-04 · Unsloth的FastDecisionModel可将语言模型转换为选择预定义选项的决策模型
为什么值得关注
Unsloth 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Gemma 4 12B: The Developer Guide
Google Developers Blog · 9.2 分
Gemma 4 12B采用无编码器多模态架构,可在16GB显存设备上本地运行并原生支持音频输入。该模型通过移除独立视觉与音频编码器显著降低延迟,配合专用MTP模型提升推理速度,是首个支持macOS桌面端全离线交互的中型多模态模型。
How to Train Your own Decision Model like Jev using Unsloth
Machine Learning Mastery · 8.5 分
使用Unsloth和Qwen3.5-4B模型可训练决策模型,通过CLINC150数据集实现用户意图分类,输出结构化预测结果。
Qwen3.8-Flash-Next
Simon Willison's Weblog · 8.5 分
Qwen3.8-Flash-Next是通义千问推出的多模态MoE模型,具有125B参数和显著性能提升。
已收录 5 条与 Unsloth 相关的内容,按评分排序。
Gemma 4 12B采用无编码器多模态架构,可在16GB显存设备上本地运行并原生支持音频输入。该模型通过移除独立视觉与音频编码器显著降低延迟,配合专用MTP模型提升推理速度,是首个支持macOS桌面端全离线交互的中型多模态模型。
入选理由:Gemma 4 12B移除独立编码器,视觉仅用35M参数嵌入层,音频直接线性投影至LLM输入空间
使用Unsloth和Qwen3.5-4B模型可训练决策模型,通过CLINC150数据集实现用户意图分类,输出结构化预测结果。
入选理由:Unsloth的FastDecisionModel可将语言模型转换为选择预定义选项的决策模型
Qwen3.8-Flash-Next是通义千问推出的多模态MoE模型,具有125B参数和显著性能提升。
入选理由:Qwen3.8-Flash-Next采用多模态MoE架构,是Qwen4的早期预览版本
DiffusionGemma 模型通过并行生成文本块,实现高达 4 倍的文本生成速度,适用于需要高速处理的本地交互场景。
入选理由:DiffusionGemma 在 NVIDIA H100 上每秒生成 1000+ tokens,速度比传统模型快 4 倍。
决策模型成为AI新赛道,OpenAI、Perplexity等推出竞品,TypeSafe/Jev以100M ARR验证市场潜力。
入选理由:OpenAI Decisions API单次请求成本0.10美元/百万输入token,速度提升10倍