#568. Transformer辩论:如何理解下一代智能之争
跨国串门儿计划2874 字 (约 12 分钟)
90
Transformer 架构虽仍主导当前 AI 发展,但其局限性促使 postTransformer 路径探索;未来智能可能来自混合架构与更高效推理机制,而非单一范式。
入选理由:Transformer 是目前最强的可扩展模型,但并非智能的终极答案
精选播客#Transformer#AI 架构#大语言模型#AGI#Post-Transformer中文
模型
别名:transformer model
基于自注意力机制的深度学习模型架构
已跟踪 30 条高相关材料
最近变化
2026-11-14 · AI研发效率在一年内可能压缩出4年进展,从GPT-3.5到GPT-6仅需12个月。
为什么值得关注
Transformer 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
#568. Transformer辩论:如何理解下一代智能之争
跨国串门儿计划 · 9 分
Transformer 架构虽仍主导当前 AI 发展,但其局限性促使 postTransformer 路径探索;未来智能可能来自混合架构与更高效推理机制,而非单一范式。
Apple presents TIDE Every Layer Knows the Token Beneath the Context paper: https://t.co/fVdyf8ySks
AK(@_akhaliq) · 9 分
Apple发布TIDE模型,提出‘每一层都知晓上下文下的token’的创新架构,通过动态上下文感知机制显著提升长序列建模能力,为大模型在端侧部署提供新范式。
AI Paper Review: Improving Language Understanding by Generative Pre-Training (GPT-1)
freeCodeCamp.org · 8.7 分
GPT-1 提出通过无监督生成式预训练加任务微调的两阶段方法,显著提升自然语言理解能力,奠定大模型发展基础。
已收录 30 条与 Transformer 相关的内容,按评分排序。
Transformer 架构虽仍主导当前 AI 发展,但其局限性促使 postTransformer 路径探索;未来智能可能来自混合架构与更高效推理机制,而非单一范式。
入选理由:Transformer 是目前最强的可扩展模型,但并非智能的终极答案
Apple发布TIDE模型,通过分层上下文感知机制,显著提升长序列建模能力,推理延迟降低37%,内存占用减至45%。
入选理由:TIDE采用分层上下文感知机制,每层显式建模token与上下文关系。
GPT-1 提出通过无监督生成式预训练加任务微调的两阶段方法,显著提升自然语言理解能力,奠定大模型发展基础。
入选理由:GPT-1 采用无监督预训练与有监督微调结合的两阶段范式,提升多任务NLP性能。
AI研究自动化可能在两年内达到顶尖水平,效率提升显著,算力增长推动研究员agent数量激增。
入选理由:AI研发效率在一年内可能压缩出4年进展,从GPT-3.5到GPT-6仅需12个月。
权重仅量化技术通过减少模型权重的存储和计算需求,显著提升推理效率,尤其适用于Transformer模型。
入选理由:权重仅量化可将FP16权重存储减少一半,例如INT8权重。
操作融合与快速注意力内核可提升Transformer推理性能,vLLM和CUDA图是关键实现手段。
入选理由:操作融合可减少30%以上的内核启动次数和内存流量
NVIDIA推出Déjà View模型,通过循环单个Transformer块实现高效3D重建,117M参数在五项基准测试中超越10倍规模模型。
入选理由:循环单个Transformer块实现10倍模型性能,参数量仅117M
本文揭示了门控机制在状态空间模型(SSMs)中对记忆学习和上下文学习的双重影响,解释了其在长序列任务中的性能瓶颈。
入选理由:SSMs的门控机制导致优先记忆学习,延迟上下文学习收敛
微软非洲实验室研究揭示:模型架构、语言类型学与适应策略对非洲语言语音识别性能有显著影响,评估了53个模型在39种语言中的表现。
入选理由:低资源语言语音识别需针对性优化数据收集形式与模型架构
不同注意力机制对模型推理内存需求影响显著,选择合适变体可优化服务容量。
入选理由:MHA与GQA的KV缓存需求差异可达300%(基于参数量相同模型)
斯坦福AI实验室提出Joules-to-GDP(J2G)框架,量化AI计算的能源经济价值。
入选理由:J2G框架通过任务/模型/硬件三维度评估AI能源效率
意识可能被建模为类似Transformer的算法,通过自我训练实现,且LLM可能在特定状态表现出类似意识的自我报告。
入选理由:意识可能被建模为类似Transformer的算法,通过自我训练实现。
从记忆角度解析Transformer结构,揭示线性层、MLP和自注意力机制的存储与回忆能力差异。
入选理由:线性层存储容量约64条记忆,MLP提升至2700条,自注意力可达百万级。
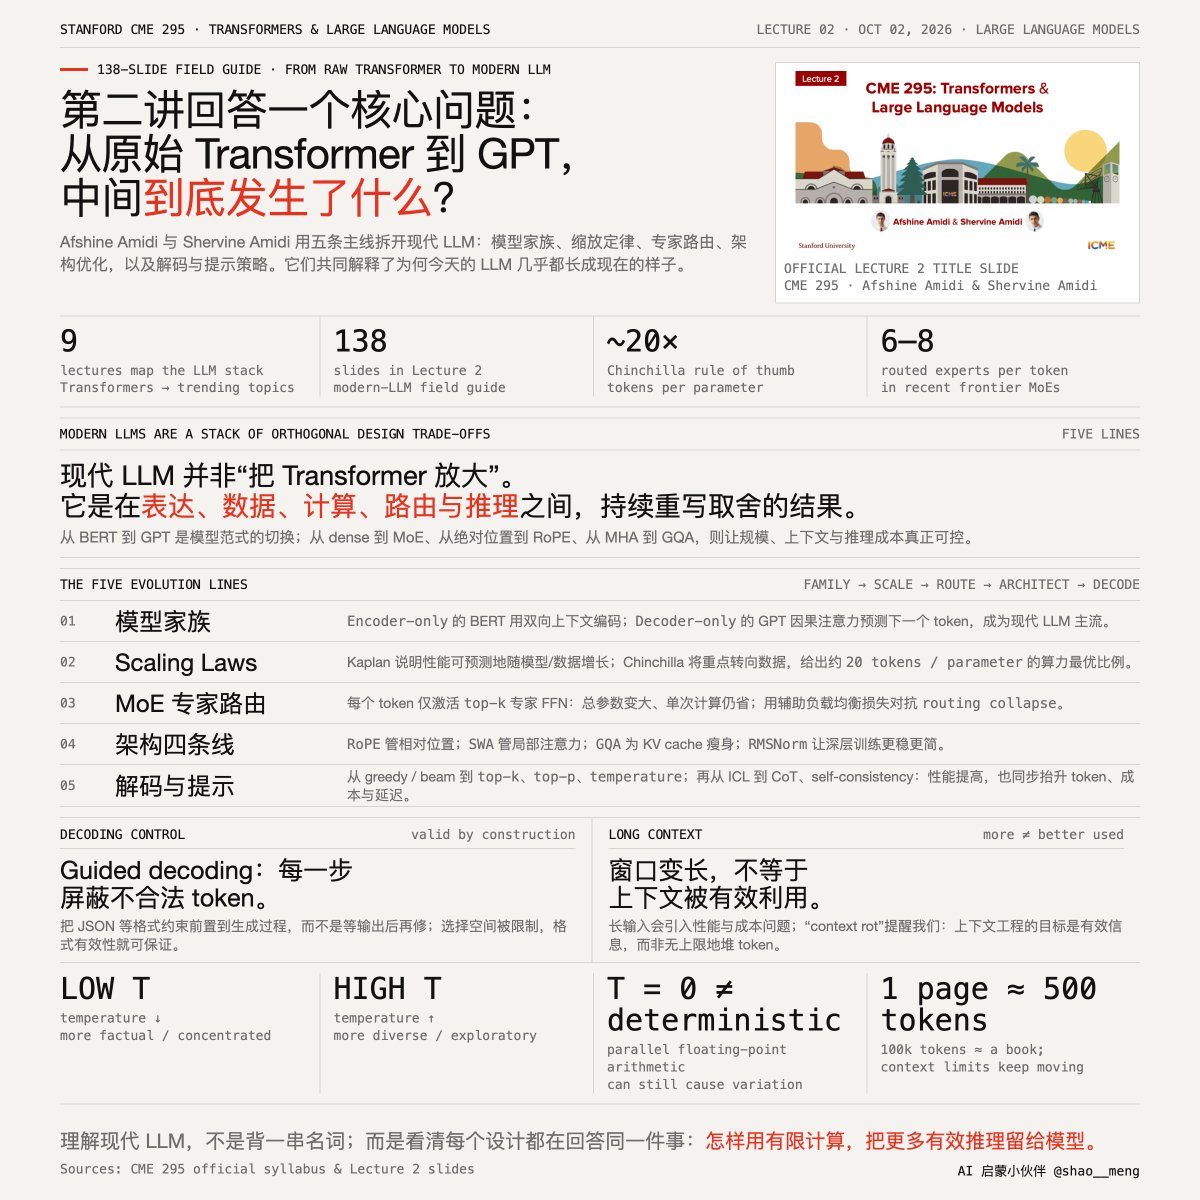
斯坦福LLM课程系统解析Transformer演进与大模型优化技术,覆盖从架构到训练的完整知识体系。
入选理由:现代LLM几乎全部采用Decoder-only架构(如GPT、Qwen)
NVIDIA Kumo Tabular模型在表格预测任务中实现高准确率与效率,无需训练和特征工程,四个基准测试排名第一。
入选理由:Kumo Tabular在TabArena/BeyondArena/TALENT/ScoringBench四大赛道均排名第一
扩散模型在推理时的并行处理优势使其成为未来LLM的潜在方向,相比Transformer的顺序生成更高效。
入选理由:Transformer推理需顺序生成,导致内存瓶颈,扩散模型可并行处理
Loop Transformers通过循环激活值实现双倍推理,但牺牲了监控性。Meta的CoCoNet论文提出该架构,使模型在潜在空间而非输出token上进行更多推理。
入选理由:Loop Transformers使模型在每次token生成时进行两次推理,提升潜在空间推理能力
AI芯片初创公司面临资本、供应链和技术三重挑战,行业竞争将长期激烈。
入选理由:AI芯片研发需至少3-5年才能突破供应链限制
微软研究员Lester Mai提出通过分布压缩优化Transformer注意力模块,降低计算成本并提升长序列处理效率。
入选理由:注意力模块计算成本随序列长度平方增长,成为性能瓶颈
开源可能无法完全防止AI权力集中,但未来技术突破可能改变现状。当前算力和数据需求导致大公司主导,但小型专用模型或成新趋势。
入选理由:Transformer架构的高算力需求加剧了AI权力集中,但未来可能转向小型专用模型
本文揭示了三种有效缩小语言模型规模而不显著影响性能的技术,包括参数量化、路径修剪和行为模仿,解决了大模型部署的硬件瓶颈问题。
入选理由:700亿参数模型需140GB显存,而消费级显卡仅支持24-48GB
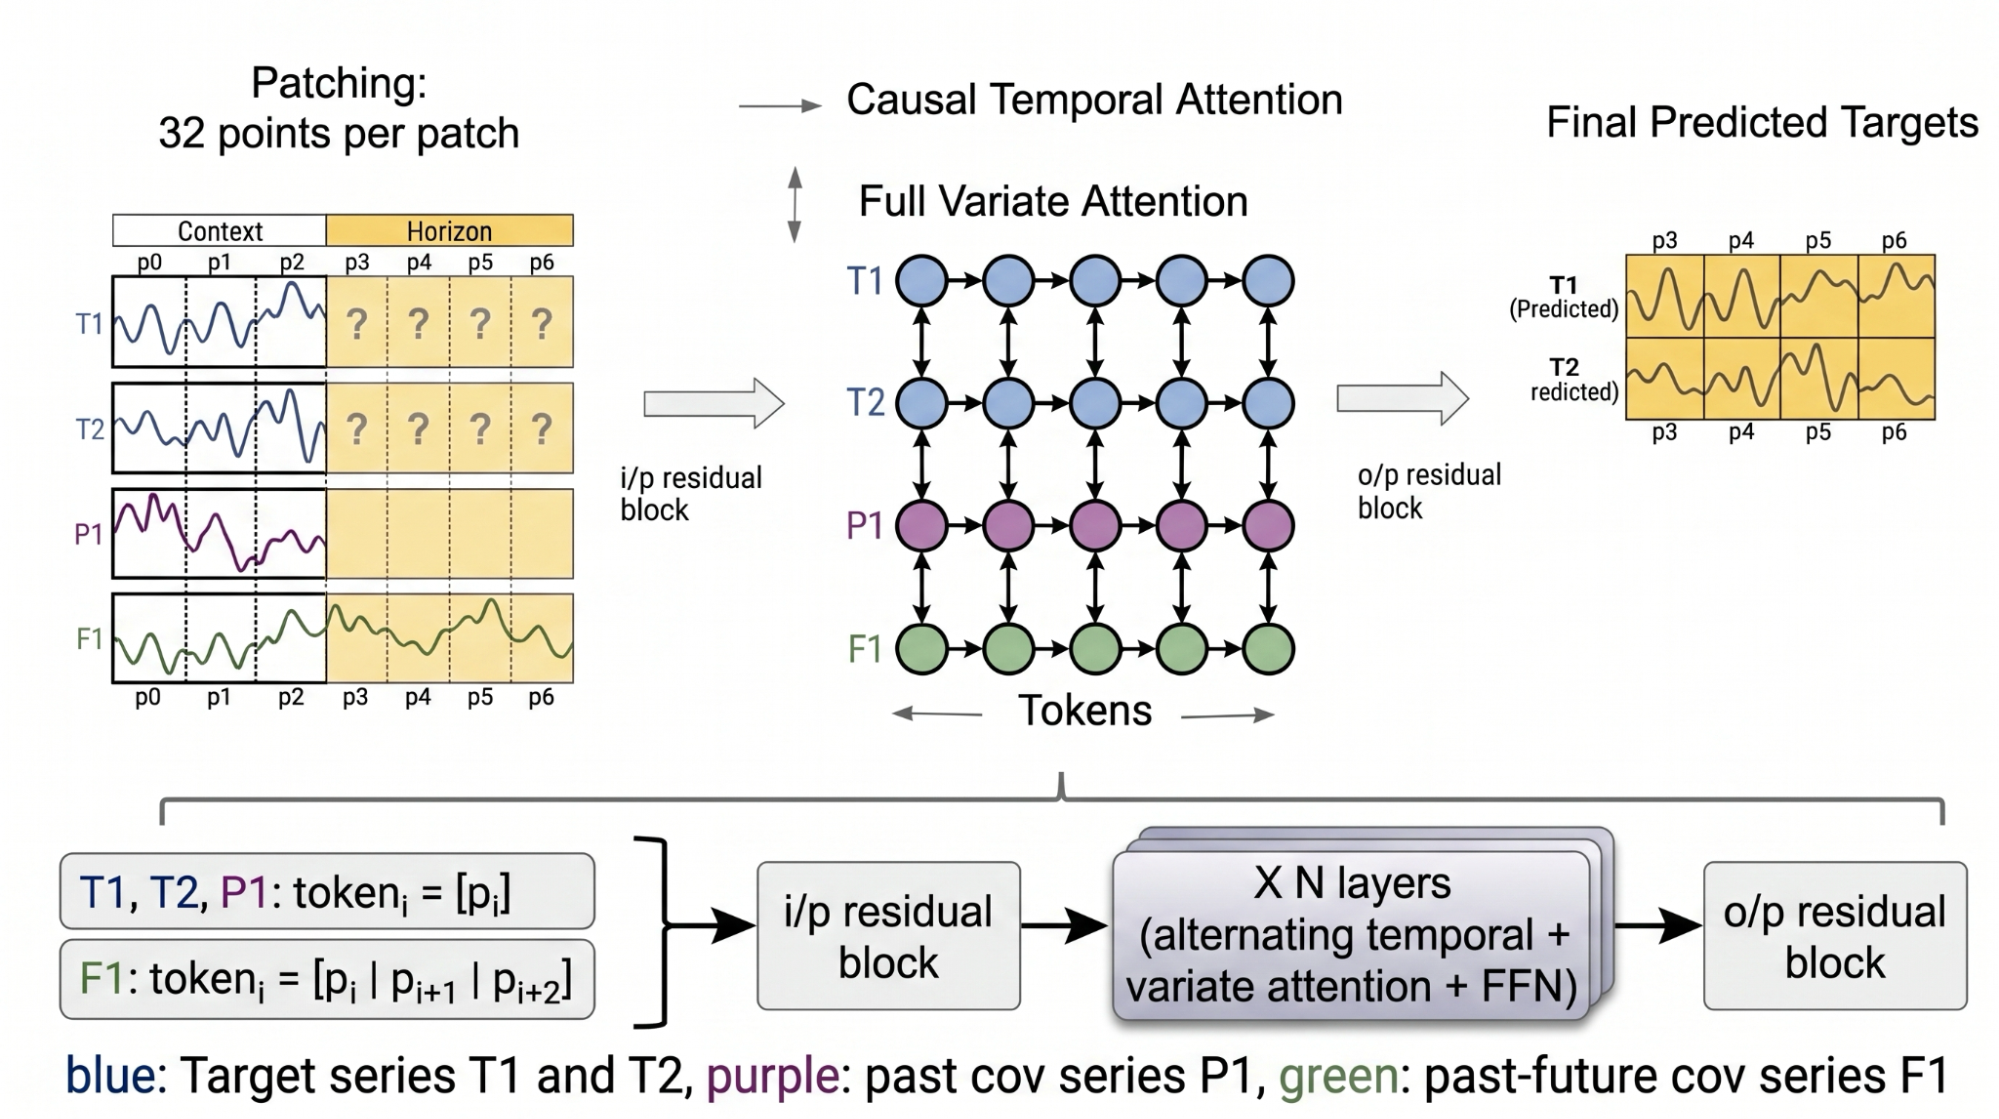
Google推出TimesFM-3,首个支持多变量零样本预测的时序模型,在多个基准测试中显著超越现有方法。
入选理由:TimesFM-3参数量330亿,预训练数据覆盖1万亿时间点
Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。
入选理由:自回归生成需逐个生成token,依赖前序所有输出
本文系统解析Transformer模型生成文本的六大核心解码策略,揭示不同算法对输出质量与多样性的影响机制。
入选理由:贪婪解码保证输出稳定性但可能牺牲多样性
斯坦福团队提出无需梯度下降的Transformer知识嵌入方法,通过闭合形式MLP实现事实存储,已被COLM 2026接收。
入选理由:闭合形式MLP可直接嵌入Transformer块,无需梯度下降训练
苹果提出VICIS任务,解决视觉语言模型从图像集合推断概念的难题,新框架在ImageNet数据上实现更准确的生成。
入选理由:VICIS任务要求模型从图像集合中推断概念并生成新图像
Transformer架构革新神经机器翻译,结合QVAC与React Native实现翻译应用开发。
入选理由:Transformer通过自注意力机制解决长句翻译中的记忆丢失问题
大语言模型和小语言模型在硬件、训练方式和应用场景上存在显著差异,影响工程实践和技术选型。
入选理由:大语言模型通常拥有数十亿到数百亿参数,而小模型参数范围在0.5亿到14亿之间。
混合模型在处理有意义的词汇时表现优于Transformer,但在重复输入时表现较差。
入选理由:混合模型在名词、动词和形容词等有意义的词汇上表现更优。
谷歌AI核心人才接连流失,AlphaFold之父John Jumper加入Anthropic,Transformer作者Noam Shazeer加入OpenAI。
入选理由:AlphaFold之父John Jumper加入Anthropic,可能推动生命科学领域AI应用。