DeepSeek 不限额的用法,都在这里了 | 附指南
爱范儿3134 字 (约 13 分钟)
85
DeepSeek 通过 API 调用和官方工具可绕过免费额度限制,但需付费使用。文章详解了 API 调用方法、费用计算及官方替代方案。
入选理由:使用 DeepSeek API 需充值,50 元约支持 300 次深度提问
精选文章#DeepSeek#API#AI#技术指南中文
概念
别名:idempotency token
语言模型处理的基本单位
已跟踪 30 条高相关材料
最近变化
2026-11-17 · 使用 DeepSeek API 需充值,50 元约支持 300 次深度提问
为什么值得关注
token 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
DeepSeek 不限额的用法,都在这里了 | 附指南
爱范儿 · 8.5 分
DeepSeek 通过 API 调用和官方工具可绕过免费额度限制,但需付费使用。文章详解了 API 调用方法、费用计算及官方替代方案。
绿电进Token出!联想重新定义词元工厂
量子位 · 8.5 分
联想在河北张家口建设年产2000万亿Token的混合词元工厂,通过绿电与算力协同,降低企业AI使用成本。
Gemini 4 Carbon 写作确实牛逼 让它总结了 Next Token 过去 9 期 30 条 AI 领域的核心认知: 1. Token 就是新货币;买一台本地机器跑模型,本质上是在家里铸...
歸藏(guizang.ai)(@op7418) · 8.5 分
Token 成为 AI 时代的新货币,AI 应用需围绕 Token 经济设计,同时强调信任与个人品牌的重要性。
已收录 30 条与 token 相关的内容,按评分排序。
DeepSeek 通过 API 调用和官方工具可绕过免费额度限制,但需付费使用。文章详解了 API 调用方法、费用计算及官方替代方案。
入选理由:使用 DeepSeek API 需充值,50 元约支持 300 次深度提问
联想在河北张家口建设年产2000万亿Token的混合词元工厂,通过绿电与算力协同,降低企业AI使用成本。
入选理由:联想计划在张家口建设年产2000万亿Token的混合词元工厂。
Token 成为 AI 时代的新货币,AI 应用需围绕 Token 经济设计,同时强调信任与个人品牌的重要性。
入选理由:Token 是 AI 时代的新货币,本地运行模型相当于在家铸币。
选择合适模型而非盲目使用最大模型可降低token消耗,Sonnet模型能显著减少成本。
入选理由:运行最重模型会快速消耗API额度,建议优先使用Sonnet模型
Vercel Workflow SDK 新增原子化 start() 函数,通过 token 实现幂等性,消除工作流重复启动问题。
入选理由:原子化 start() 函数合并了 run 和 claim hook 操作,消除 duplicate-start race 条件
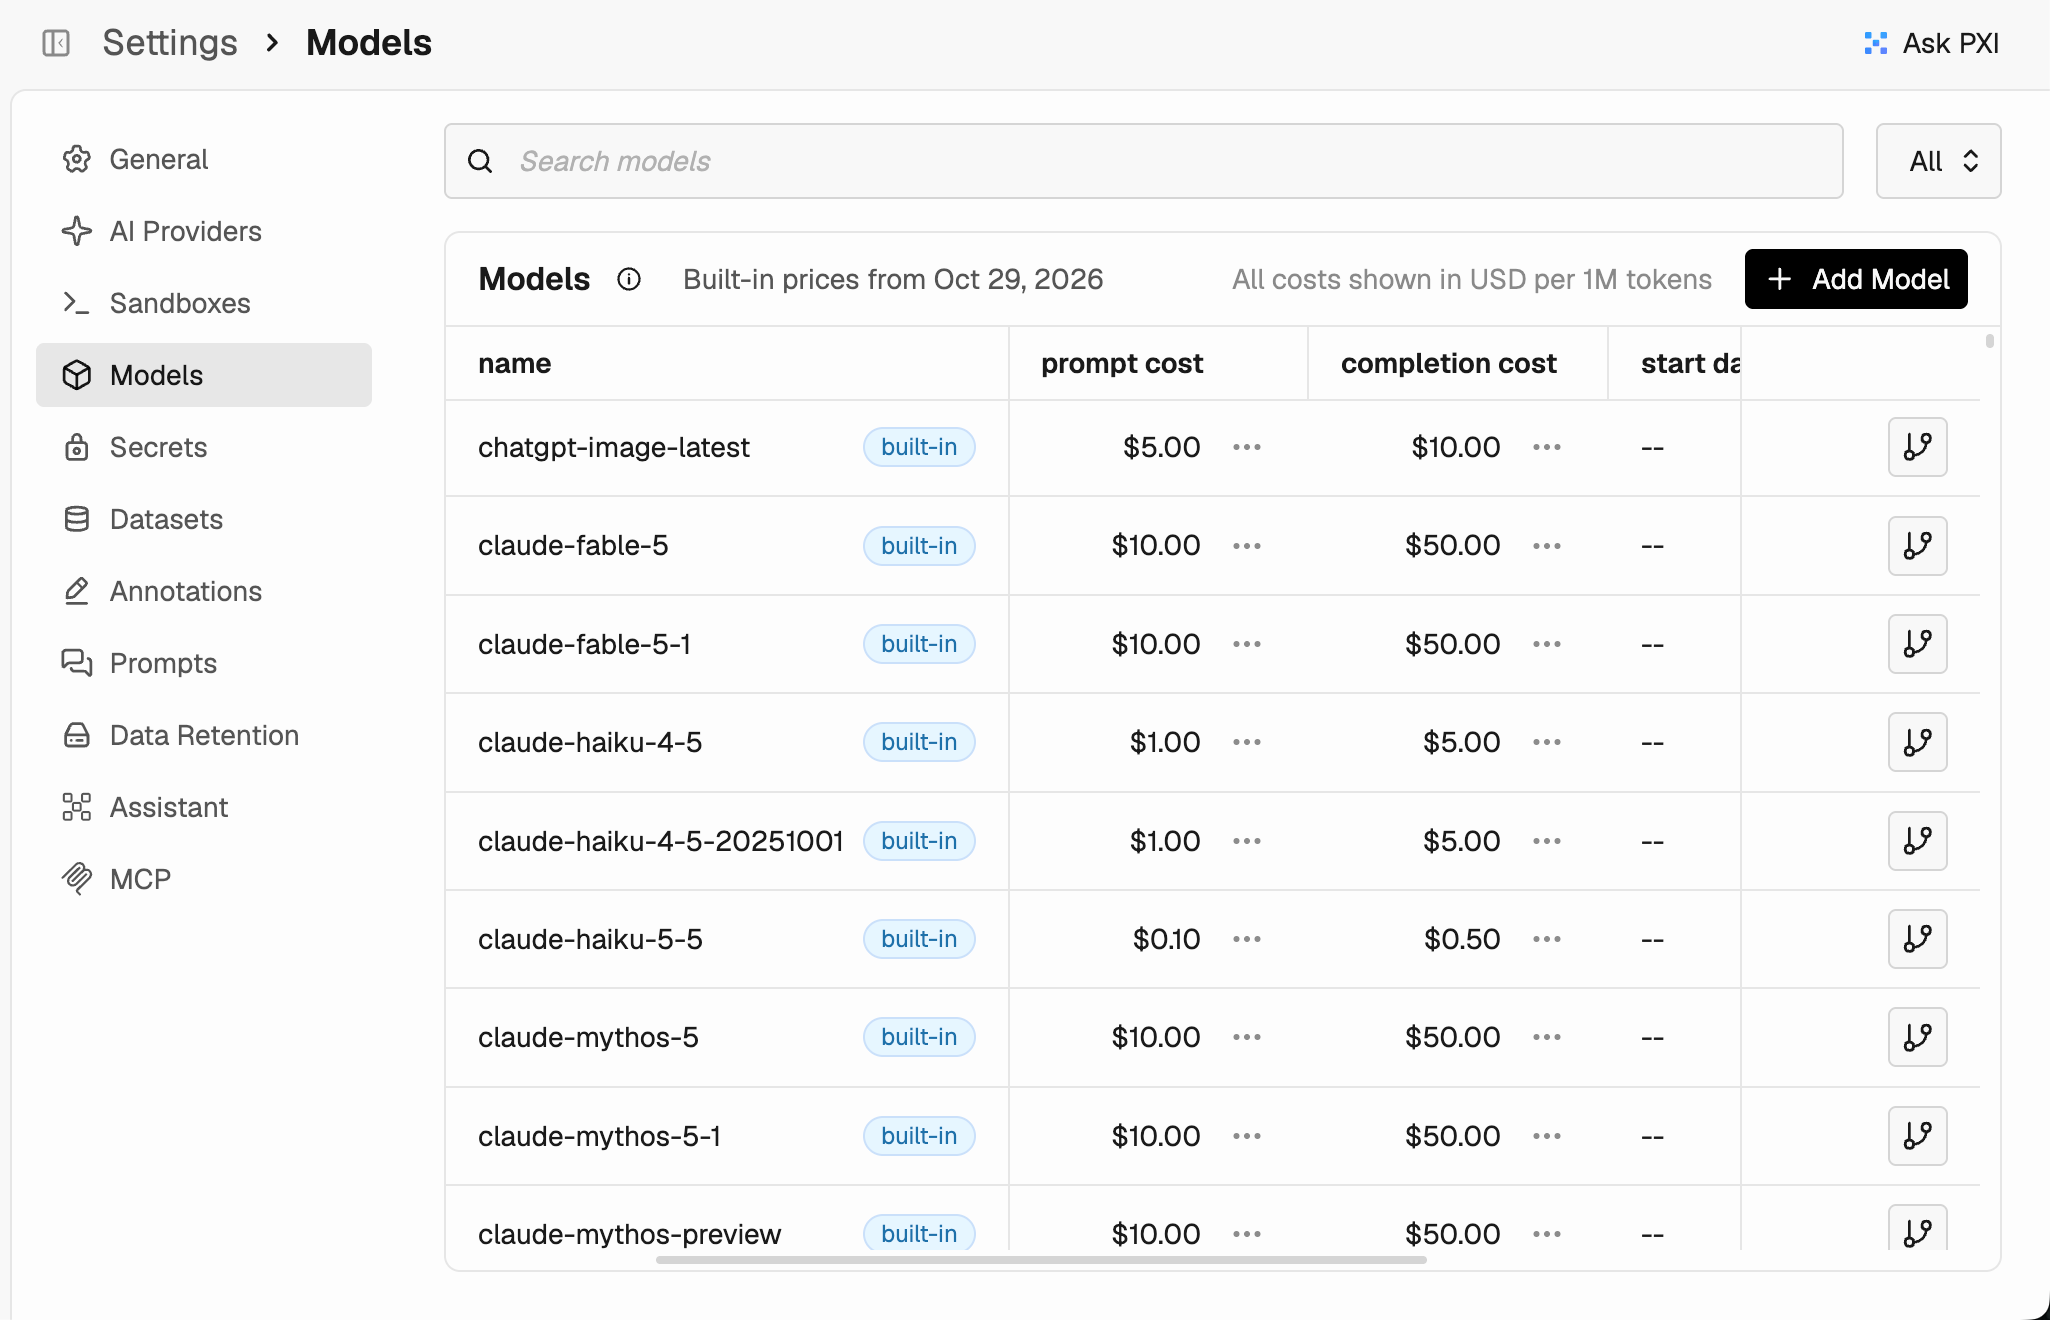
Arize Phoenix实现模型价格自动更新,无需人工干预即可同步最新LLM计费标准,提升成本管理效率。
入选理由:Phoenix通过GitHub每日自动下载LiteLLM价格目录更新模型费率
思科计划用AI重构98%的遗留代码,27岁员工Paddy将负责,不限量使用AI资源。
入选理由:思科计划用AI在24个月内重构98%的遗留代码
llm-echo 0.5更新了模拟token使用计数,支持工具调用和系统提示,提供LLM调试新功能。
入选理由:5版本新增工具调用、系统提示的token计数模拟
Subagent缓存过期导致Claude Code中token消耗激增,需立即调整设置以节省成本。
入选理由:Subagent闲置超5分钟会丢失prompt缓存,导致上下文重写
SerpApi通过Markdown格式减少AI搜索结果处理的74% token消耗,显著提升模型效率并降低成本。
入选理由:使用Markdown格式可将搜索结果token消耗从24,723降至6,435(减少74%)
AI按token计费的模式存在本质缺陷,模型性能提升使单位token的计算能力呈指数级增长,需重新定义有效计算单位。
入选理由:当前token计费模式与模型实际推理效率存在数量级差异
Google推出Gemini 3.8 Flash模型,专为复杂任务和多步骤代理设计,提升推理与视频理解能力。
入选理由:Gemini 3.8 Flash支持复杂代理任务,提升推理效率。
GPT-6可自动构建多GB个人知识库并生成每日摘要,但存在隐私风险和潜在高额成本。
入选理由:GPT-6能在5天内自动构建多吉字节个人维基知识库
Google DeepMind推出Gemini模型的agentic视频理解功能,可减少88%的token消耗,降低成本66%,并提升7%准确性。
入选理由:agentic视频理解减少88%token消耗,降低成本66%
跨模型的token指标无意义,不同模型的token无法比较,尤其随着模型多样化和推理占比增加,这一问题更加显著。
入选理由:跨模型token指标无法有效比较,因模型间token生成方式差异显著。
通过四策略优化多智能体AI的token使用,显著降低计算成本。静态缓存、语义复用、工具响应缓存和动态指令调整可减少30%-50%的token消耗。
入选理由:静态指令缓存可减少重复处理,节省40%的token成本
Firecrawl推出的新搜索模型在SimpleQA上达到SOTA,使用10倍更少的token,现已免费提供。
入选理由:新模型在SimpleQA基准测试中达到SOTA性能,同时减少90%的token消耗
优化AI使用中的token选择可显著降低成本并提高效果,需根据任务类型匹配不同token组合。
入选理由:GPT-5.6 Soul输出token成本达$30/百万,而Kimmy仅需$15/百万
Token是AI模型处理信息的基本单位,但并非等同于单个单词,其管理直接影响模型性能。
入选理由:单个单词可能被拆分为多个token(如'unbelievable'→'un'+'believe'+'able')
电力具有同质性,而 token 具有异质性,这种差异导致 token 更易形成供给瓶颈。
入选理由:电力是同质性的,不同电厂的一度电价值相同。
Cursor推出新功能,允许工程师通过交互式画布可视化代理上下文token使用情况,显著提升代理性能优化能力。
入选理由:Cursor新增上下文探索器功能,可实时展示token在系统提示、工具定义等模块的分配情况
韩歆毅分享了智能体时代经济和商业的新逻辑,指出过去的网络效应和流量逻辑失效,新的信任机制基于结果交付,Token将成为价值的新载体,AI支付是未来的重要基础设施。
入选理由:智能体时代网络效应和流量逻辑失效,新的信任机制基于结果交付。
王建硕认为屎山代码无需治理,应通过自然语言层进行管理,AI可以自动处理用户反馈并自我进化。
入选理由:屎山代码无需治理,只需确保代码意图清晰。
上海电信推出Token话费套餐,1元=25万token,支持30+主流大模型调用。
入选理由:上海电信推出Token话费套餐,1元=25万token。
Amazon强制要求80%开发者使用AI并追踪Token消耗,导致员工用MeshClaw工具刷数据。这种tokenmaxxing现象反映硅谷大厂在2000亿美元AI投资下的回报焦虑,也暴露了AI Agent工具的安全风险。
入选理由:Amazon要求每周80%开发者使用AI工具,内部排行榜追踪Token消耗
分享Sendbird CEO的AI采用策略,包括内部工具产品化、非技术人员赋能等。
入选理由:构建‘Automators’平台提升AI采用率
方汉在AIGC2026峰会上提出,AI时代经验不再是护城河,Token消耗量成为衡量AI实力的新指标。
入选理由:Token消耗量正成为AI时代新的硬核实力指标,普通用户与重度用户差距可达数个数量级。
Claude Code中Subagent缓存5分钟后失效,导致重复处理消耗更多token。
入选理由:Subagent闲置超5分钟会丢失提示缓存
文章将 Agent 比作 3D 打印机,Token 比作虚拟世界 3D 打印机的 PLA 材料,强调通用性与多样性。
入选理由:Agent 类似于 3D 打印机,可以根据不同需求生成多样化结果。
视频揭示使用 Claude 时因不当操作导致额度快速耗尽的问题,提出分段请求与流式输出等优化策略。
入选理由:单次请求过长文本会导致上下文浪费,建议控制在 2048 token 内。