T
traeai
登录

公司

Together AI

别名:together.ai

提供开源模型推理服务的AI公司,提出多态推理概念

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 Together AI 相关的内容,按评分排序。

Serving MiniMax-M3 for efficient inference: Unlocking 1M-Token Context and Multimodality Without Regrets

高效推理MiniMax-M3:解锁1M令牌上下文和多模态能力

Together AI Blog1686 字 (约 7 分钟)
87

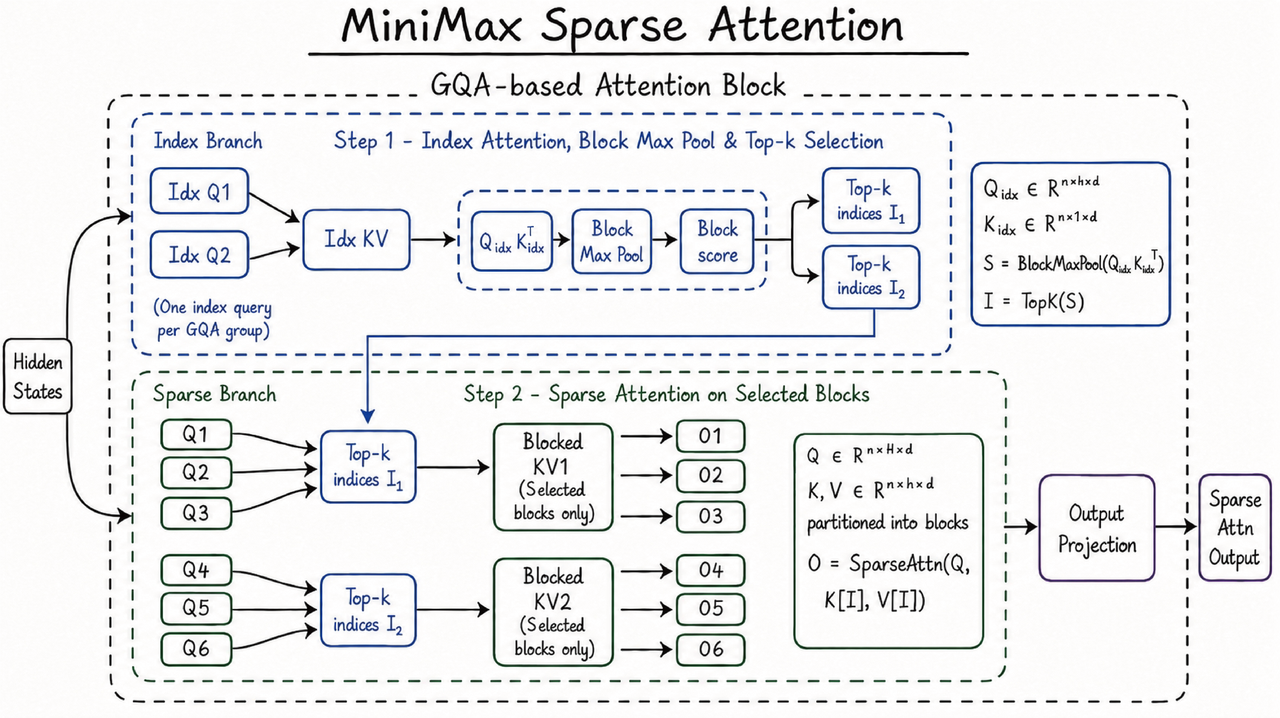
Together AI优化了MiniMax M3模型的部署,通过架构和工程创新实现81–125%吞吐量提升。

入选理由:MiniMax M3 supports 1M-token context and native multimodality, making it suitable for complex real-world tasks.

精选文章#MiniMax#M3#稀疏注意力#多模态#推理优化英文
Together AI Blog 图标

How we make Together AI easy for coding agents to use

Together AI Blog2673 字 (约 11 分钟)
85

Together AI 通过运行代理评估来优化平台对编码代理的易用性,发现并解决了多个关键问题,提升了开发者体验。

入选理由:Together AI 通过代理评估发现平台对代理的易用性存在障碍。

精选文章#Together AI#代理评估#开发者体验#API#CLI英文
Together AI Blog 图标

Making open models work for long-horizon agentic workloads

Together AI Blog2909 字 (约 12 分钟)
85

长周期智能体工作负载需要优化模型推理效率,Together AI 和 Ollama 提出通过前缀缓存减少重复计算。

入选理由:智能体每次请求都需发送完整对话历史,导致推理效率下降。

精选文章#AI#模型优化#推理效率#缓存机制英文
Together AI Blog 图标

Together AI 通过删除 megakernels 并采用新方法,实现了接近甚至超越原有性能的推理优化框架 Together Compiler。

入选理由:使用 CUDA Graphs 和 PDL 可恢复 98% 的 megakernel 性能,无需编写任何内核。

精选文章#AI#编译器#Torch#CUDA#推理优化英文
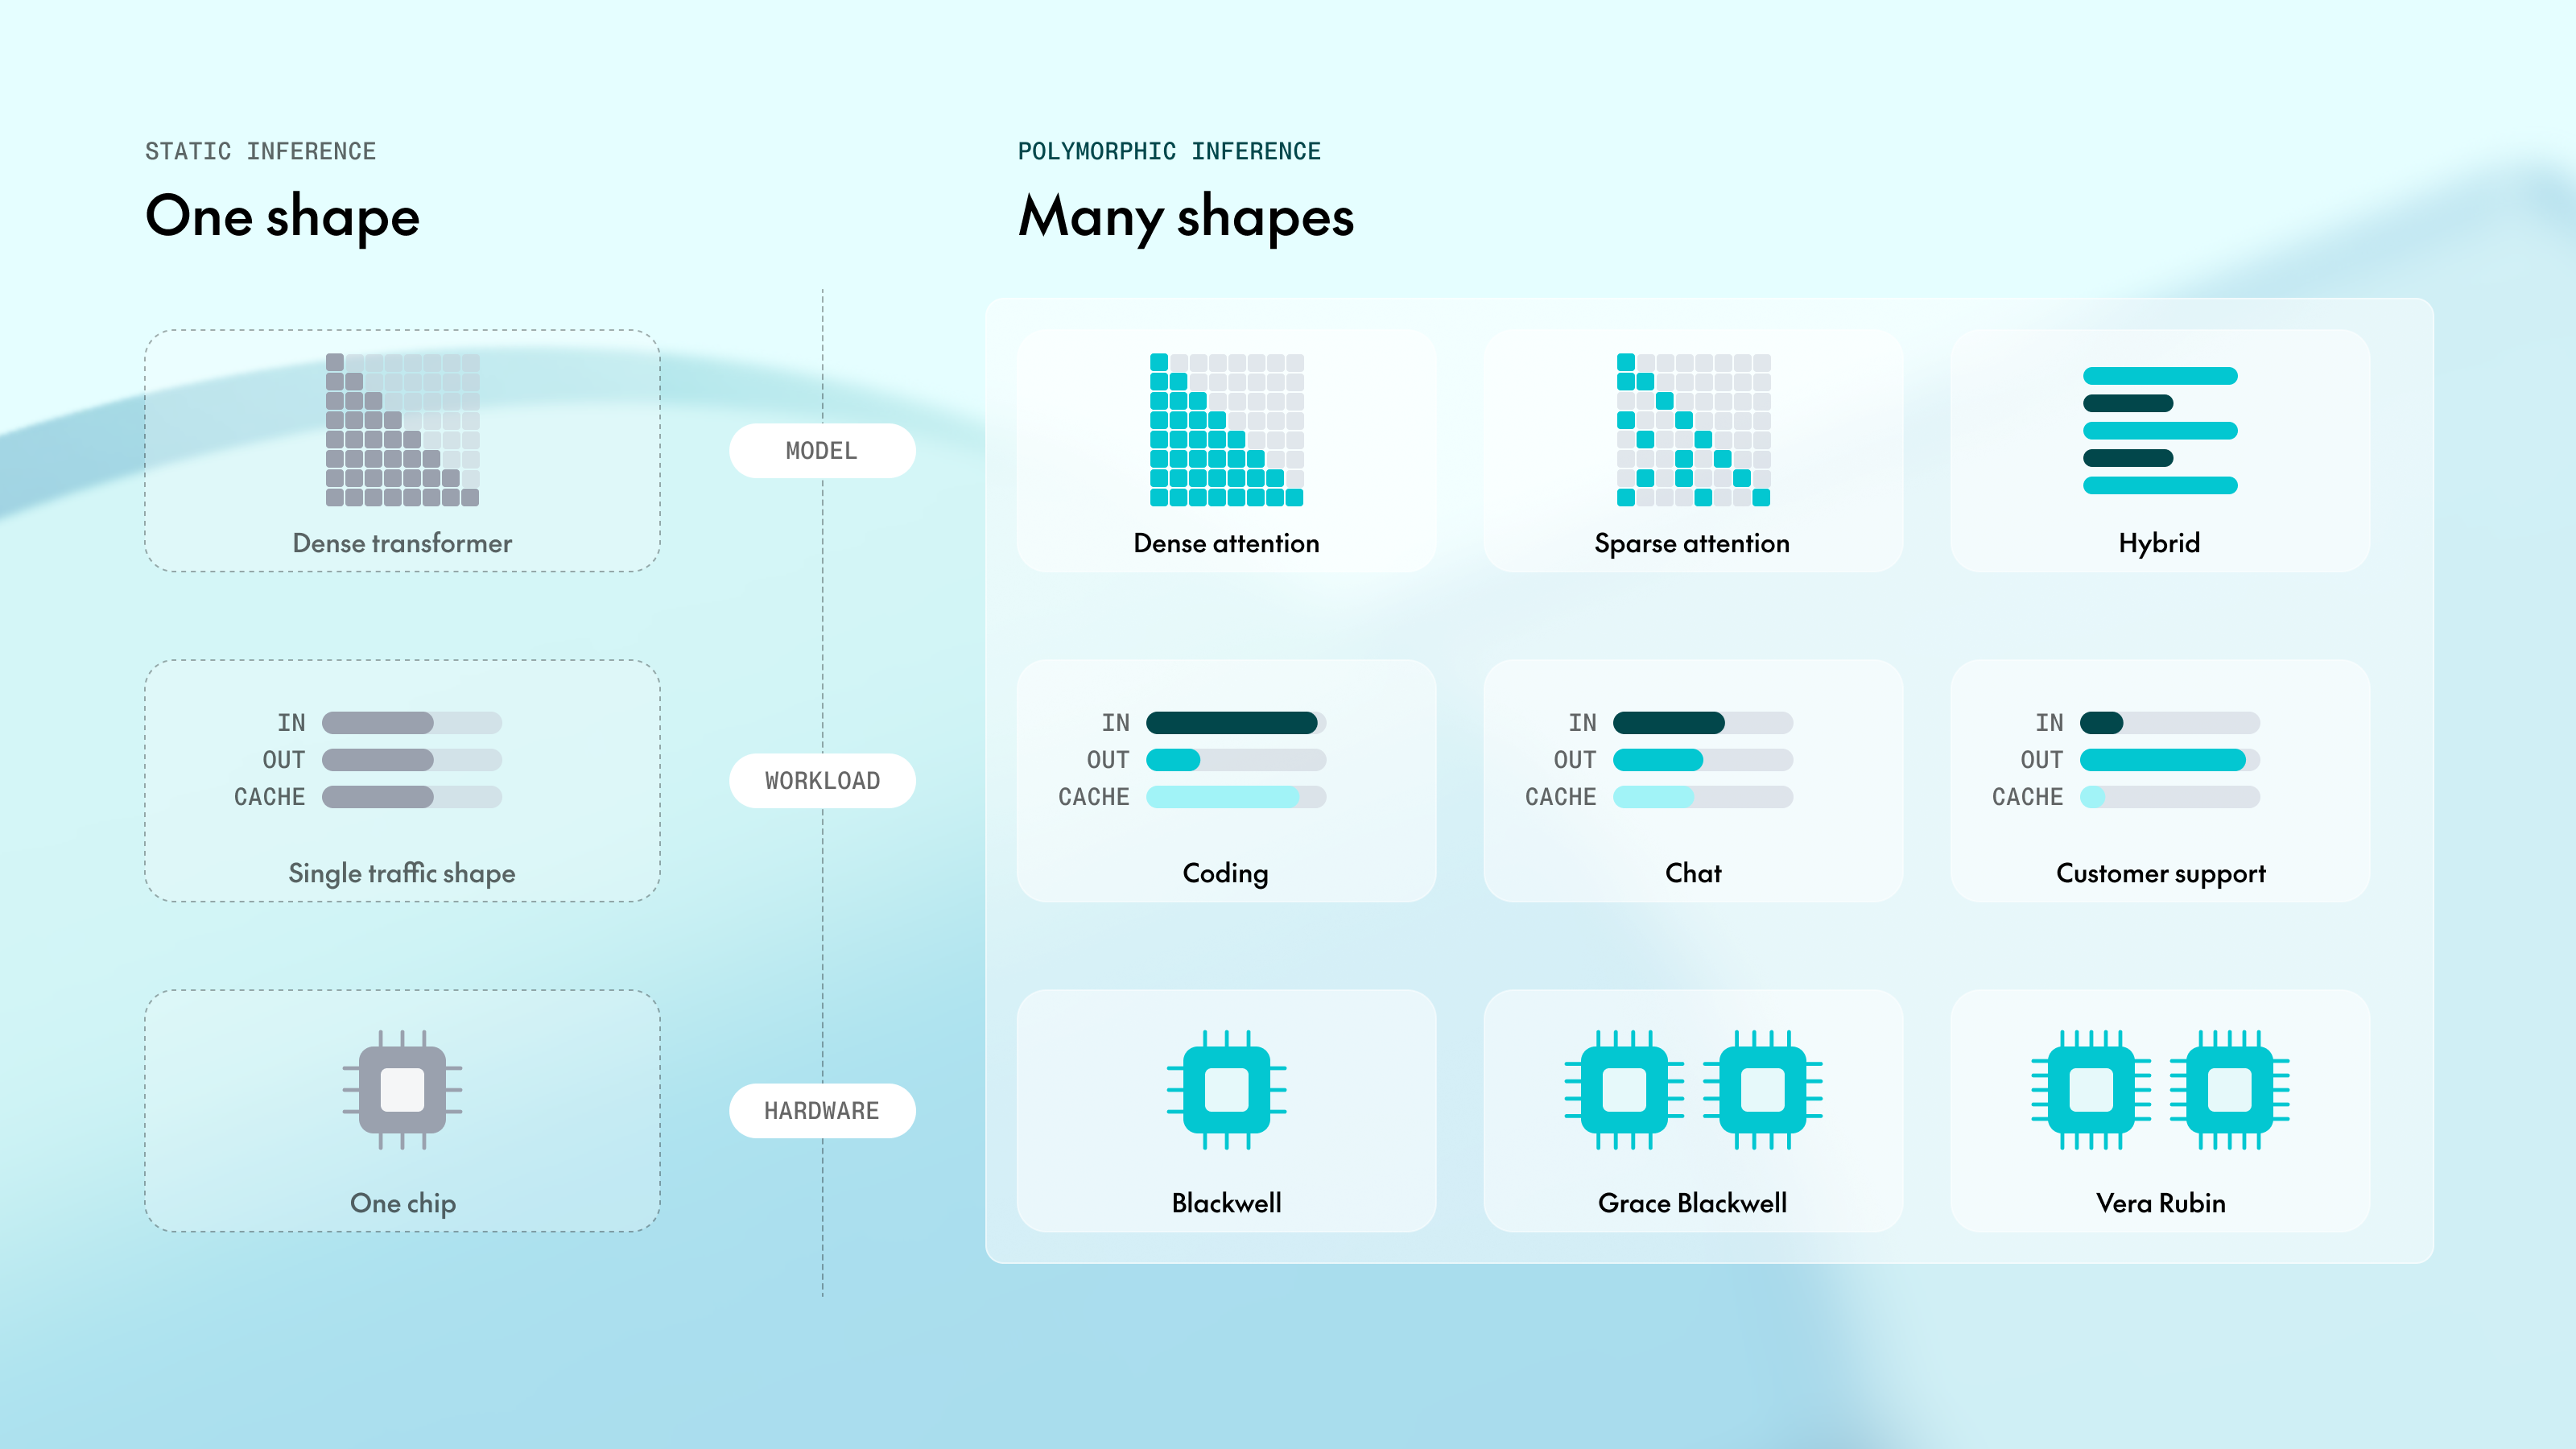
Polymorphic Inference: self-tuning inference for open models

Polymorphic Inference: self-tuning inference for open models

Together AI Blog1730 字 (约 7 分钟)
85

多态推理通过动态适应模型架构和硬件变化,解决开源模型爆炸式增长带来的部署挑战,Together AI提出持续编译技术实现自动优化。

入选理由:80%的OpenRouter流量来自近三个月发布的模型,凸显模型迭代速度挑战

精选文章#Polymorphic Inference#AI推理#Together AI#持续编译英文
Together AI Blog 图标

Together Compiler: Continuous Compilation for AI inference

Together AI Blog1438 字 (约 6 分钟)
85

Together Compiler(TKCC)通过持续编译优化AI推理,实现2.6倍TPS提升,适用于多模型、多硬件场景。

入选理由:TKCC在24小时内实现2.6倍TPS提升,覆盖Kimi K3等主流模型

精选文章#AI推理优化#持续编译#Together AI#大模型部署英文
Together AI Blog 图标

Auto repair for Together GPU Clusters: from GPU fault to healthy node

Together AI Blog2294 字 (约 10 分钟)
85

Together AI推出GPU集群自动修复系统,通过被动健康检查和智能决策实现故障节点快速恢复。

入选理由:自动修复系统包含被动健康检查、修复建议和策略配置

精选文章#GPU集群#自动修复#故障恢复#Together AI英文
Together AI Blog 图标

Together Post-Training: frontier-grade model shaping, the way that fits you

Together AI Blog1964 字 (约 8 分钟)
85

Together AI推出Post-Training服务,提供灵活高效的自定义模型训练,无需重基础设施负担。

入选理由:支持LoRA训练和全权重实验,提升模型灵活性

精选文章#AI模型训练#自定义模型#Together AI#RL#SFT英文
Together AI Blog 图标

Meta Muse Spark Open is live on Together AI

Together AI Blog533 字 (约 3 分钟)
85

Meta Muse Spark Open模型在Together AI上线,支持1M-token上下文和多模态输入,适用于复杂代码重构场景。

入选理由:Muse Spark Open具备1M-token上下文窗口,可处理完整项目代码库

精选文章#Meta#Muse Spark Open#Together AI#模型#AI英文
Together AI Blog 图标

Expanding our enterprise inference capacity with IBM Cloud and NVIDIA

Together AI Blog341 字 (约 2 分钟)
85

Together AI联合IBM和NVIDIA构建全球最大规模NVIDIA B300 GPU推理集群,实现企业级AI推理能力突破。

入选理由:NVIDIA B300 GPU集群首次部署于IBM Cloud,支持万亿级token月处理量

精选文章#AI推理#IBM Cloud#NVIDIA B300#企业级AI英文
Together AI Blog 图标

The Open Source AI Stack

Together AI Blog3158 字 (约 13 分钟)
85

开源AI堆栈包含模型、推理、网关、Harness和工具五层,开发者可灵活切换模型并优化成本与性能。

入选理由:MIGHT堆栈各层独立,允许快速替换模型以适应不同任务需求。

精选文章#AI#开源#模型#架构#开发英文
Together AI Blog 图标

Introducing preemptible compute: the same compute, half the price

Together AI Blog905 字 (约 4 分钟)
85

Together AI推出预占式计算,以一半价格提供相同GPU资源,适用于中断容忍型任务。

入选理由:预占式节点按50%按需价格计费且支持亚小时计费

精选文章#Kubernetes#GPU计算#成本优化#云服务英文
Together AI Blog 图标

GLM-5.3 vs. Claude Fable 5 on DeepSWE: Cost, Coding, and Routing

Together AI Blog2243 字 (约 9 分钟)
85

GLM-5.3在DeepSWE基准测试中成本仅为Claude Fable 5的1/5,且在多尝试指标上表现更优。

入选理由:GLM-5.3每任务成本为$3.99,Claude Fable 5为$21.63,成本差距达5.4倍。

精选文章#GLM-5.3#Claude Fable 5#DeepSWE#模型比较英文
Together AI Blog 图标

GLM-5.3 vs. GPT-5.6 Sol on DeepSWE: Cost, Coding, and Routing

Together AI Blog2192 字 (约 9 分钟)
85

GLM-5.3在多次尝试下表现优于GPT-5.6 Sol,且成本更低,但单次尝试中GPT-5.6 Sol稍胜一筹。组合使用可覆盖106/113任务,性价比达85.9%。

入选理由:GLM-5.3单次尝试成本3.99美元,解决率69.0%,GPT-5.6 Sol成本8.37美元,解决率72.7%

精选文章#GLM-5.3#GPT-5.6#DeepSWE#模型对比英文
Together AI Blog 图标

GLM-5.3 vs. GLM-5.3 Flash on DeepSWE: Cost, Coding, and Routing

Together AI Blog2838 字 (约 12 分钟)
85

GLM-5.3 Flash以1/17成本解决15倍任务,首次尝试性能落后5.6%但多次重试后差距缩小至2.6%。

入选理由:GLM-5.3 Flash成本为GLM-5.3的1/17,但每100美元解决任务数是其15倍。

精选文章#模型对比#GLM-5.3#DeepSWE#蒸馏模型英文
Together AI Blog 图标

DeepSeek-V4 Flash 0731 vs GPT-5.6 Luna on DeepSWE: Cost and Coding

Together AI Blog2024 字 (约 9 分钟)
85

DeepSeek-V4 Flash 0731成本仅为GPT-5.6 Luna的1/6,但组合使用时在准确率和成本上均优于单独使用Luna。

入选理由:GPT-5.6 Luna单次任务准确率67.2%,DeepSeek-V4 Flash为53.3%,但后者成本仅0.10美元/任务。

精选文章#模型比较#成本分析#AI#DeepSWE英文
Together AI Blog 图标

A/B test models in production

Together AI Blog1936 字 (约 8 分钟)
85

Together AI平台提供端点级A/B测试方案,通过动态流量分配验证LLM模型效果,避免传统方法的基础设施耦合问题。

入选理由:Together AI平台在端点层实现A/B测试,无需修改客户端代码

精选文章#A/B测试#LLM#生产环境#Together AI#技术实践英文
Together AI Blog 图标

DeepSeek V4 Pro 0813 vs Claude Fable 5 on DeepSWE: Cost, Coding, and Routing

Together AI Blog1837 字 (约 8 分钟)
85

组合使用DeepSeek V4 Pro 0813和Claude Fable 5可解决82.7%的DeepSWE任务,成本仅8.28美元,比单独使用Claude节省62%费用。

入选理由:DeepSeek V4 Pro 0813首次尝试解决62.8%任务,成本仅0.24美元/次

精选文章#DeepSeek V4 Pro 0813#Claude Fable 5#DeepSWE#模型比较#成本分析英文
Together AI Blog 图标

DeepSeek V4 Pro 0813 vs GPT-5.6 Sol on DeepSWE: Cost, Coding, and Routing

Together AI Blog1888 字 (约 8 分钟)
85

DeepSeek V4 Pro 0813成本仅为GPT-5.6 Sol的1/35,但多次尝试后表现更优,适合预算有限且允许重试的任务。

入选理由:DeepSeek V4 Pro 0813每轮成本0.24美元,GPT-5.6 Sol为8.37美元,价格差距达35倍。

精选文章#DeepSeek V4 Pro#GPT-5.6 Sol#DeepSWE#成本分析#模型对比英文
Together AI Blog 图标

ThunderAgent通过优化KV缓存管理,实现单节点吞吐量提升2倍,集群加速2.4倍,解决代理推理中的缓存抖动问题。

入选理由:单节点吞吐量提升2.5倍,P50延迟降低10倍

精选文章#ThunderAgent#合成数据生成#LLM推理优化#KV缓存管理英文
Together AI Blog 图标

Configuring Dedicated Model Inference

Together AI Blog1796 字 (约 8 分钟)
85

Together AI平台通过端点/部署/配置三元组与容量感知路由实现模型推理配置,支持零停机变更和流量实验。

入选理由:配置由端点(固定身份)、部署(模型+硬件组合)、配置(运行配方)三部分构成

精选文章#模型推理#部署配置#流量管理#AI平台英文
Together AI Blog 图标

Together AI与Moonshot AI合作推出2.8T参数开源模型Kimi K3,支持长上下文和视觉任务,开发者可直接通过其平台部署和微调。

入选理由:Kimi K3是当前参数规模最大的开源模型(2.8T),支持1M token上下文窗口。

精选文章#AI模型#开源#Moonshot AI#Together AI英文
Together AI Blog 图标

Autoscaling endpoints for LLM inference

Together AI Blog2237 字 (约 9 分钟)
85

Together AI平台通过自适应扩展端点,结合LLM推理特有的指标(如TTFT、GPU利用率),实现更高效的资源管理,减少过量和不足配置的成本。

入选理由:选择TTFT和GPU利用率作为指标可有效平衡资源成本

精选文章#LLM推理#自适应扩展#Together AI#GPU优化英文
Together AI Blog 图标

Kimi K3: The Complete Developer Guide

Together AI Blog3077 字 (约 13 分钟)
85

Kimi K3是首个2.8万亿参数开源模型,支持1M上下文和高效推理,适用于复杂编程与知识工作。

入选理由:Kimi K3参数量达2.8万亿,是首个3万亿参数级开源模型

精选文章#Kimi K3#开源模型#AI架构#Together AI英文
Together AI Blog 图标

Kimi K3 vs Claude Fable 5 on DeepSWE: Cost and Coding

Together AI Blog1176 字 (约 5 分钟)
85

Kimi K3在DeepSWE基准测试中以1/3成本超越Claude Fable 5,多次尝试后性能反超,但后者可靠性更高。

入选理由:Kimi K3单次任务成本仅4.65美元,为Claude Fable 5的1/3

精选文章#Kimi K3#Claude Fable 5#DeepSWE#模型比较英文
Together AI Blog 图标

What does 99.9% uptime mean for inference?

Together AI Blog1508 字 (约 7 分钟)
85

不同可靠性级别(99%、99.9%、99.99%)对应不同的故障域和架构要求,如99%需处理节点级故障,99.9%需跨数据中心部署,99.99%需多区域冗余。

入选理由:99%可靠性需处理GPU硬件故障,依赖自动化健康检查和快速替换

精选文章#AI推理#可靠性#架构设计#故障域#Together AI英文
Together AI Blog 图标

The production platform for open-weight AI inference

Together AI Blog1714 字 (约 7 分钟)
85

Together AI推出的新推理平台使用户能高效部署和管理开放权重模型,兼顾控制、成本与性能。

入选理由:开放权重模型成本仅为封闭模型的几分之一,但质量相当。

精选文章#AI推理平台#开放权重模型#模型部署#Together AI英文

跨材料问答 · Together AI

回答基于:Together AI 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容