T
traeai
登录

概念

RAG

别名:retrieval augmented generation

检索增强生成技术

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 RAG 相关的内容,按评分排序。

RAG Is Burning Money — I Built a Cost Control Layer to Fix It

RAG正在烧钱——我构建了一层成本控制机制来修复它

Towards Data Science4995 字 (约 20 分钟)
92

RAG系统在生产中常因上下文过取、无缓存、无模型路由导致成本激增;作者构建成本控制层,通过语义缓存(98.5%命中率)、查询路由(81%请求转向低成本模型)与令牌预算熔断机制,在10,000请求/日下实现85.8%成本削减且质量不变。

入选理由:上下文过取使每查询平均多消耗350 tokens,10k请求/日造成$52.5/日浪费(按$0.015/1K tokens计)

精选文章#RAG#成本优化#语义缓存#模型路由#LLM英文
Enterprise Document Intelligence: A Series on Building RAG Brick by Brick, from Minimal to Corpus scale

企业文档智能:从最小到语料库规模逐砖构建RAG系列

Towards Data Science5486 字 (约 22 分钟)
92

企业级RAG系统应聚焦文档理解与业务逻辑,而非堆叠模型和框架。简单的Python脚本往往比复杂生产系统更有效。

入选理由:多数企业RAG部署效果不佳,因基础解析和检索质量差。

精选文章#RAG#企业AI#文档智能#检索增强生成#LLM应用英文
Most people use vector databases for chatbots and RAG pipelines. 𝗦𝗲𝗻𝗾𝗶 𝗔𝗜 𝘂𝘀𝗲𝘀 ...

Senqi AI 使用 Milvus 向物理机器人注入长期语义记忆能力,解决真实世界任务中环境动态、任务无界、指令模糊和错误高成本等核心挑战。

入选理由:物理机器人Agent需实时重规划,因环境持续变化且任务无明确终点

精选推文#Milvus#RAG#机器人#向量数据库#AI Agent中文
From Regex to Vision Models: Which RAG Technique Fits Which Problem

从正则到视觉模型:哪种 RAG 技术适合你的问题

Towards Data Science4997 字 (约 20 分钟)
90

RAG 技术并非万能,应根据文档结构和问题控制程度选择合适方法:模板化文档用正则表达式,客服对话需 LLM 判断语调,工程图纸必须使用视觉模型。

入选理由:模板化文档(如保险单、银行流水)适合用正则表达式提取字段,避免使用高成本的 RAG 流程。

精选文章#RAG#LLM#文档智能#视觉模型#企业AI英文
RAG Is Not Machine Learning, and the ML Toolkit Solves the Wrong Problem

RAG 不是机器学习,且 ML 工具包解决的是错误问题

Towards Data Science6346 字 (约 26 分钟)
87

RAG 不是机器学习,使用 ML 工具包解决的是错误问题。文章指出,尽管 RAG 看似类似 ML,但其核心是构建搜索系统而非训练模型,因此超参数调优、嵌入模型微调等 ML 方法无法解决 RAG 的真实故障,反而导致资源浪费和信任下降。

入选理由:RAG 解决的是确定性答案查找问题,而非预测未知结果,因此不能用 ML 方法优化。

精选文章#RAG#机器学习#企业AI#信息检索#大语言模型英文
Towards Data Science 图标

Proxy-Pointer RAG:解决大规模知识图谱中的实体与关系蔓延问题

Towards Data Science3847 字 (约 16 分钟)
87

Proxy-Pointer RAG 通过保留文档结构上下文,将知识图谱实体与关系匹配的计算成本降低 90% 以上,实现高效、低延迟的图谱入管,解决了大规模知识图谱的语义蔓延问题。

入选理由:Proxy-Pointer RAG 使用 Skeleton Tree 和 Breadcrumb Injection 技术,使向量检索能精准定位文档完整结构段,而非碎片化块。

精选文章#RAG#知识图谱#Proxy-Pointer#实体消歧#向量检索英文
𝗬𝗼𝘂𝗿 𝗥𝗔𝗚 𝘀𝘆𝘀𝘁𝗲𝗺 𝗽𝗿𝗼𝗱𝘂𝗰𝗲𝘀 "𝗵𝗶𝗴𝗵𝗲𝗿-𝗳𝗹𝘂𝗲𝗻𝗰𝘆 ...

你的RAG系统产生“更高流畅性的幻觉”

Weaviate • vector database(@weaviate_io)245 字 (约 1 分钟)
87

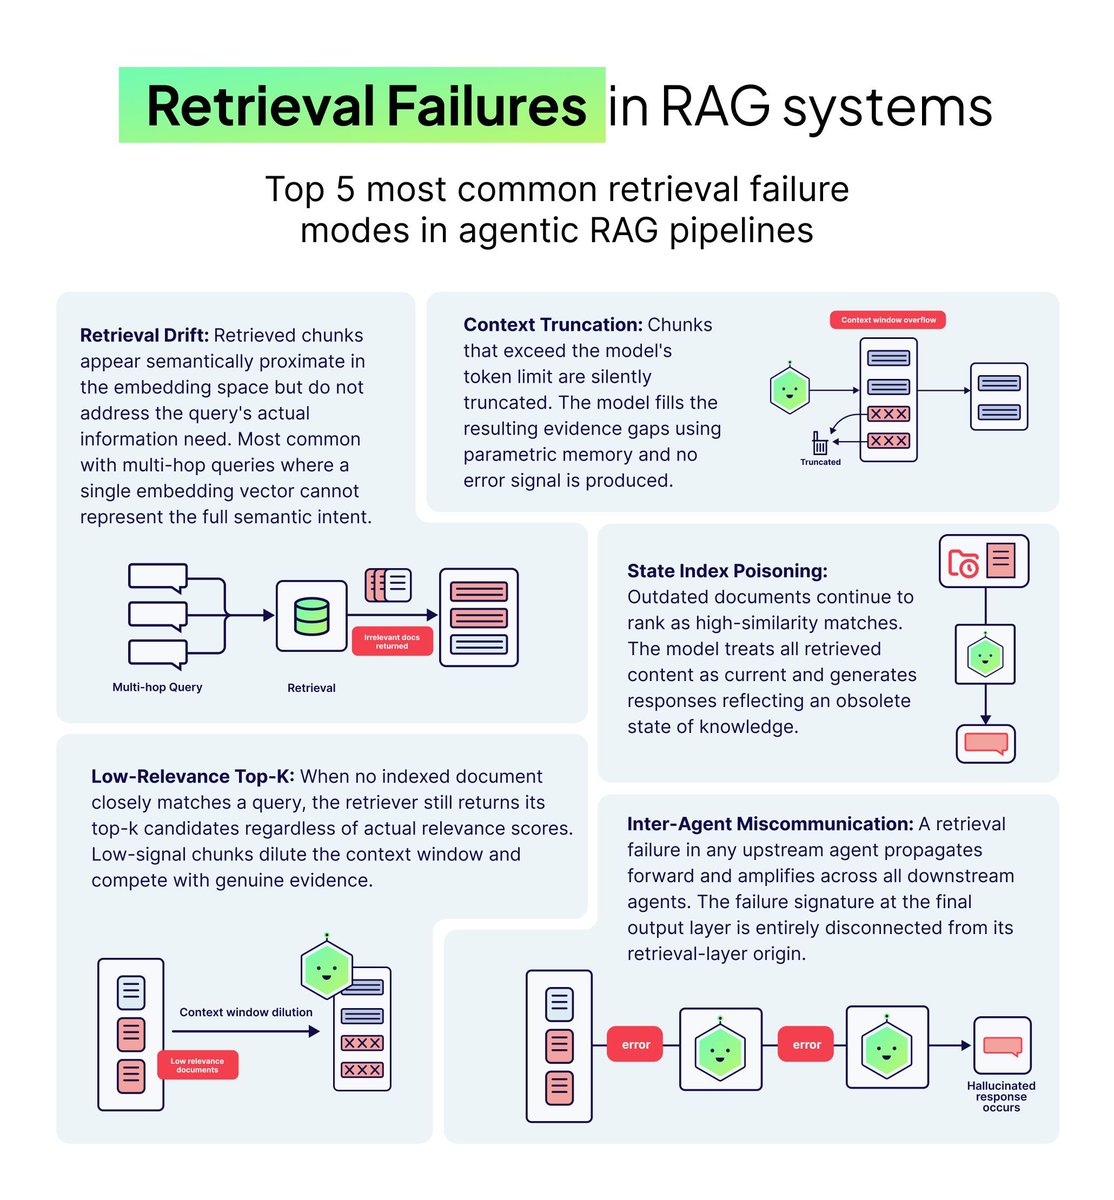
研究发现,RAG系统中检索质量差是导致高流畅性幻觉(更自信但更错误)的主因,模型升级无法弥补检索缺陷。

入选理由:检索质量差是RAG输出退化的最主要预测指标,模型能力增强反而加剧幻觉可信度。

精选推文#RAG#向量数据库#Weaviate#LLM#幻觉检测中英混合
GraphRAG: Beyond Search

GraphRAG: Beyond Search

Microsoft Research325 字 (约 2 分钟)
85

GraphRAG通过知识图谱实现信息连接,超越传统RAG在复杂查询中的表现,微软研究院推动其产品化落地。

入选理由:GraphRAG通过知识图谱实现信息连接,准确识别新批准的治疗方法

精选视频#GraphRAG#RAG#知识图谱#微软研究院#AI搜索英文
PyTorch Foundation Ambassador Community Highlights November 2026

PyTorch Foundation Ambassador Community Highlights November 2026

PyTorch Blog918 字 (约 4 分钟)
85

PyTorch大使社区在2026年11月举办了多场技术活动,涵盖TPU使用、LLM推理优化和本地社区建设,推动了全球AI技术交流。

入选理由:PyTorch大使在乌干达举办活动,吸引了32人参与,新增20名WhatsApp成员。

精选文章#PyTorch#AI#社区活动#LLM#TPU英文
Towards Data Science 图标

Local LLMs Handle Textbook RAG but Fail on New Research Papers

Towards Data Science2453 字 (约 10 分钟)
85

本地小型LLM在处理教科书内容时表现良好,但在处理最新研究论文时几乎失效,表明模型对新内容的适应能力不足。

入选理由:本地小型LLM在处理教科书内容时得分12到20分(满分20),但在处理最新研究论文时得分降至0到9分(满分15)。

精选文章#RAG#LLM#本地模型#研究论文#AI英文
Uber’s Legal AI Agent Cuts Contract Review Time by 20% with Rules and RAG

Uber 使用基于规则和 RAG 的 AI 法律代理,将合同审查时间减少 20%,准确率达 91%。

入选理由:Uber 的 AI 法律代理将合同审查时间减少 20%,准确率达 91%。

精选文章#AI#RAG#合同审查#Uber#法律科技英文
Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base

Get answers from tables with tabular search in Amazon Bedrock Managed Knowledge Base

AWS Machine Learning Blog3640 字 (约 15 分钟)
85

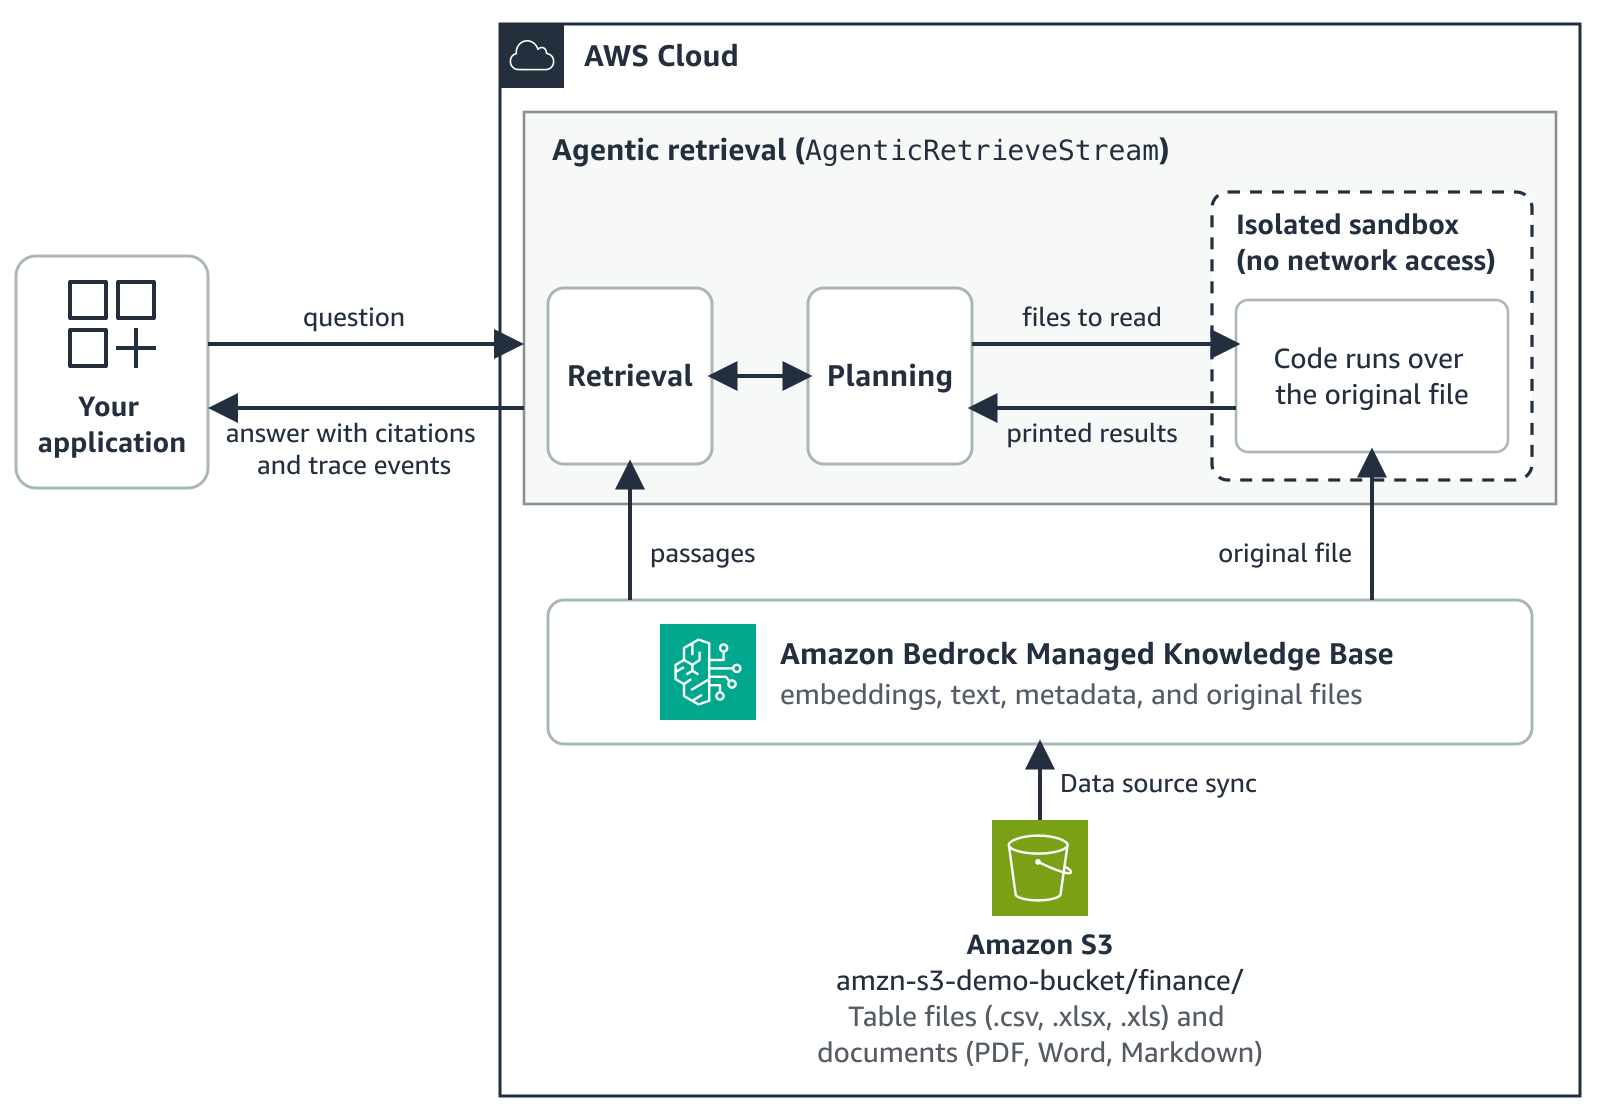
AWS Bedrock 知识库新增表格搜索功能,支持从 CSV、XLSX 等文件中提取数据并进行计算,提升复杂问题的解答能力。

入选理由:表格搜索功能支持从 CSV、XLSX、XLS 文件中提取数据并进行计算。

精选文章#AWS#Bedrock#表格搜索#RAG#机器学习英文
Towards Data Science 图标

A Practitioner's Guide to 6 Agentic GraphRAG Patterns

Towards Data Science5505 字 (约 23 分钟)
85

Agentic GraphRAG通过自主代理动态更新知识图谱,提升企业级RAG系统的推理能力与上下文完整性。

入选理由:Agentic GraphRAG通过自主代理动态更新知识图谱,提升企业级RAG系统的推理能力与上下文完整性。

精选文章#RAG#知识图谱#AI#企业应用英文
KDnuggets 图标

Building Graph-Enhanced GenAI Applications with graphrag-toolkit

KDnuggets3368 字 (约 14 分钟)
85

GraphRAG通过知识图谱增强检索,解决传统RAG在处理复杂关系查询时的不足,AWS开源工具链实现多跳研究助手构建。

入选理由:GraphRAG利用知识图谱连接分散信息,提升复杂查询准确性达30%以上

精选文章#GraphRAG#知识图谱#RAG#Neo4j#pgvector英文
MongoDB Blog 图标

MongoDB与微软Azure Foundry整合MCP Server,使AI代理能实时访问MongoDB Atlas数据并执行数据库操作。

入选理由:MongoDB MCP Server已集成至Azure Foundry工具目录,支持实时数据访问

精选文章#MongoDB#Microsoft Azure#AI代理#MCP协议#数据集成英文
EP231: AI Terms You Need to Know

EP231: AI Terms You Need to Know

ByteByteGo Newsletter1127 字 (约 5 分钟)
85

本文系统梳理了AI领域关键术语及GPT系列模型演进,适合工程师快速掌握基础概念。

入选理由:Agentic AI通过自主规划和工具调用实现目标达成

精选文章#AI#机器学习#术语#GPT英文
Elastic Blog 图标

AI, out-of-the-box!

Elastic Blog1386 字 (约 6 分钟)
85

Elastic Cloud 现在默认启用生成式 AI 功能,提升安全、可观测性和搜索效率。

入选理由:Elastic Security 的 AI 功能无需设置即可使用

精选文章#Elastic#GenAI#安全#可观测性#AI英文
Towards Data Science 图标

Data Enablement for AI: A Practitioner's Guide to 6 Advanced Architectural Patterns

Towards Data Science4673 字 (约 19 分钟)
85

企业需采用6种高级架构模式构建AI数据基础,解决传统数据平台与AI需求的不匹配问题,确保数据新鲜度、清洁度和权限控制。

入选理由:企业数据平台需解决数据新鲜度、清洁度和权限控制三大核心问题

精选文章#Data Engineering#AI#Architectural Patterns#Data Fabric#Lakehouse英文
How IskayPet unified corporate knowledge with Amazon Bedrock Managed Knowledge Bases

How IskayPet unified corporate knowledge with Amazon Bedrock Managed Knowledge Bases

AWS Machine Learning Blog2006 字 (约 9 分钟)
85

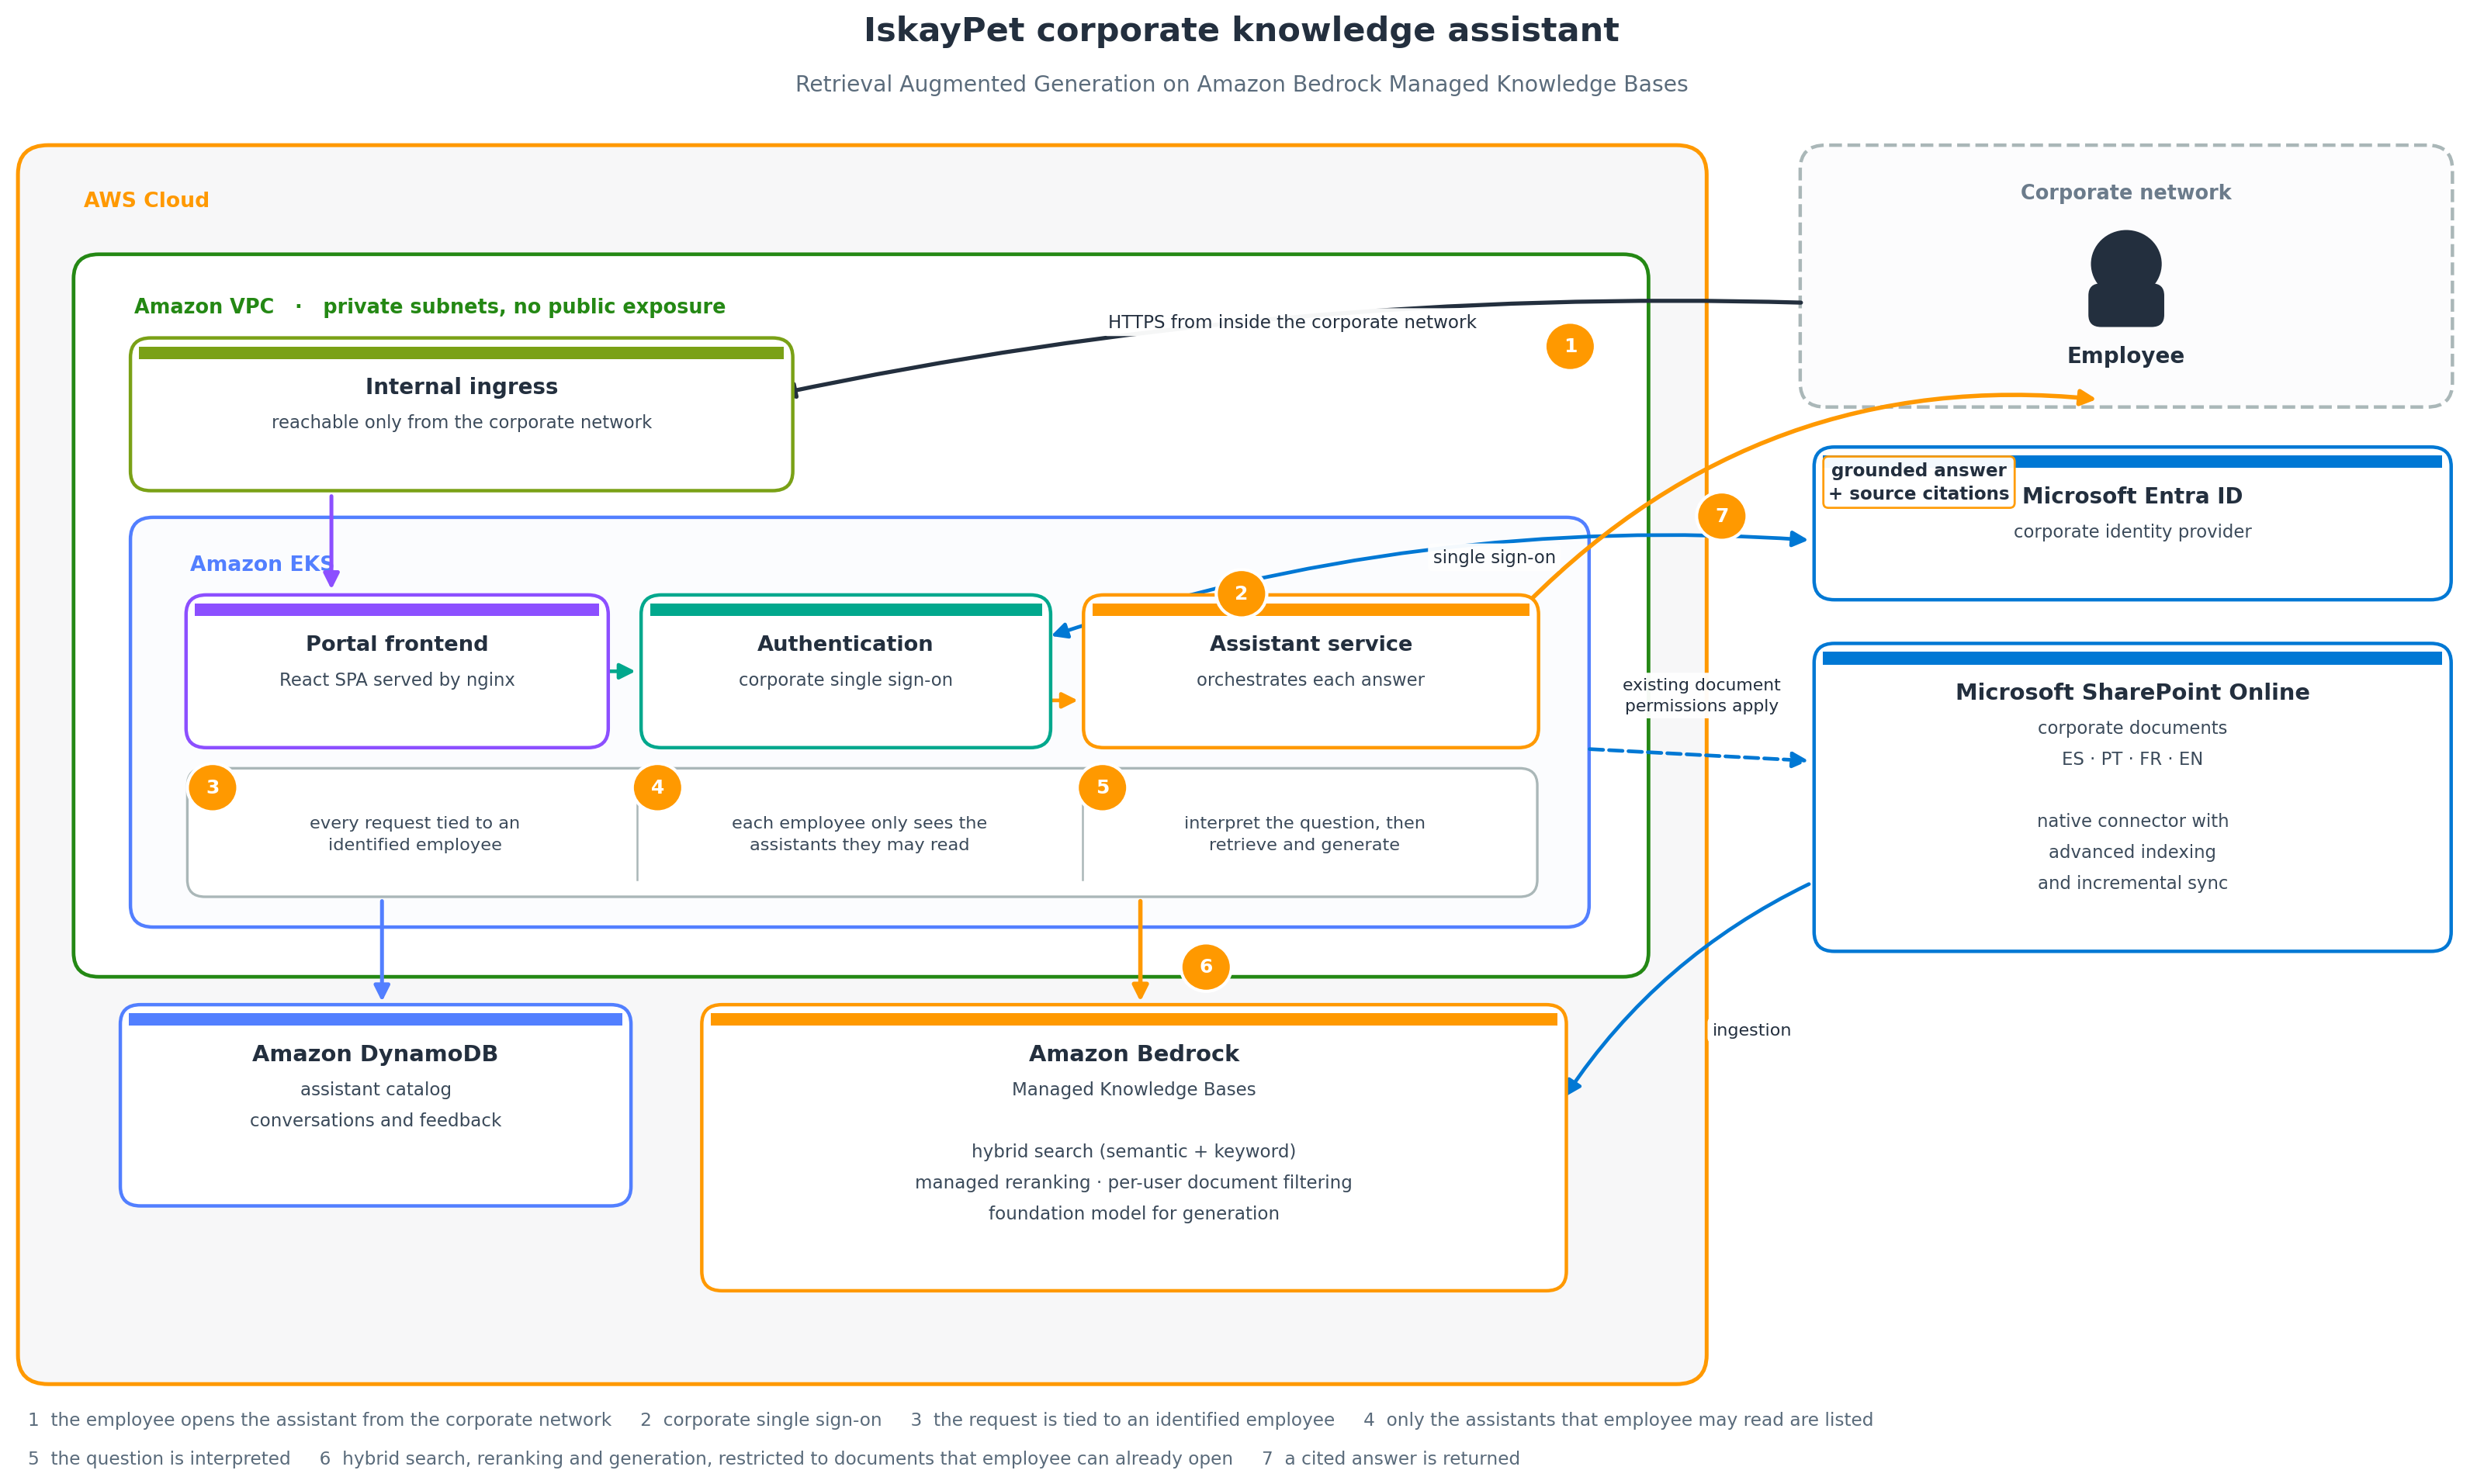
IskayPet通过Amazon Bedrock托管知识库整合多语言企业文档,实现无需维护RAG基础设施的知识检索系统。

入选理由:Amazon Bedrock托管知识库可替代自建RAG系统,降低运维复杂度

精选文章#RAG#Amazon Bedrock#知识库#多语言#企业AI英文
What I learned from companies training their own models

What I learned from companies training their own models

Gradient Flow1367 字 (约 6 分钟)
85

企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。

入选理由:持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)

精选文章#模型训练#持续预训练#企业AI#模型工厂英文
AI HOT 精选 图标

DeepSeek 开放自研搜索 API

AI HOT 精选41 字 (约 1 分钟)
85

DeepSeek 推出自研搜索 API,支持多语言及 SEO 优化,日均处理数亿次查询。

入选理由:DeepSeek 搜索 API 日均处理数亿次查询,支持多语言检索

精选文章#DeepSeek#搜索API#AI#SEO优化中英混合
Towards Data Science 图标

How Do Word Embeddings Capture Relationships Between Words?

Towards Data Science3589 字 (约 15 分钟)
85

词嵌入通过向量空间中的几何关系捕捉词语间的语义关联,是NLP中实现语义理解的关键技术。

入选理由:词嵌入将词语映射为向量,通过向量距离反映语义相似性

精选文章#NLP#词嵌入#机器学习#AI应用英文
从 RAG 失败到 91% 准确率:Uber 法务红线 Agent 的四次架构演进

Uber 每年谈判数千份合同,法务审核是交易、供应商入驻、产品上线的关键瓶颈。团队的核心洞察是:这份看似高度专业的...

Uber通过四次架构演进,将法务红线Agent准确率提升至91%,合同审核时间下降20%+,实现AI与律师协同的法律审核系统。

入选理由:第二版引入指数衰减加权(半衰期365天)对抗策略漂移

精选推文#RAG#AI Agent#法律科技#合同审核中英混合
Rethinking access control for RAG with Amazon Quick and Amazon Bedrock

Rethinking access control for RAG with Amazon Quick and Amazon Bedrock

AWS Machine Learning Blog1181 字 (约 5 分钟)
85

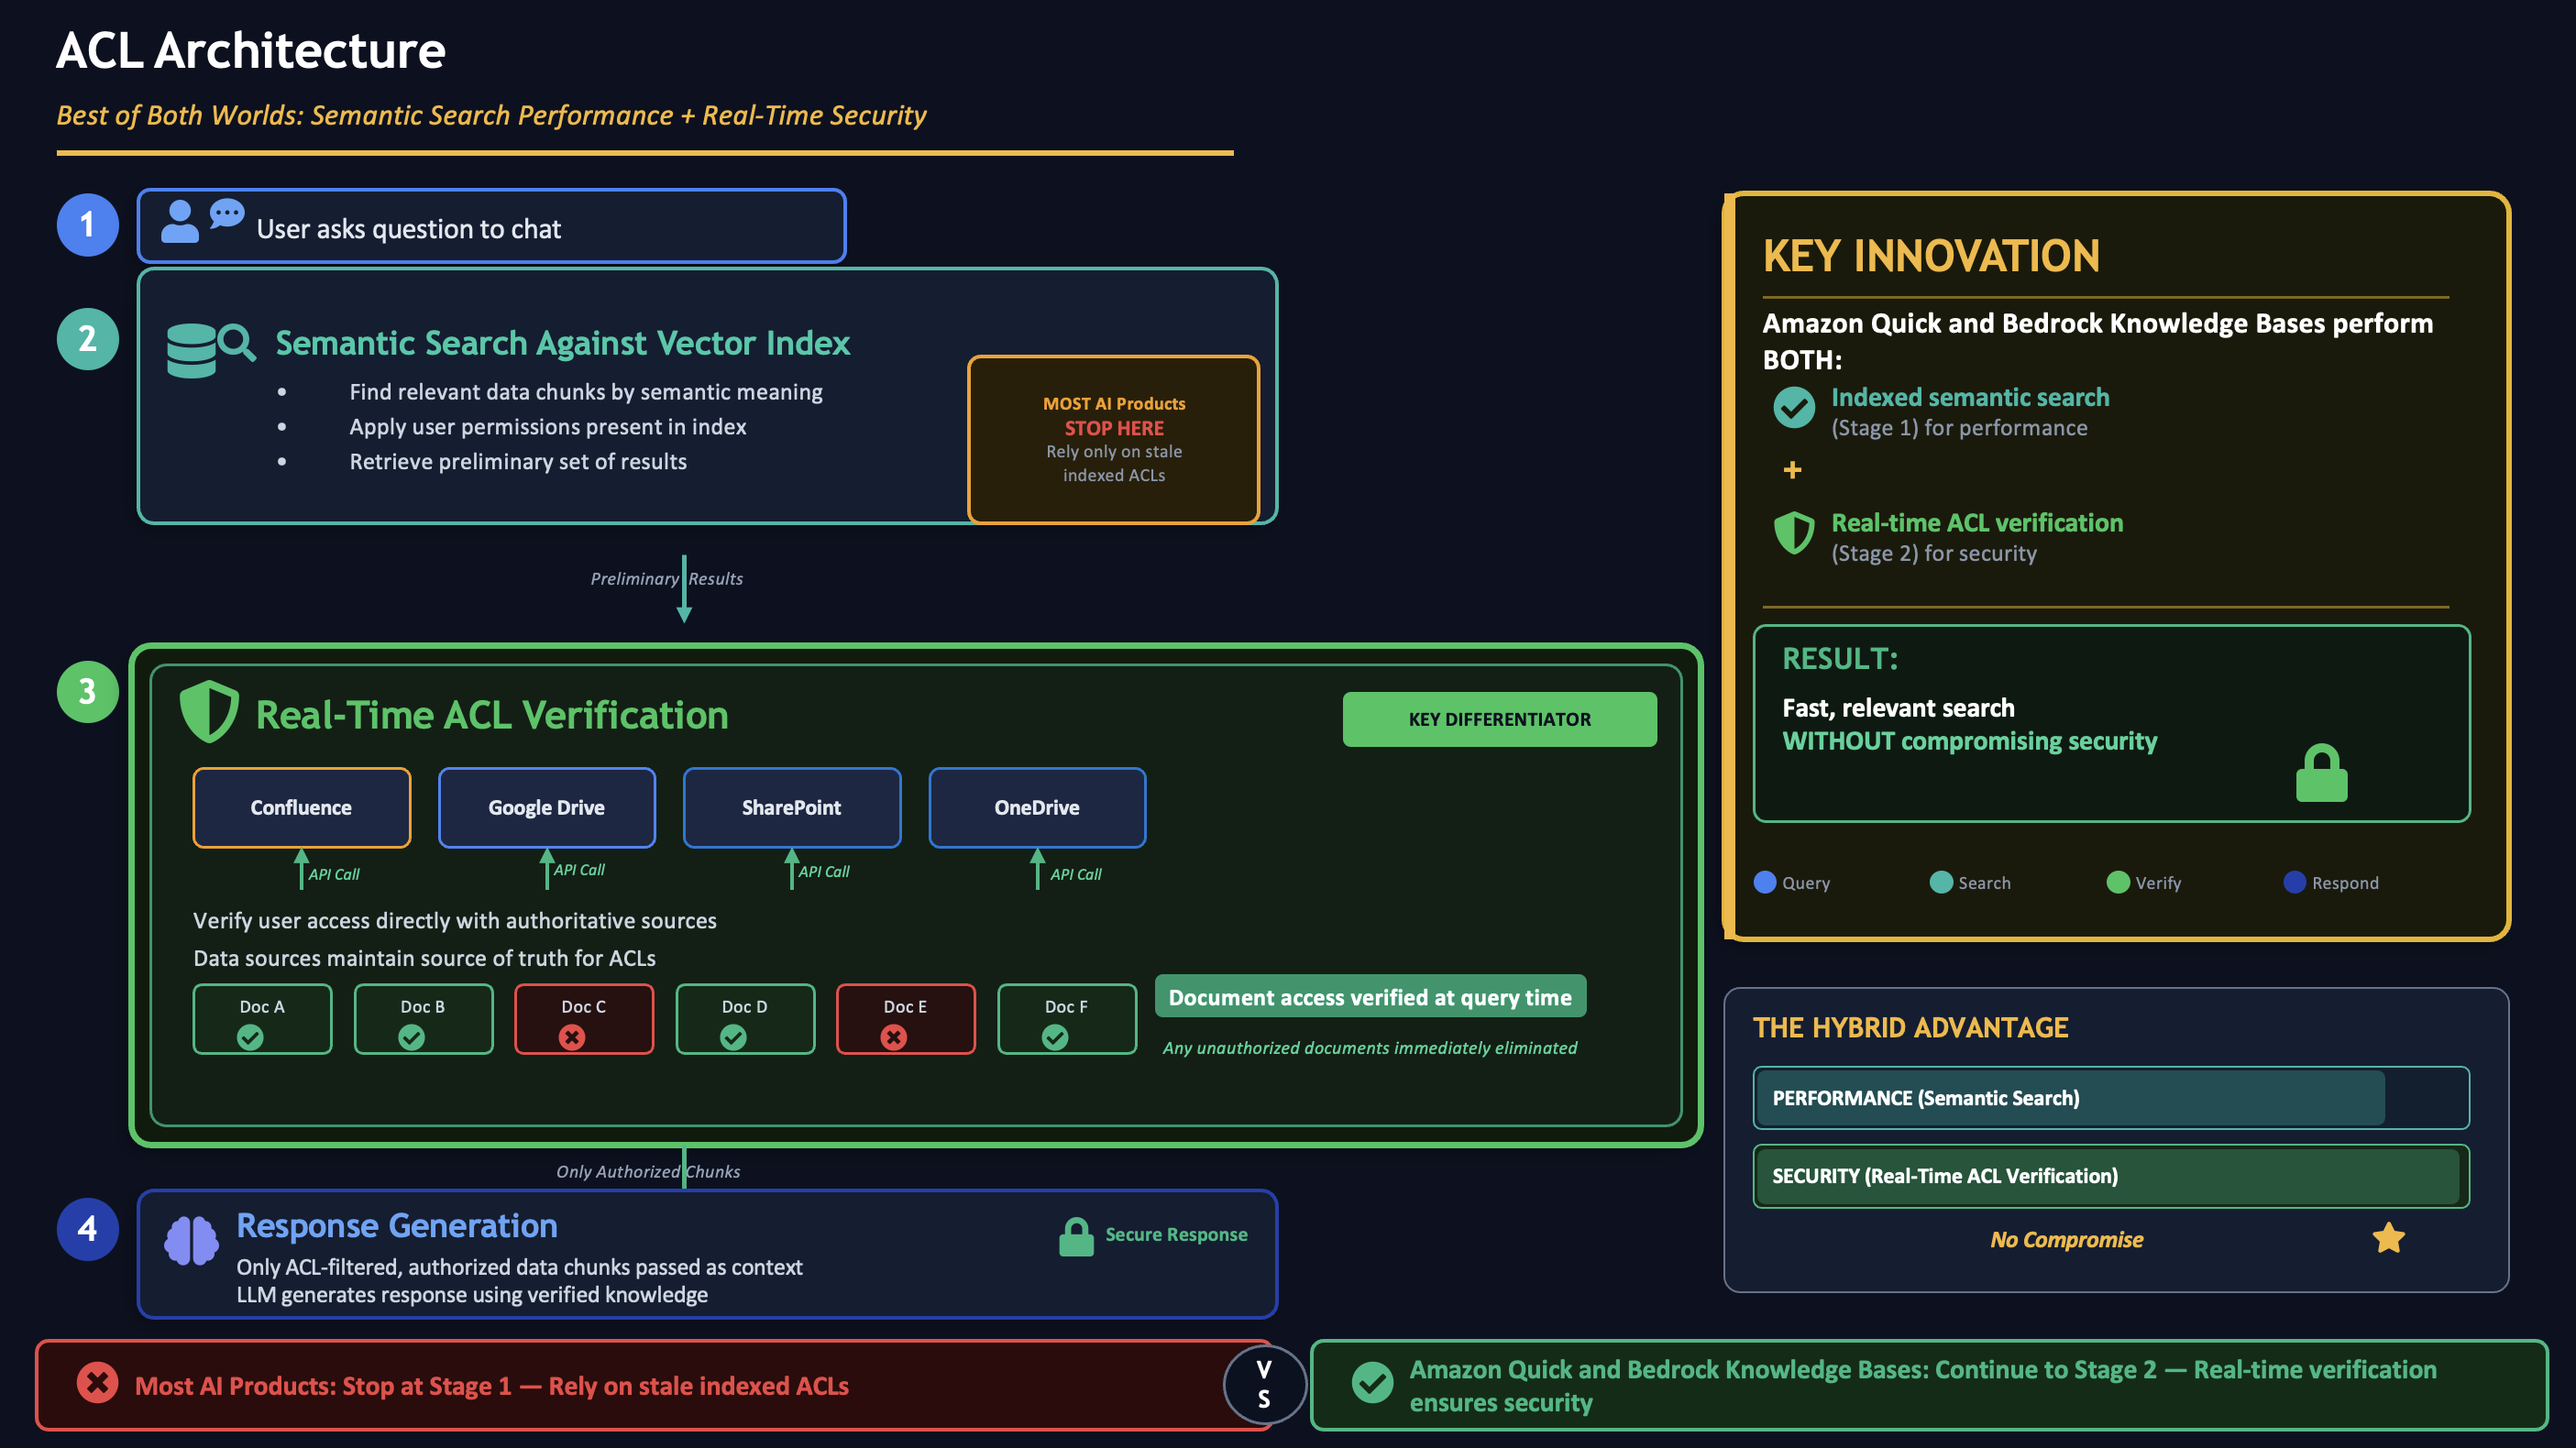
AWS提出通过实时ACL验证解决RAG访问控制难题,确保AI生成内容符合企业权限策略。

入选理由:现有RAG方案依赖定期同步的ACL,存在权限过期风险

精选文章#RAG#访问控制#Amazon Bedrock#AI安全英文
Machine Learning Mastery 图标

Synchronous vs. Asynchronous Agent Execution: Architecture Patterns for Production

Machine Learning Mastery2042 字 (约 9 分钟)
85

同步和异步代理执行模式各有优劣,选择需基于任务复杂度、延迟容忍度和基础设施需求,异步模式更适合长流程任务。

入选理由:同步模式受AWS API Gateway 29秒超时限制,复杂任务易导致连接中断。

精选文章#AI#架构设计#LLM代理#同步/异步执行英文
EP227: Top 9 Places to Use Jev

EP227: Top 9 Places to Use Jev

ByteByteGo Newsletter1109 字 (约 5 分钟)
85

Jev模型凭借100倍于前沿LLM的性能优势,适合处理决策类任务而非生成任务,适用于模型路由、安全防护等9大场景。

入选理由:Jev模型性能是前沿LLM的100倍,适合处理实时决策任务

精选文章#Jev#LLM#AI Agent#系统设计中英混合

跨材料问答 · RAG

回答基于:RAG 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容