DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency
DaisyRose-27B通过强化学习训练,在多个基准测试中显著提升性能,18天内仅用1200个任务实现Terminal-Bench 4.1 pass@1从5.6%到12.0%的跃升。
入选理由:DaisyRose-27B在Terminal-Bench 4.1上实现pass@1从5.6%到12.0%的提升
公司
与Google合作开发SGLang的公司
已跟踪 6 条高相关材料
最近变化
2026-11-18 · DaisyRose-27B在Terminal-Bench 4.1上实现pass@1从5.6%到12.0%的提升
为什么值得关注
RadixArk 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency
Hugging Face Blog · 8.5 分
DaisyRose-27B通过强化学习训练,在多个基准测试中显著提升性能,18天内仅用1200个任务实现Terminal-Bench 4.1 pass@1从5.6%到12.0%的跃升。
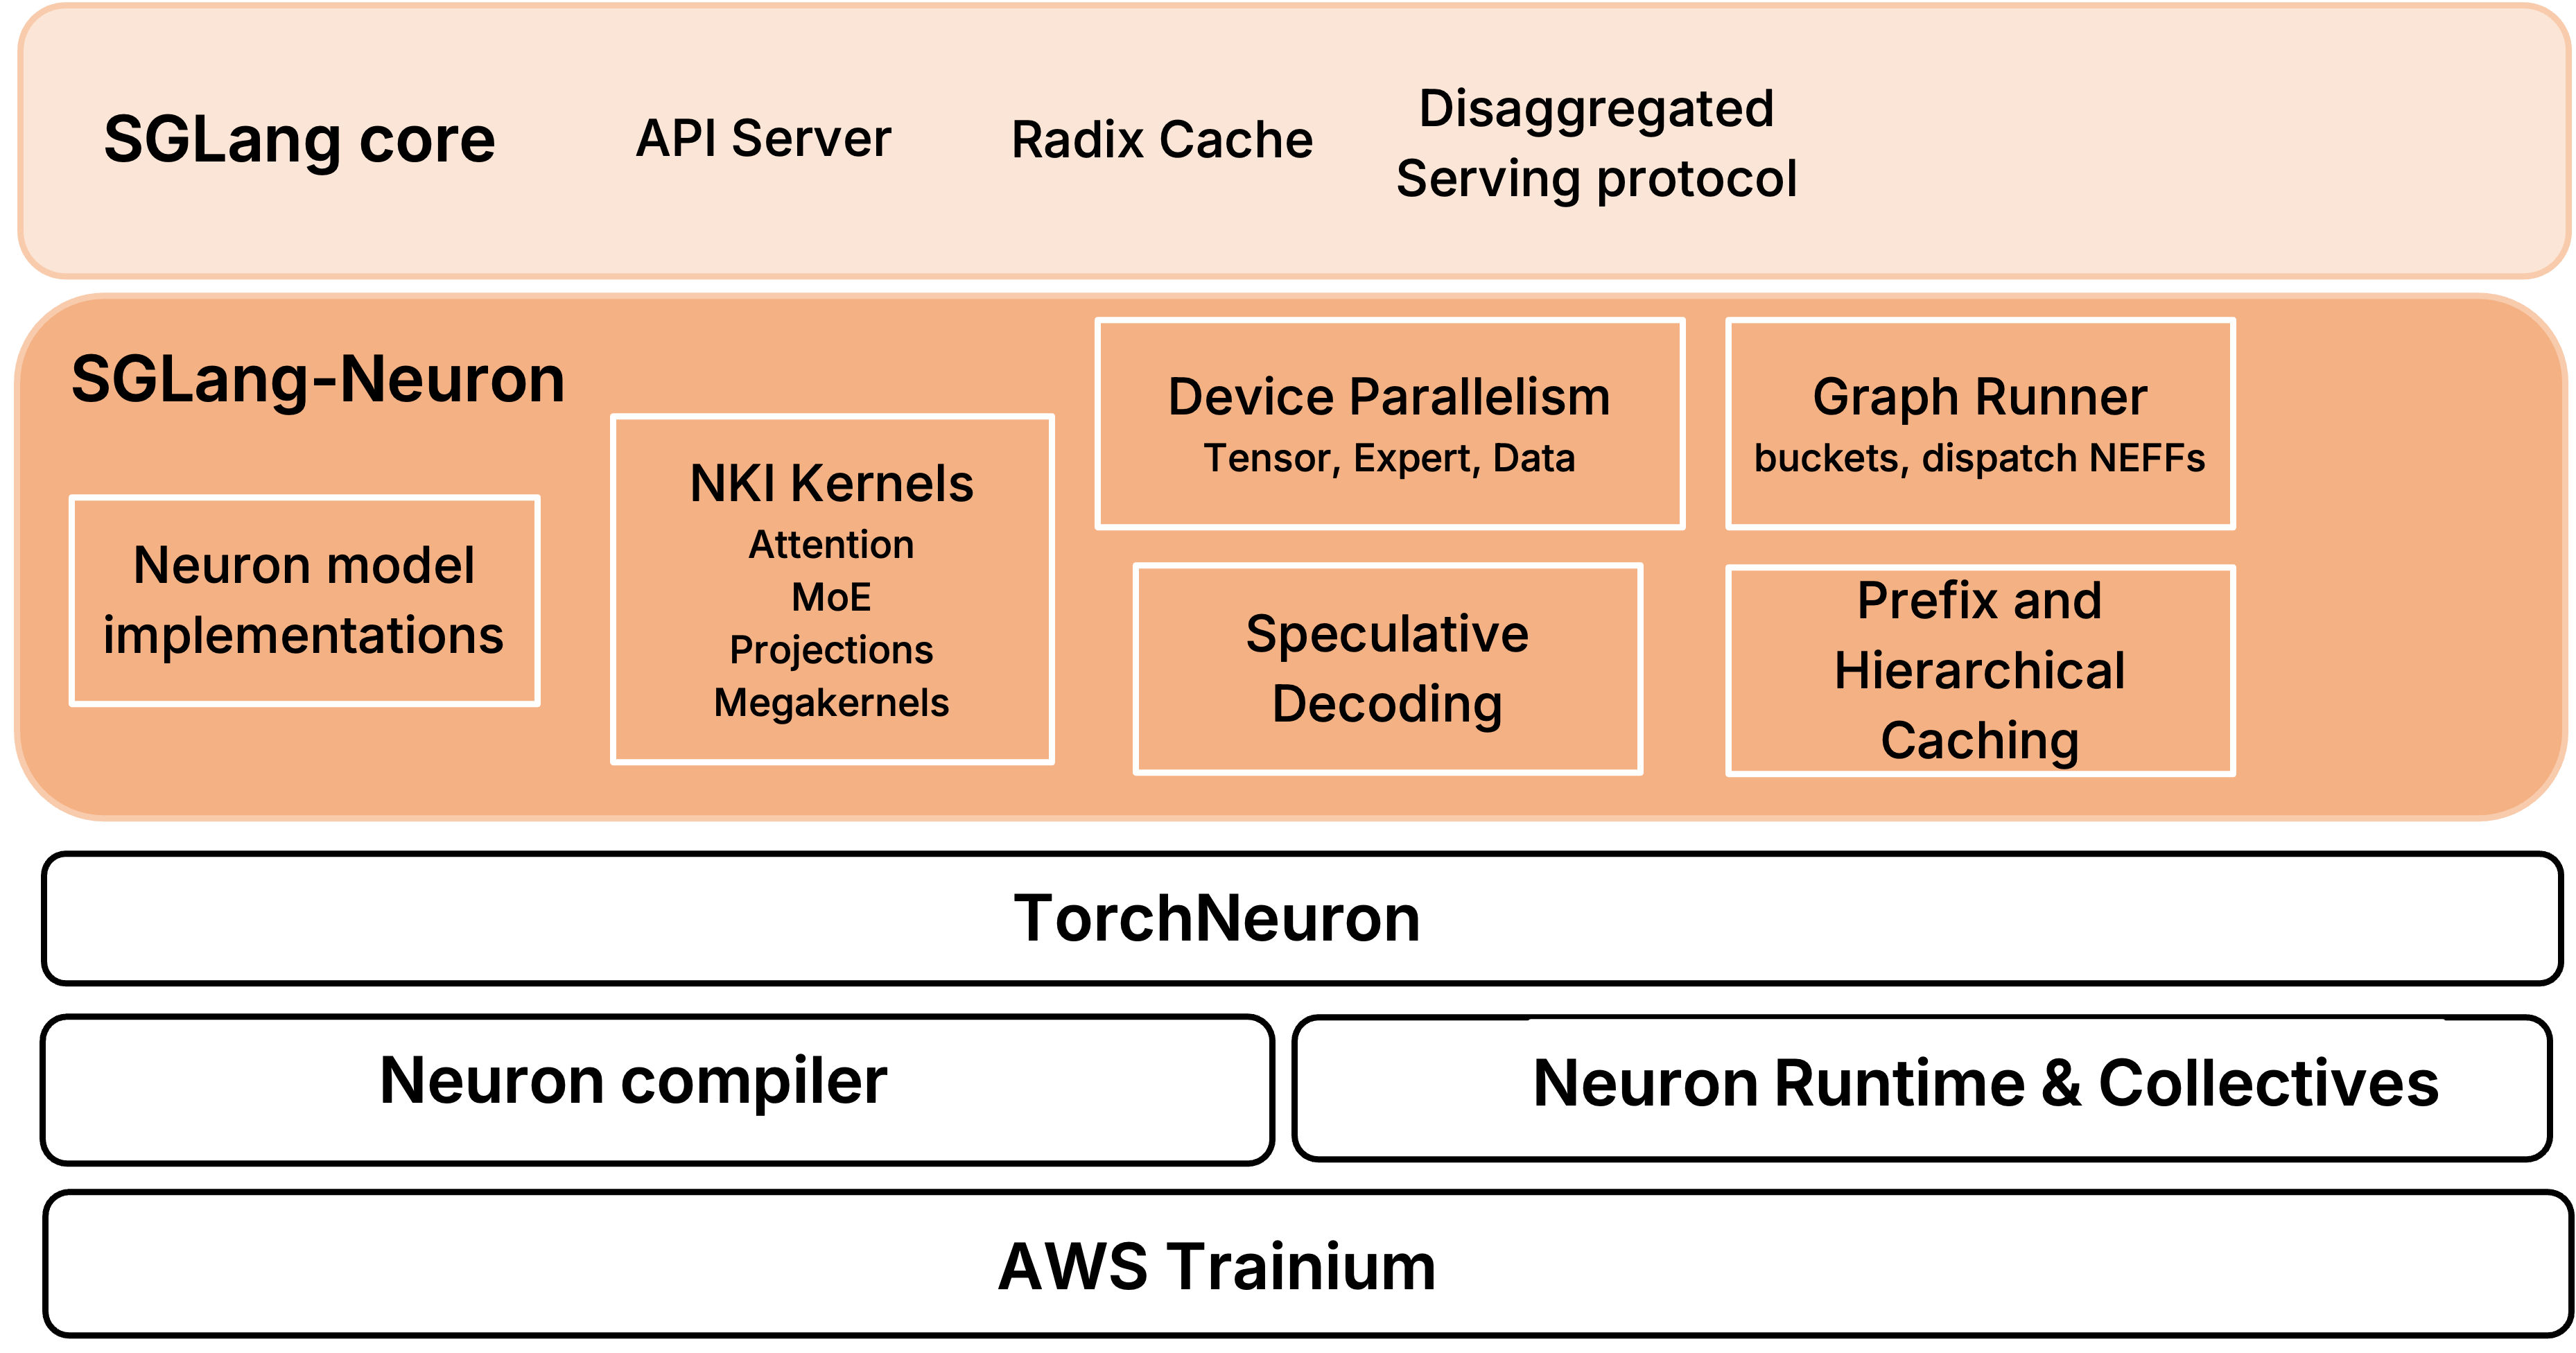
Deploy frontier AI models on AWS Trainium with SGLang-Neuron
AWS Machine Learning Blog · 8.5 分
AWS推出SGLang-Neuron插件,支持在Trainium芯片上高效部署前沿AI模型,结合PyTorch和Neuron技术提升性能。
Announcing New vLLM and SGLang Inference Engines on TPU
Google Developers Blog · 8.5 分
Google推出基于TPU的vLLM和SGLang推理引擎,通过TorchTPU实现PyTorch原生支持,优化大模型服务性能。
已收录 6 条与 RadixArk 相关的内容,按评分排序。
DaisyRose-27B通过强化学习训练,在多个基准测试中显著提升性能,18天内仅用1200个任务实现Terminal-Bench 4.1 pass@1从5.6%到12.0%的跃升。
入选理由:DaisyRose-27B在Terminal-Bench 4.1上实现pass@1从5.6%到12.0%的提升
AWS推出SGLang-Neuron插件,支持在Trainium芯片上高效部署前沿AI模型,结合PyTorch和Neuron技术提升性能。
入选理由:SGLang-Neuron通过PyTorch和NKI内核实现Trainium芯片的高效模型执行
Google推出基于TPU的vLLM和SGLang推理引擎,通过TorchTPU实现PyTorch原生支持,优化大模型服务性能。
入选理由:TorchTPU使TPU成为原生PyTorch设备,支持自定义Pallas内核
DeepSeekV4发布,通过组合创新和工程优化,在R1的“测试时扩展”范式下,实现百万上下文从理论到实用的飞跃,对Agent和多步复杂任务具有重要意义。
入选理由:DeepSeek V4沿用现有范式,未带来范式变化,但通过一系列技术创新显著提升了长上下文处理能力。
播客深入探讨AI基础设施发展与SGLang开源项目,揭示AI工程化与开源社区的挑战与机遇。
入选理由:SGLang从学术项目发展为生产级开源推理引擎
Fish Audio 在 X 平台转发祝贺 RadixArk 融资 1 亿美元的消息,内容仅为社交致谢与链接跳转,无技术细节、架构说明或实践指导。
入选理由:RadixArk 宣布完成 1 亿美元种子轮融资,估值 4 亿美元。