T
traeai
登录

模型

Qwen3.8-27B

别名:通义千问3.8-27B

通义千问系列大语言模型

已跟踪 16 条高相关材料

TraeAI 观察

相关材料

已收录 16 条与 Qwen3.8-27B 相关的内容,按评分排序。

Hugging Face Blog 图标

DaisyRose-27B: Pushing the Frontier of Post-Training Efficiency

Hugging Face Blog1198 字 (约 5 分钟)
85

DaisyRose-27B通过强化学习训练,在多个基准测试中显著提升性能,18天内仅用1200个任务实现Terminal-Bench 4.1 pass@1从5.6%到12.0%的跃升。

入选理由:DaisyRose-27B在Terminal-Bench 4.1上实现pass@1从5.6%到12.0%的提升

精选文章#DaisyRose-27B#强化学习#Hugging Face#模型训练英文
Stop Paying for AI Subscriptions! Run Local AI for FREE (LM Studio Tutorial)

无需订阅,本地免费运行AI模型,LM Studio教程展示如何在Mac、Windows和Linux上安装并选择适合硬件的模型。

入选理由:LM Studio支持Mac、Windows和Linux,安装简单。

精选视频#AI模型#LM Studio#本地部署#开源工具中英混合
呃.. 所以是用 Qwen3.8-27B 后训练了一个“德性”模型?还是强化西方价值观的德性?

是不是类似于收养一个中国孩子,然后不断给他灌输洗脑西方知识,让他误以为自己是美国孩子?

所以,Nou...

Nous Research发布的Arete-27B模型基于Qwen3.8-27B微调,强化西方价值观,但引发关于模型价值观对齐的讨论。

入选理由:Arete-27B使用Qwen3.8-27B作为基础模型进行微调

精选推文#AI模型#价值观对齐#微调#Qwen3.8-27B#Arete-27B中英混合
Hacker News Best 图标

Memdoor: A team of 5 Qwen3.8-27B models beats Fable 5 on LiveCodeBench Hard

Hacker News Best716 字 (约 3 分钟)
85

Memdoor项目通过五种Qwen3.8-27B模型协作,在编程问题解决上达到与Fable 5相当的水平,但成本显著高于单模型方案。

入选理由:五模型协作在LiveCodeBench Hard前10题中平均得分9.8,接近Fable 5的9.6

精选文章#Memdoor#Qwen3.8-27B#模型协作#LiveCodeBench#AI编程英文
Hacker News Best 图标

Survival LLM: AI assistant and emergency library that runs on your own computer

Hacker News Best1204 字 (约 5 分钟)
85

Survival LLM是一款离线运行的AI助手,结合应急知识库,适用于断网环境下的生存指导。

入选理由:NVIDIA Nemotron 3.5 Super模型在测试中21/22答案正确,精度最高。

精选文章#AI助手#离线应用#应急系统#知识库英文
Hugging Face Blog 图标

Turning Database Grading into RL Rewards: Post-Training Agents with ThinkingBox

Hugging Face Blog4462 字 (约 18 分钟)
85

ThinkingBox将数据库评分转化为强化学习奖励,使Qwen3.8-27B模型任务完成率提升69%。

入选理由:ThinkingBox使Qwen3.8-27B的20/20任务完成率从38提升至107

精选文章#强化学习#数据库评估#ThinkingBox#Qwen3.8-27B#GRPO英文
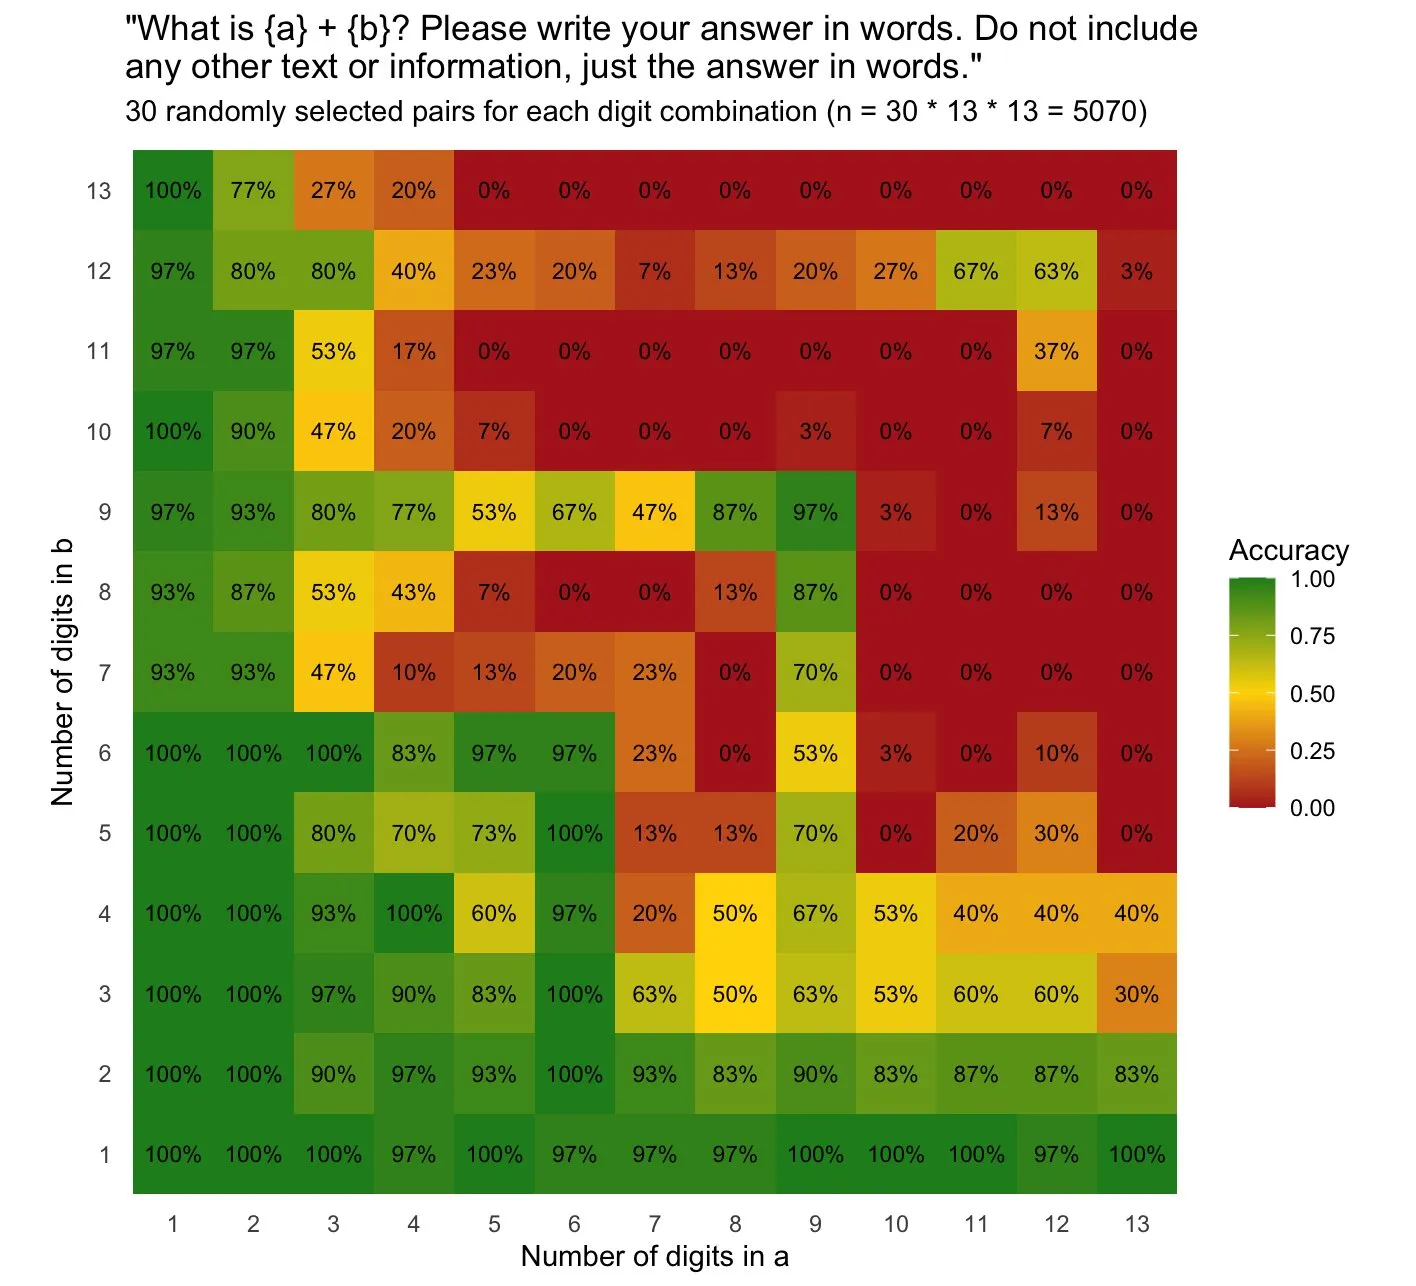
Qwen3.8 27B addition in words

Qwen3.8 27B addition in words

Simon Willison's Weblog553 字 (约 3 分钟)
85

Qwen3.8-27B模型在无推理时大数相加准确率仅23.57%,启用推理后提升至97.04%。

入选理由:Qwen3.8-27B无推理时十至十三位数相加准确率仅6.44%

精选文章#Qwen3.8#LLM#推理机制#大数计算中英混合
Which is The Best Qwen3.8-27B?

Which is The Best Qwen3.8-27B?

Sam Witteveen4890 字 (约 20 分钟)
85

Qwen3.8-27B模型通过减少思考令牌将推理时间从90秒缩短至18秒,不同优化方法在效率与准确性间取得平衡。

入选理由:Thinking Cap模型通过减少令牌使用将推理时间从90秒缩短至18秒

精选视频#Qwen3.8-27B#模型优化#推理效率#AI英文
Qwen3.8-27B & How to Serve it Fast

Qwen3.8-27B & How to Serve it Fast

Sam Witteveen4365 字 (约 18 分钟)
85

Qwen3.8-27B模型在性能上显著优于Meta的Glimmer 30B,但需通过量化与部署优化实现本地高效运行。

入选理由:Qwen3.8-27B参数量达2.4万亿,远超3.6版本且性能提升明显

精选视频#Qwen3.8-27B#模型部署#大模型#AI推理优化英文
端侧模型专用Harness,用Qwen3.8-27B实现「零成本推理」

端侧模型专用Harness,用Qwen3.8-27B实现「零成本推理」

机器之心86 字 (约 1 分钟)
60

文章介绍通过专用Harness实现端侧模型零成本推理方案,但因环境异常无法获取完整内容。

入选理由:Qwen3.8-27B模型通过Harness实现端侧推理优化

精选文章#Qwen3.8-27B#端侧推理#模型优化#微信公众号中文
It's been a pleasure to partner with the @Alibaba_Qwen team.

It's been a pleasure to partner with the @Alibaba_Qwen team.

ollama(@ollama)71 字 (约 1 分钟)
50

Qwen3.8-27B模型已发布,邀请开发者参与共建,但技术细节披露有限。

入选理由:Qwen3.8-27B模型已通过ollama平台开放使用

精选推文#AI模型#Qwen#ollama#Alibaba英文
new drop

https://t.co/45SOdSM14S

new drop https://t.co/45SOdSM14S

Julien Chaumond(@julien_c)57 字 (约 1 分钟)
50

推文提及Qwen3.8-27B模型在Hugging Face发布,但未提供技术细节或使用价值说明。

入选理由:Qwen3.8-27B模型已上线Hugging Face

精选推文#模型发布#Hugging Face#AI中英混合

跨材料问答 · Qwen3.8-27B

回答基于:Qwen3.8-27B 相关 16 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容