T
traeai
登录

产品

PyTorch

别名:PyTorch model

主流深度学习框架

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 PyTorch 相关的内容,按评分排序。

The next chapter in flood resilience: Open sourcing Google’s hydrology framework

防洪韧性新篇章:Google开源AI水文预测框架

Google Research Blog1143 字 (约 5 分钟)
92

Google开源了驱动Flood Hub的AI水文预测框架,允许机构使用LSTM架构与Caravan数据集训练本地化洪水模型。新版模型在实测流域将可靠预测窗口延长6天,支持PyTorch生态微调,赋能气象部门在保留数据主权前提下构建高精度预警系统。

入选理由:开源框架基于PyTorch和LSTM架构,提供完整训练管线与交互式教程Notebook。

精选文章#AI水文建模#LSTM#开源框架#洪水预测#PyTorch英文
在AWS上进行基础模型训练与推理的核心构建模块

在AWS上进行基础模型训练与推理的核心构建模块

AI HOT 精选4633 字 (约 19 分钟)
92

AWS 提供了支持大规模基础模型训练与推理的完整技术栈,涵盖高性能计算、网络、存储及开源软件集成,适配 NVIDIA 提出的“三大缩放定律”。

入选理由:NVIDIA 的三大缩放定律包括预训练、后训练(如 SFT 和 RL)和推理时计算,需统一基础设施支持。

精选文章#AWS#基础模型#分布式训练#PyTorch#可扩展性英文
PyTorch Foundation Ambassador Community Highlights November 2026

PyTorch Foundation Ambassador Community Highlights November 2026

PyTorch Blog918 字 (约 4 分钟)
85

PyTorch大使社区在2026年11月举办了多场技术活动,涵盖TPU使用、LLM推理优化和本地社区建设,推动了全球AI技术交流。

入选理由:PyTorch大使在乌干达举办活动,吸引了32人参与,新增20名WhatsApp成员。

精选文章#PyTorch#AI#社区活动#LLM#TPU英文
Understanding Positional Embeddings in Modern LLMs

Understanding Positional Embeddings in Modern LLMs

Ahead of AI9522 字 (约 39 分钟)
85

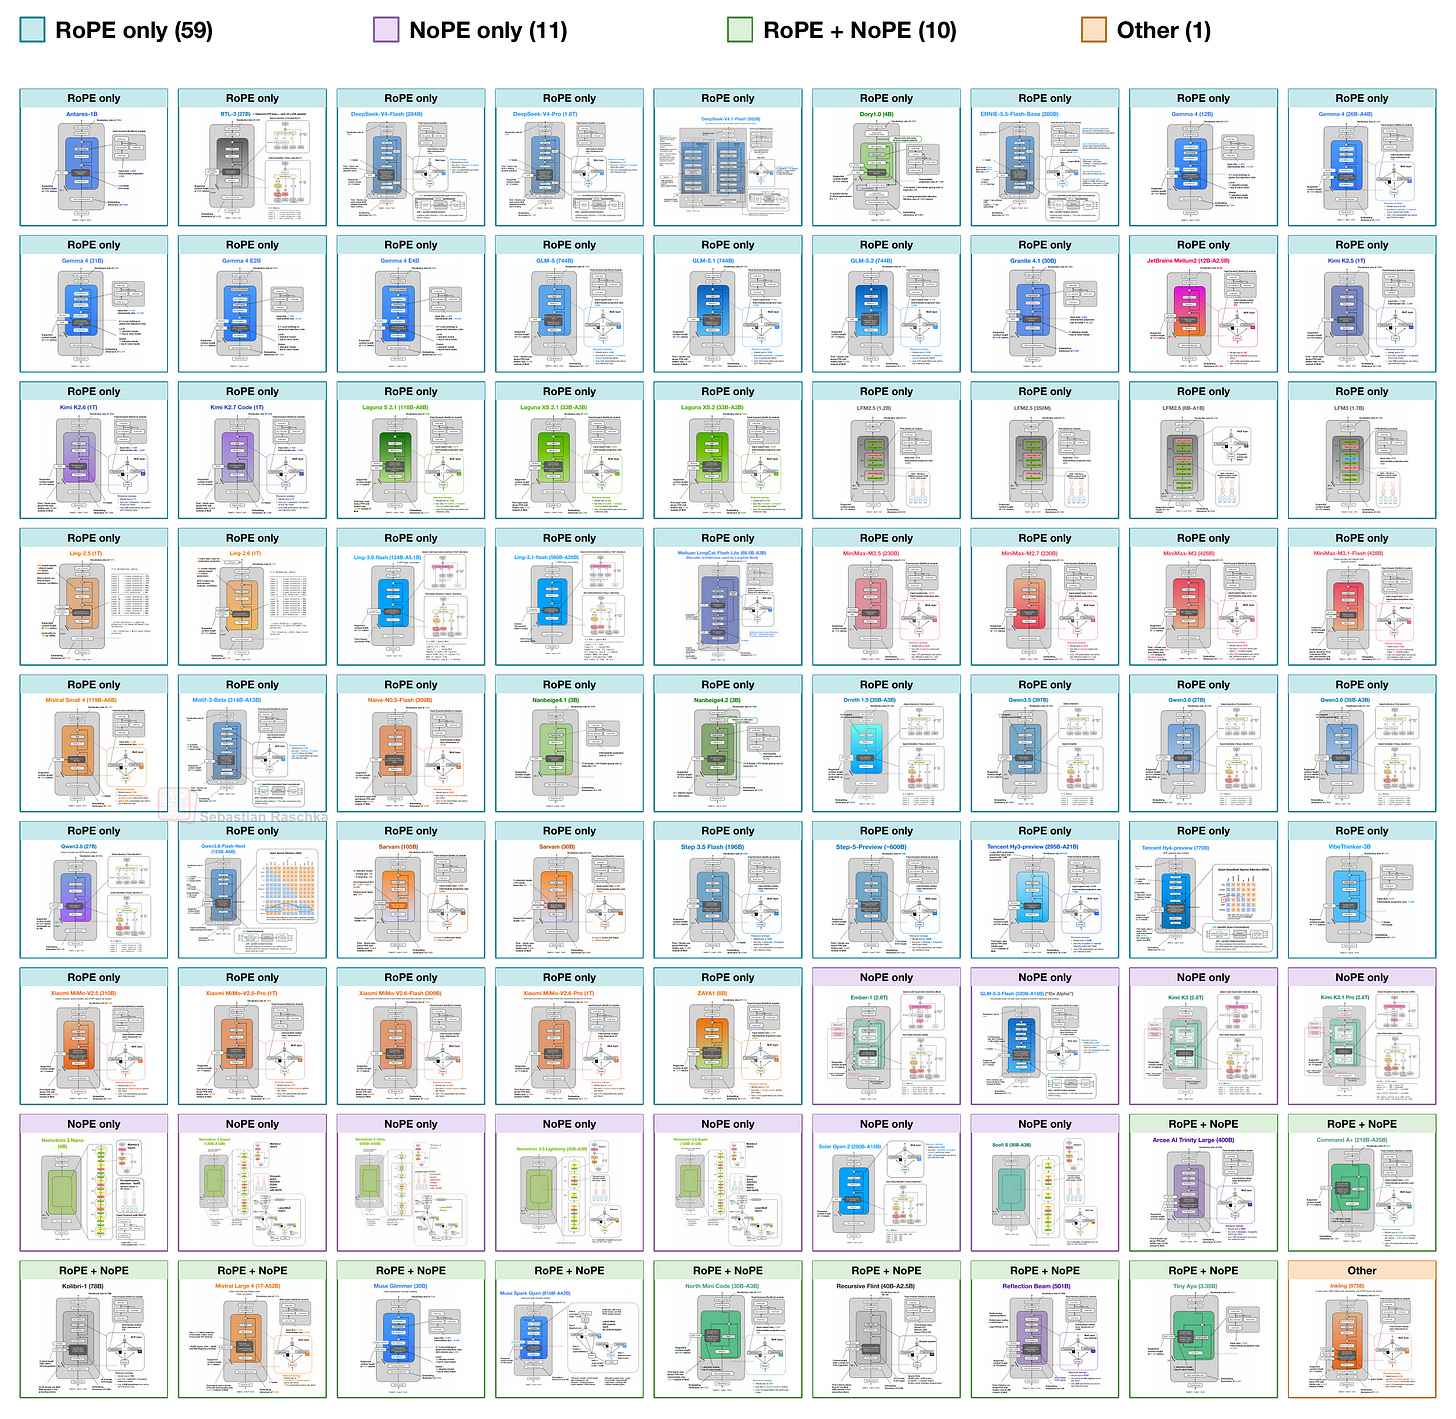
现代大语言模型通过多种方法(如 RoPE)处理位置信息,本文详细解析了这些机制并提供 PyTorch 实现。

入选理由:RoPE 是一种相对位置编码方法,被现代 LLM 广泛采用。

精选文章#LLMs#位置编码#RoPE#PyTorch#AI英文
Towards Data Science 图标

Computing Effective Dimension for Quantum ML Models in PyTorch

Towards Data Science4586 字 (约 19 分钟)
85

本文介绍了如何在 PyTorch 中计算量子机器学习模型的有效维度,提供代码示例和实验方法。

入选理由:有效维度衡量量子模型能区分的参数方向数量,反映模型容量。

精选文章#PyTorch#量子机器学习#有效维度#Fisher 信息矩阵英文
Machine Learning Mastery 图标

Weight-Only Quantization

Machine Learning Mastery4140 字 (约 17 分钟)
85

权重仅量化技术通过减少模型权重的存储和计算需求,显著提升推理效率,尤其适用于Transformer模型。

入选理由:权重仅量化可将FP16权重存储减少一半,例如INT8权重。

精选文章#Transformer#量化#AI推理#PyTorch英文
Machine Learning Mastery 图标

Fast Attention Kernels and Operator Fusion

Machine Learning Mastery2793 字 (约 12 分钟)
85

操作融合与快速注意力内核可提升Transformer推理性能,vLLM和CUDA图是关键实现手段。

入选理由:操作融合可减少30%以上的内核启动次数和内存流量

精选文章#Transformer#CUDA#模型优化#vLLM英文
Deploy frontier AI models on AWS Trainium with SGLang-Neuron

Deploy frontier AI models on AWS Trainium with SGLang-Neuron

AWS Machine Learning Blog592 字 (约 3 分钟)
85

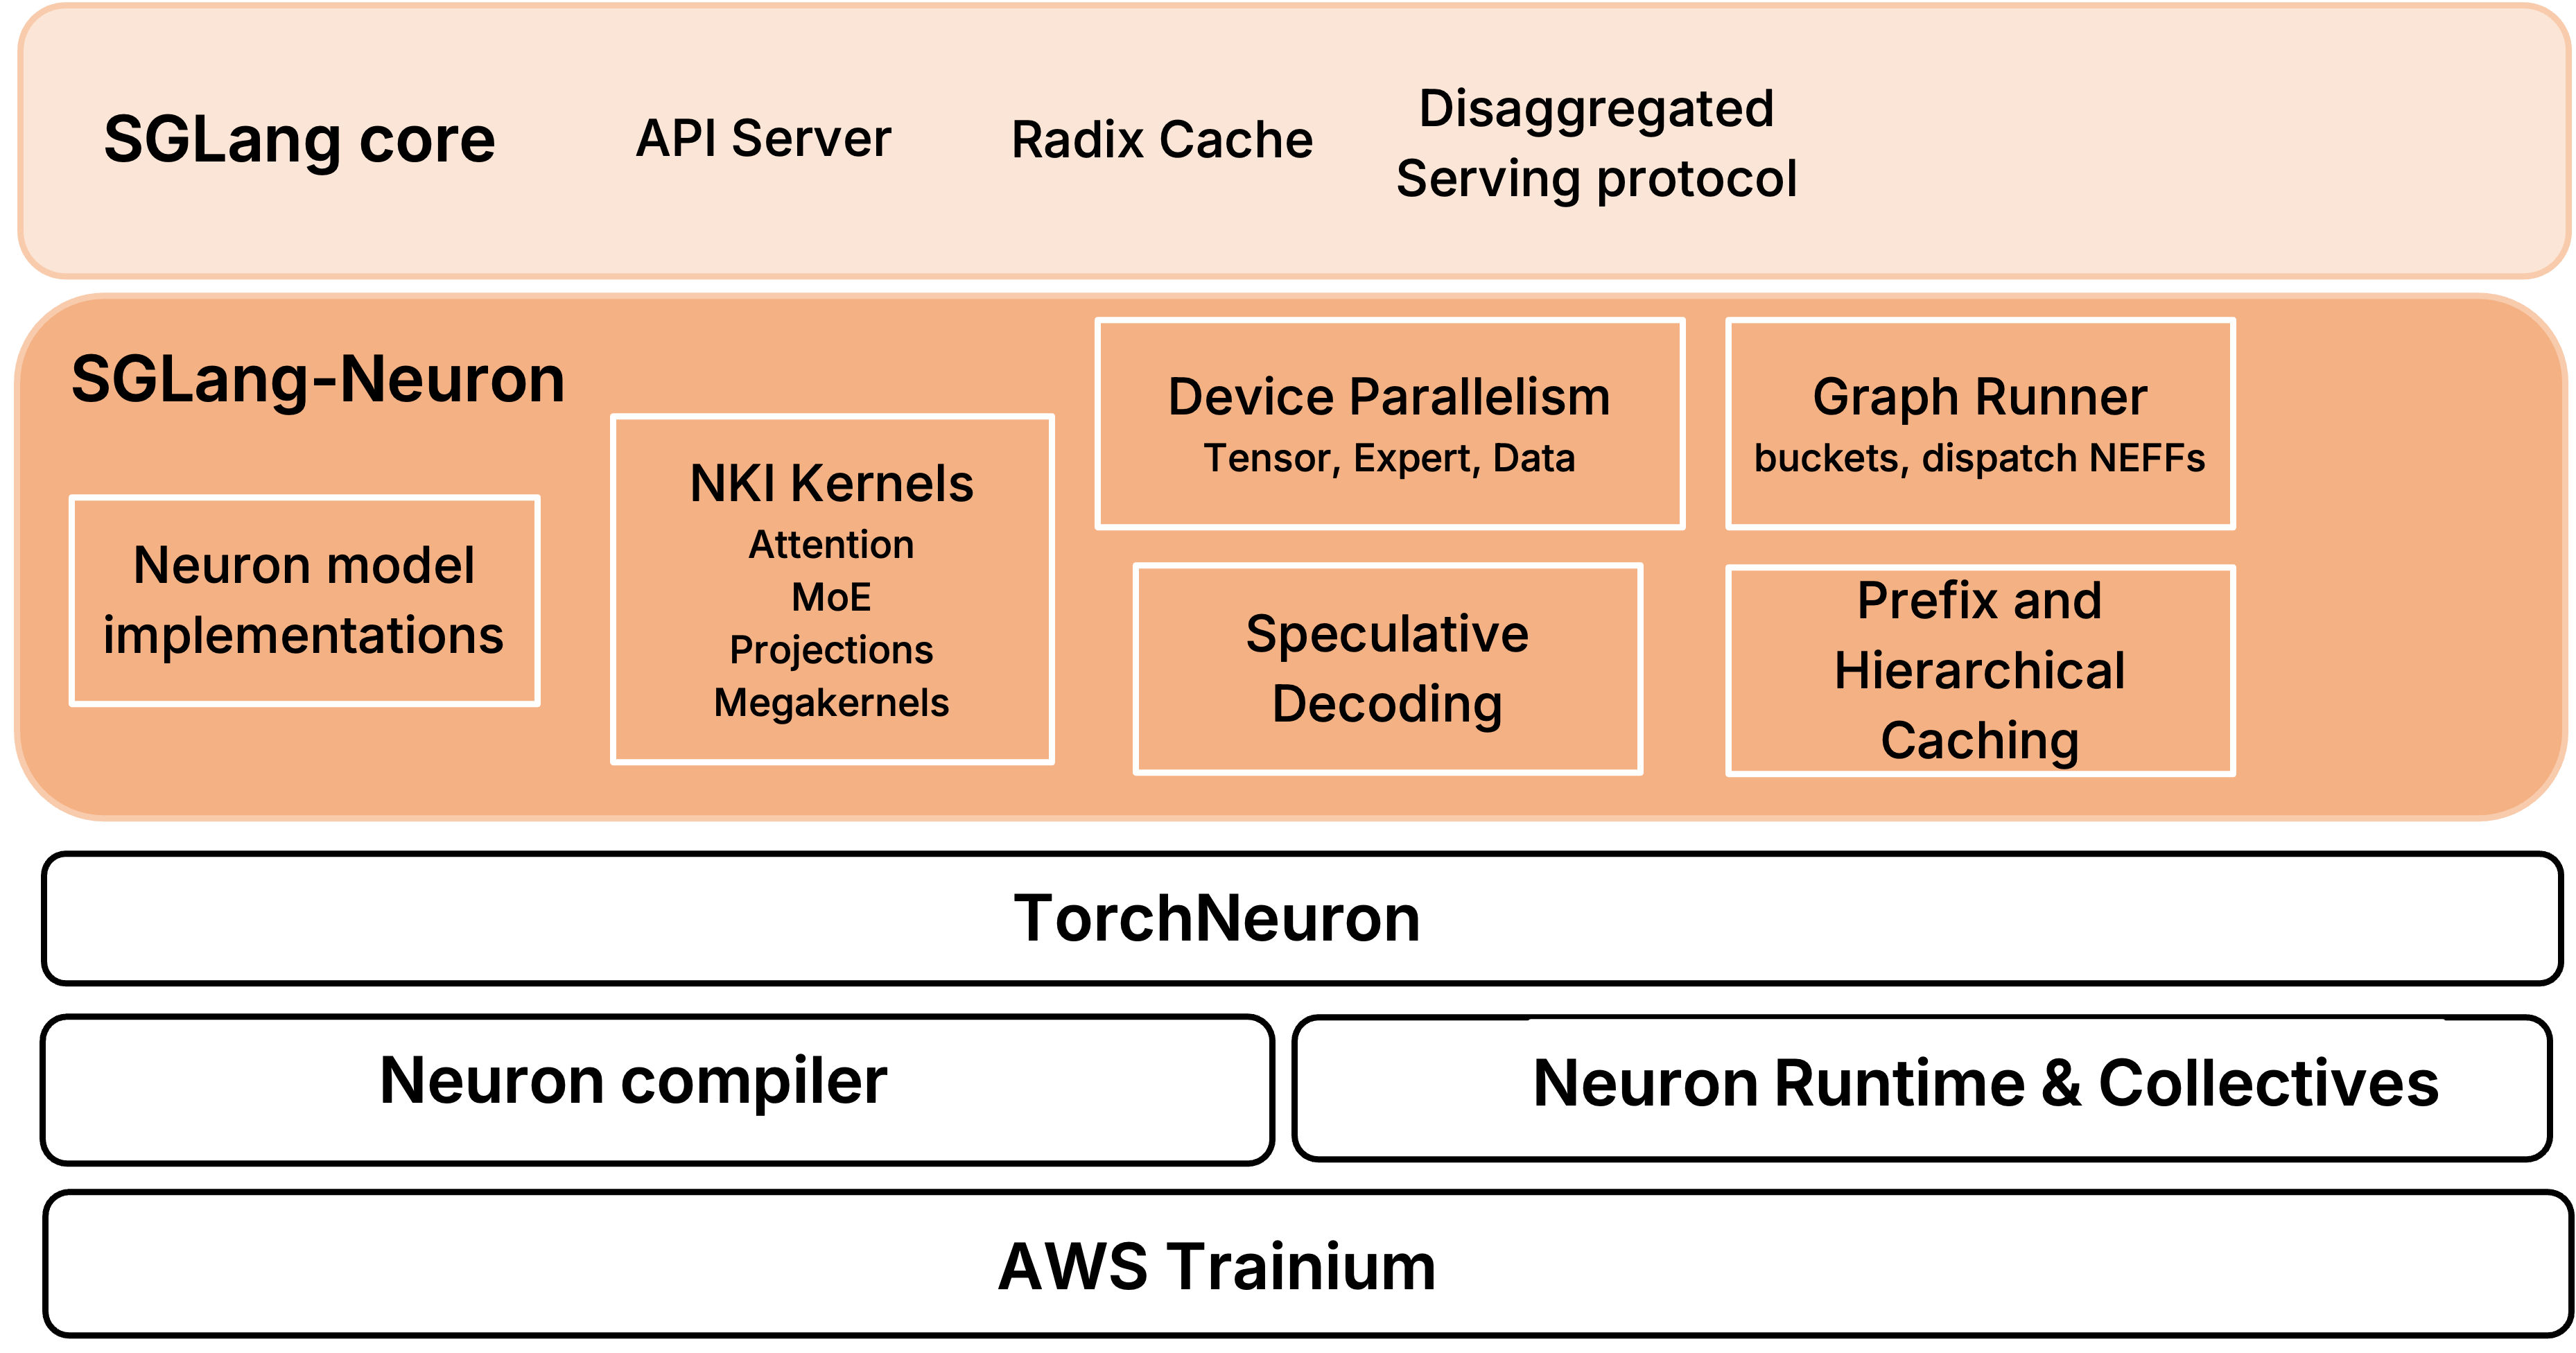
AWS推出SGLang-Neuron插件,支持在Trainium芯片上高效部署前沿AI模型,结合PyTorch和Neuron技术提升性能。

入选理由:SGLang-Neuron通过PyTorch和NKI内核实现Trainium芯片的高效模型执行

精选文章#AWS#Trainium#SGLang#Neuron#AI模型英文
Machine Learning Mastery 图标

Attention Variants and Memory Efficiency

Machine Learning Mastery3078 字 (约 13 分钟)
85

不同注意力机制对模型推理内存需求影响显著,选择合适变体可优化服务容量。

入选理由:MHA与GQA的KV缓存需求差异可达300%(基于参数量相同模型)

精选文章#Transformer#注意力机制#内存优化#模型推理#Hugging Face英文
Introducing TPU Sync: Fast KV cache and weight transfer for inference and RL on TPU

TPU Sync通过异步DMA传输和共享内存架构,将TPU推理延迟降低90%,并实现强化学习中权重的高效传输。

入选理由:TPU Sync使KV缓存传输延迟降低90%,TTFT缩短90%(235B-480B模型)

精选文章#TPU#KV缓存#强化学习#Google Cloud#AI基础设施英文
Machine Learning Mastery 图标

Floating-Point Precision and Its Effects to Model Inference

Machine Learning Mastery2017 字 (约 9 分钟)
85

浮点精度影响模型推理性能,需权衡精度、范围与硬件效率,PyTorch提供工具评估精度限制。

入选理由:浮点精度影响模型推理速度与数值稳定性,需根据硬件特性选择格式。

精选文章#浮点精度#模型推理#PyTorch#机器学习英文
freeCodeCamp.org 图标

High-Speed Decision Pipelines: Jev and Prefill-Only Inference from Scratch

freeCodeCamp.org378 字 (约 2 分钟)
85

本文介绍了通过Prefill-Only架构实现高速决策模型的方法,可减少90%的推理延迟。

入选理由:Prefill-Only架构可消除逐词解码循环,使分类任务延迟降低至毫秒级

精选文章#PyTorch#决策模型#深度学习#高效推理英文
Build Your Own Reasoning Model: A Full Video Course

Build Your Own Reasoning Model: A Full Video Course

Ahead of AI2321 字 (约 10 分钟)
85

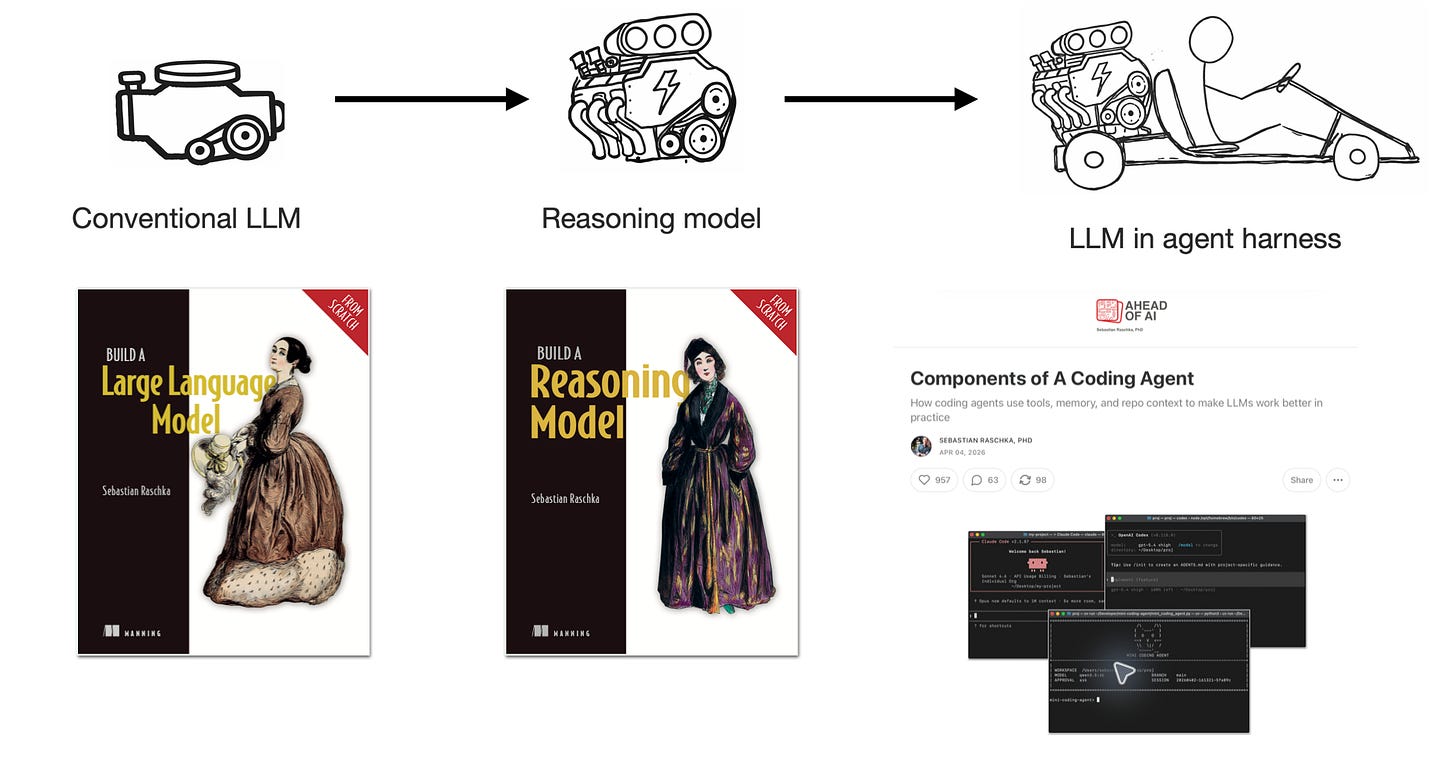
Sebastian Raschka的课程详细讲解了如何从零构建推理模型,涵盖强化学习、蒸馏等技术,适合Python和PyTorch开发者。

入选理由:课程包含8个视频,总时长11小时,覆盖推理模型评估与优化方法

精选文章#PyTorch#LLM#强化学习#推理模型英文
Accelerating PyTorch on AMD GPUs with FlyDSL

Accelerating PyTorch on AMD GPUs with FlyDSL

PyTorch Blog4733 字 (约 19 分钟)
85

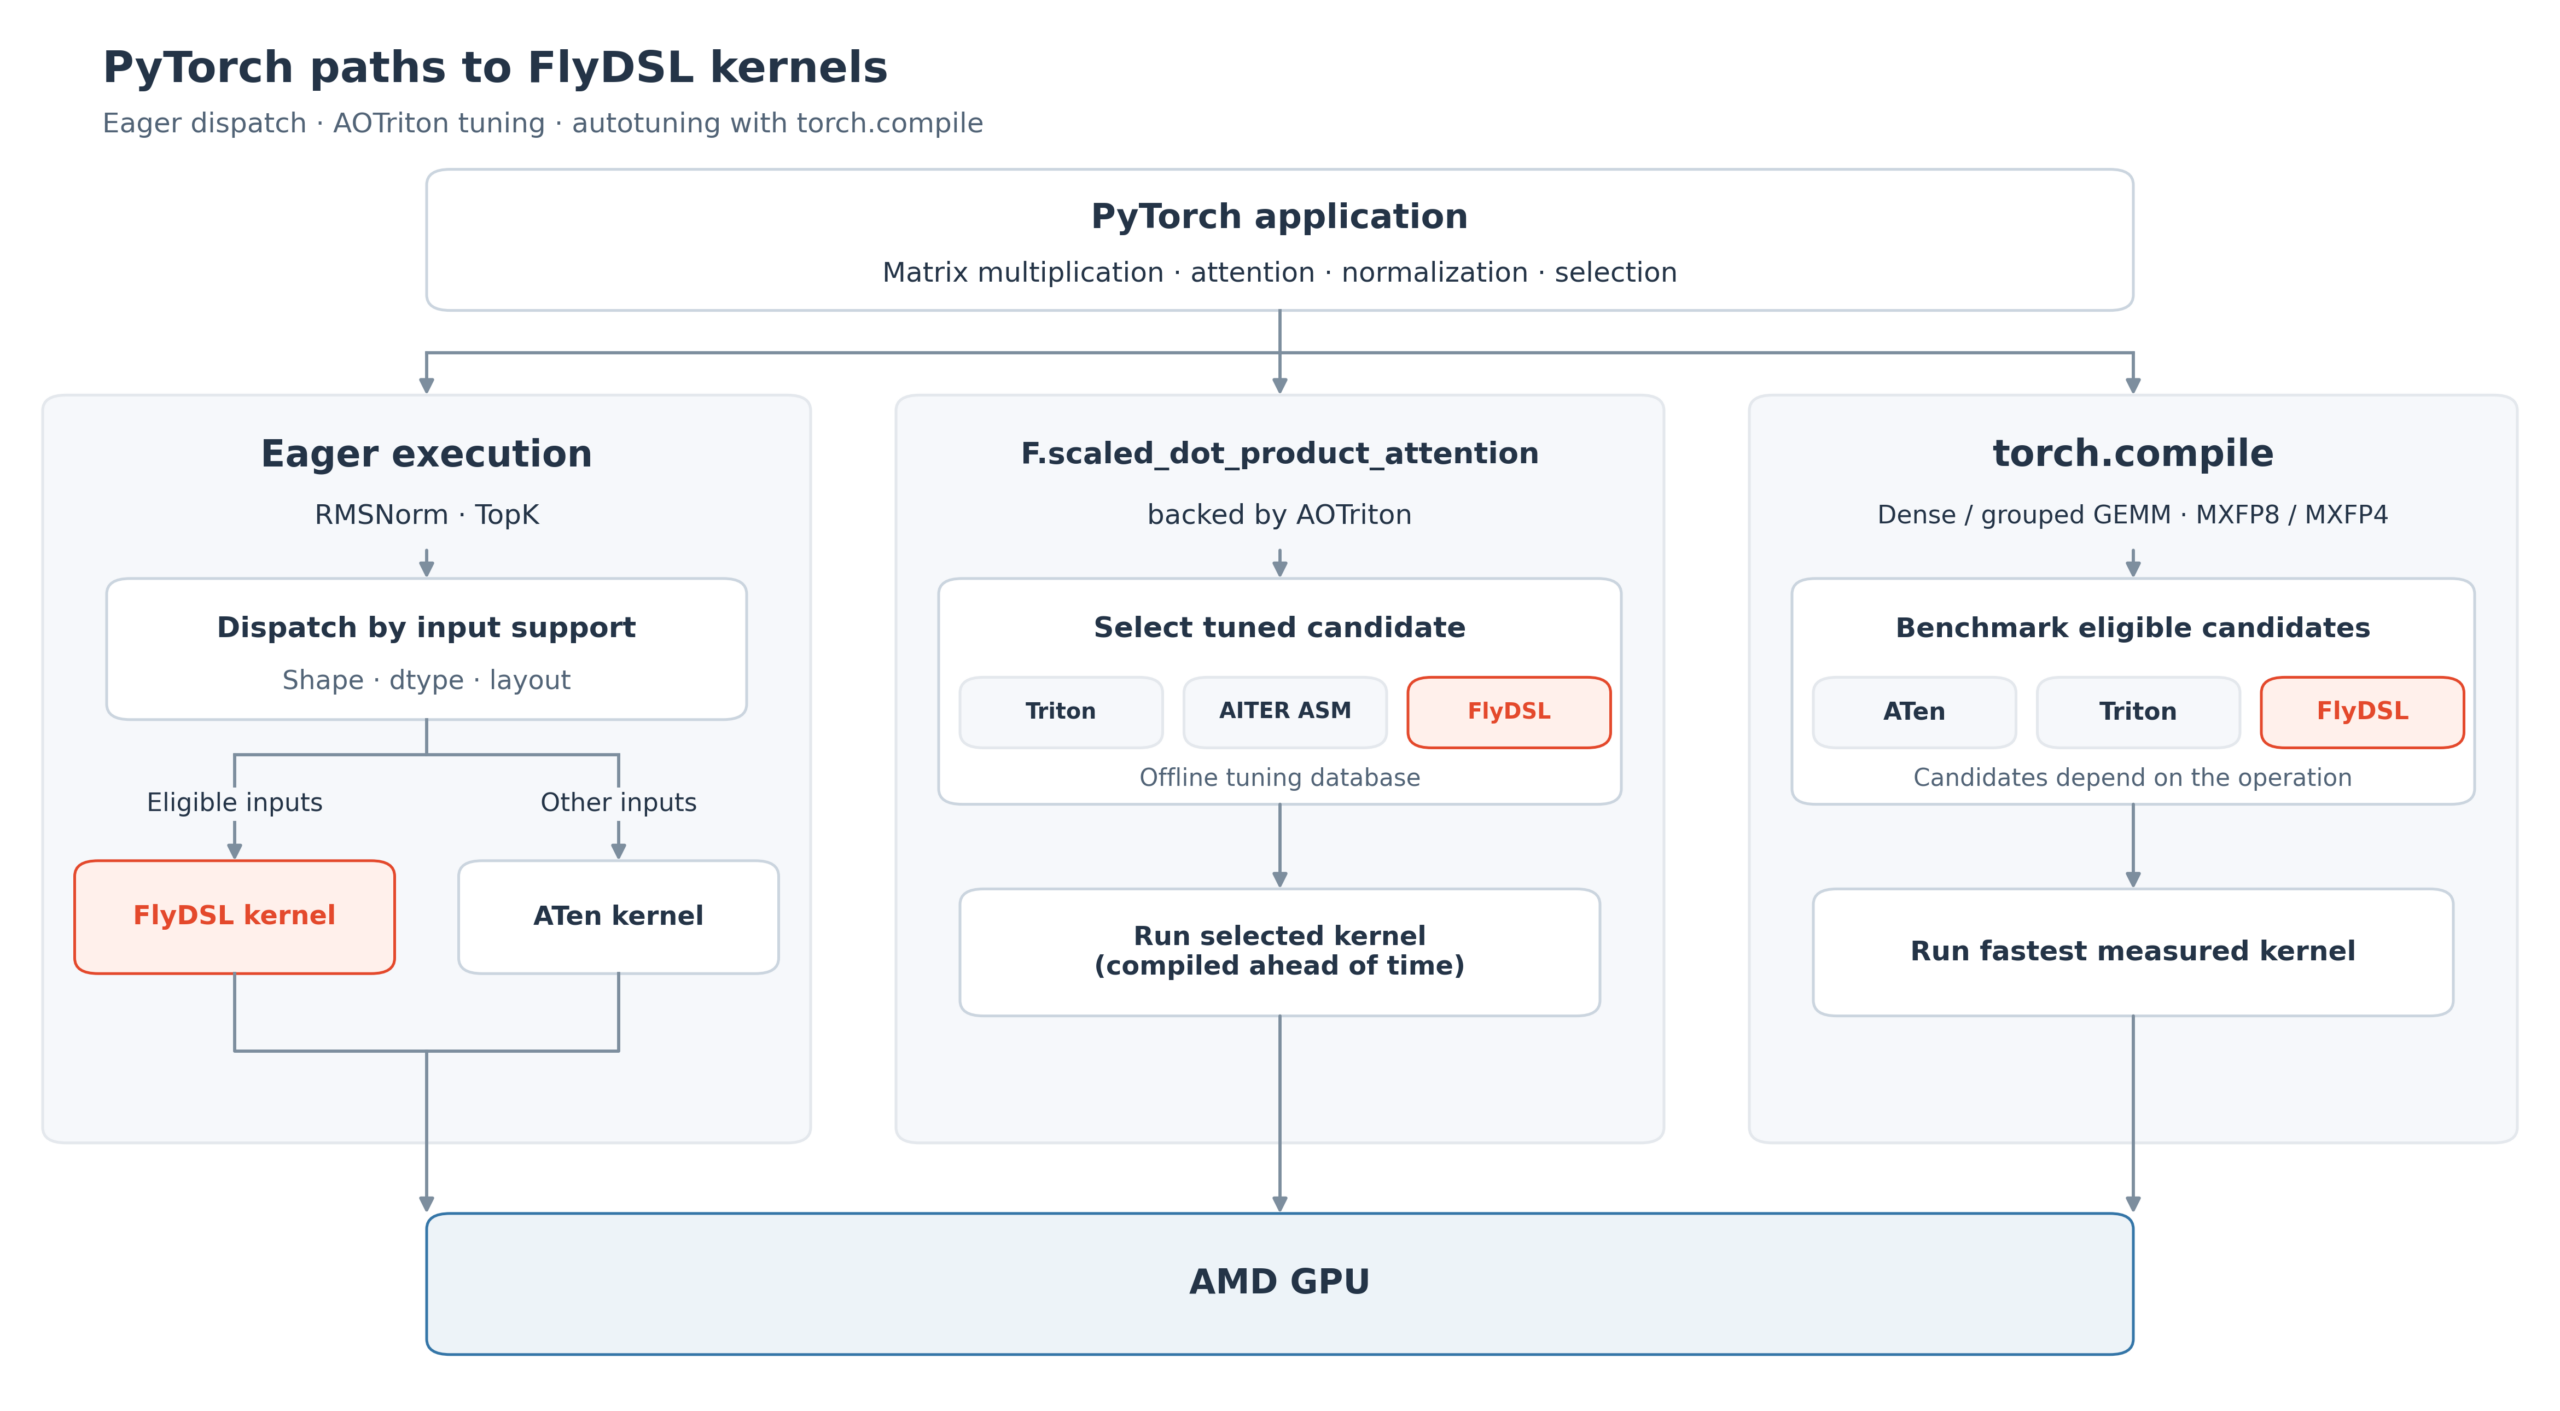
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。

入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准

精选文章#PyTorch#AMD GPU#FlyDSL#性能优化#深度学习框架英文
PyTorch Hardware Enablement: Updates from the Acceleration Integration Working Group

PyTorch加速器集成工作组在2026上半年推动跨平台硬件标准化,通过CRCR机制和测试套件重构提升集成效率。

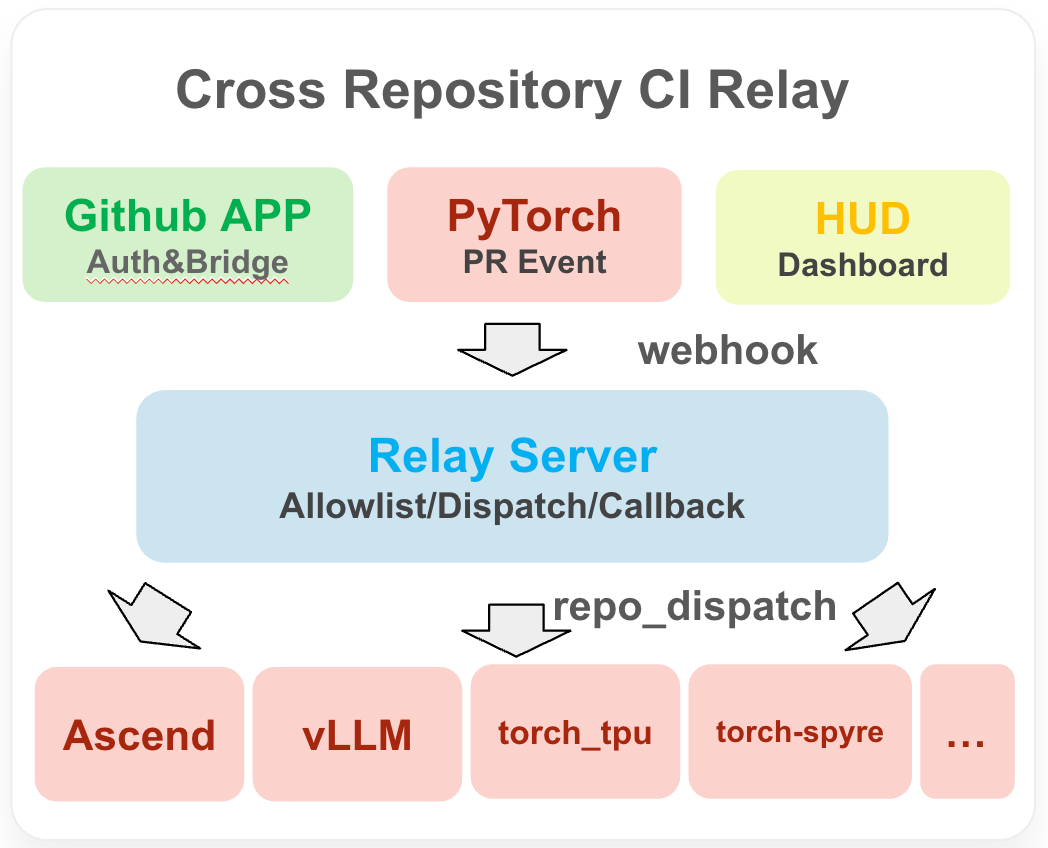
入选理由:CRCR机制实现跨仓库CI自动化协调,减少集成延迟

精选文章#PyTorch#硬件集成#CI/CD#开源生态英文
PyTorch Blog 图标

A Ray-Focused Guide to PyTorch Conference North America

PyTorch Blog1573 字 (约 7 分钟)
85

Ray框架成为AI基础设施标准,与Kubernetes整合构建统一AI栈,LinkedIn展示三层PyTorch训练架构。

入选理由:Ray与Kubernetes协同进化是AI基础设施核心趋势

精选文章#PyTorch#Ray#Kubernetes#分布式计算#AI基础设施英文
Accelerate Your AI Journey with new Introduction Track at PyTorch Conference NA 2026 and PyTorch Associate Training

PyTorch 2026北美会议新增入门课程与认证培训,覆盖GPU编程、模型优化等核心技能,适合不同层次开发者系统提升实战能力。

入选理由:2026年10月19日加州圣何塞将举办PyTorch Associate认证培训(9am-5pm)

精选文章#PyTorch#机器学习#GPU编程#AI培训英文
TinyTorch: Don’t Just Import PyTorch. Build It.

TinyTorch: Don’t Just Import PyTorch. Build It.

PyTorch Blog2772 字 (约 12 分钟)
85

TinyTorch是PyTorch官方推出的开源教学框架,通过纯Python实现从张量到Transformer的完整构建,帮助学习者深入理解机器学习框架内部机制。

入选理由:TinyTorch可在4GB内存设备上运行,无需GPU

精选文章#PyTorch#教育#开源#机器学习框架英文
How Shopify built a continual learning loop with PyTorch and vLLM

How Shopify built a continual learning loop with PyTorch and vLLM

PyTorch Blog2165 字 (约 9 分钟)
85

Shopify通过PyTorch和vLLM构建持续学习循环,将生产失败转化为模型权重,提升质量并降低96%服务成本。

入选理由:使用PyTorch和vLLM构建持续学习循环可降低96%服务成本

精选文章#PyTorch#vLLM#持续学习#机器学习#Shopify英文
freeCodeCamp.org 图标

Hands-On Evolution of Deep Learning – Geoffrey Hinton’s AI Legacy

freeCodeCamp.org330 字 (约 2 分钟)
85

本文介绍一门27小时深度学习课程,系统复现Geoffrey Hinton的突破性研究,涵盖从Boltzmann机到AlexNet等核心算法的PyTorch实现。

入选理由:课程复现Hinton的15项深度学习突破,包括AlexNet和Dropout等关键算法

精选文章#深度学习#Geoffrey Hinton#PyTorch#AI课程英文
From Video to Voice: Build Faster with TensorRT Model Connect

From Video to Voice: Build Faster with TensorRT Model Connect

NVIDIA Developer6926 字 (约 28 分钟)
85

NVIDIA TensorRT Model Connect工具通过两步命令实现模型快速部署,结合TensorRT优化技术显著加速推理过程。

入选理由:使用TensorRT Model Connect可将PyTorch模型转换为部署包仅需两步命令

精选视频#TensorRT#模型部署#NVIDIA#AI工具英文
PyTorch 2.14 Release Blog

PyTorch 2.14 Release Blog

PyTorch Blog8497 字 (约 34 分钟)
85

PyTorch 2.14 引入 NVGEMM 性能优化、Apple Silicon 原生线性代数支持及分布式容错机制,显著提升大规模训练和推理效率。

入选理由:NVGEMM 技术使 CUTLASS 内核融合效率提升 30% 以上

精选文章#PyTorch#深度学习#AI框架#分布式计算#硬件支持英文
PyTorch x Hugging Face in Bengaluru: Building India’s Next Generation of ML Systems Contributors

印度正通过PyTorch与Hugging Face合作培养下一代AI系统构建者,聚焦分布式训练、推理优化等基础设施技术。

入选理由:PyTorch profiling工具链包含record_function和profile API,可分离等待/预热/采集阶段

精选文章#PyTorch#Hugging Face#AI基础设施#分布式训练#印度英文
Cambricon Joins the PyTorch Foundation as a Platinum Member

Cambricon Joins the PyTorch Foundation as a Platinum Member

PyTorch Blog967 字 (约 4 分钟)
85

Cambricon成为PyTorch基金会铂金会员,致力于推动AI芯片与PyTorch生态的深度整合。

入选理由:Cambricon在PyTorch中贡献了torch.compile、Eager Operators等核心模块。

精选文章#PyTorch#AI芯片#开源生态#Cambricon#深度学习英文
Red Hat AI 图标

How AI inference works, clearly explained

Red Hat AI2212 字 (约 9 分钟)
85

AI推理依赖模型权重、推理服务器和GPU协同工作,KV缓存优化可降低延迟和成本。

入选理由:推理服务器(如vLLM)是实现生产级GPU利用率的关键组件

精选文章#AI推理#LLM#KV缓存#优化#Red Hat英文
PyTorch Blog 图标

Core PyTorch Sessions at PyTorch Conference North America 2026

PyTorch Blog2375 字 (约 10 分钟)
85

PyTorch 2026年北美会议展示编译器优化、跨仓库CI Relay和AI代理在发布工程中的应用,加速器后端兼容性验证时间缩短至分钟级。

入选理由:Cross-Repo CI Relay使Ascend NPU/RISC-V后端兼容性检测从天级缩短至分钟级

精选文章#PyTorch#AI#发布工程#CI/CD#分布式计算英文
Machine Learning Mastery 图标

Using a Transformer Model: From Training to Inference

Machine Learning Mastery2974 字 (约 12 分钟)
85

Transformer模型推理需通过自回归生成和键值缓存优化性能,PyTorch实现细节揭示训练与推理的核心差异。

入选理由:自回归生成需逐个生成token,依赖前序所有输出

精选文章#Transformer#PyTorch#推理优化#机器学习英文

跨材料问答 · PyTorch

回答基于:PyTorch 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容