T
traeai
登录

概念

Prompt Caching

别名:提示缓存

AI代理中优化成本的缓存技术

已跟踪 8 条高相关材料

TraeAI 观察

相关材料

已收录 8 条与 Prompt Caching 相关的内容,按评分排序。

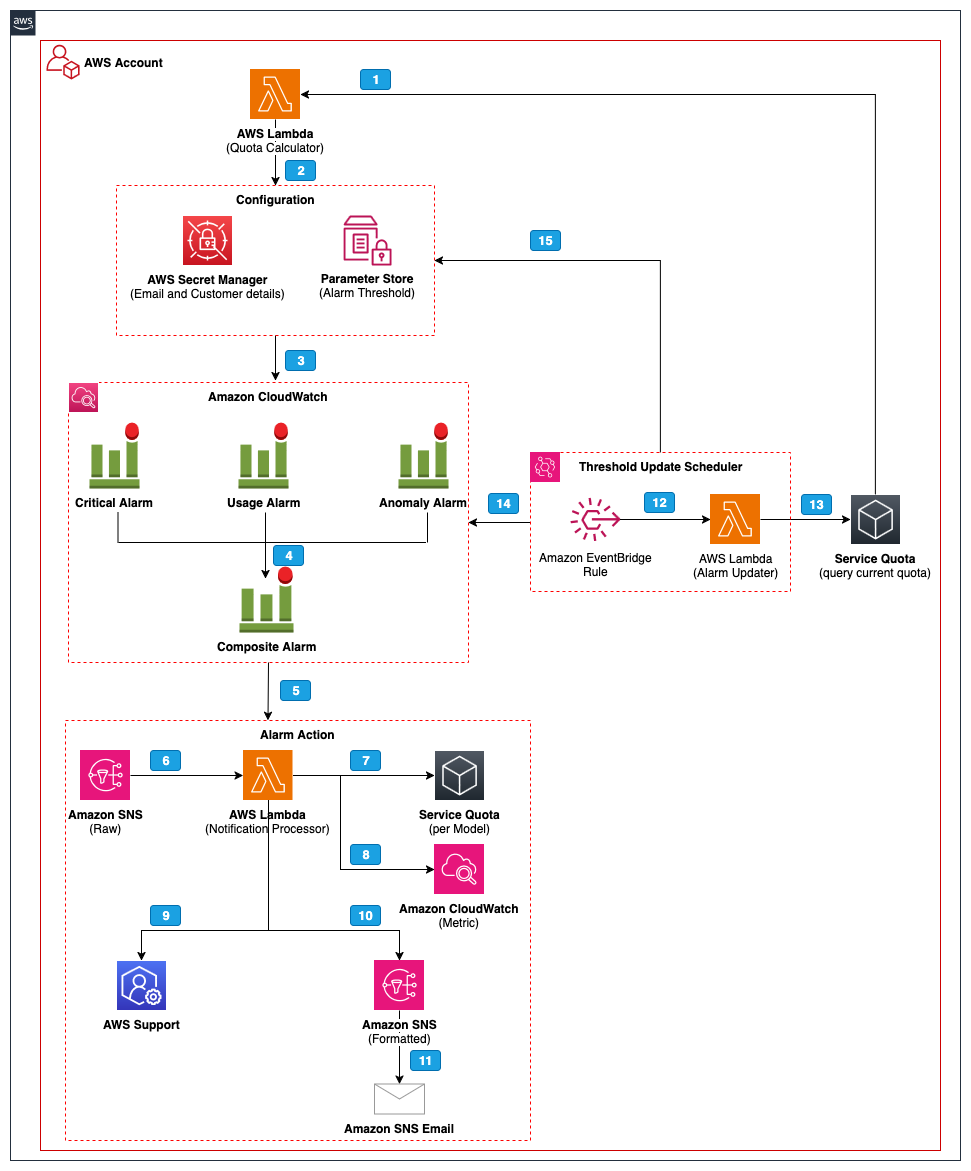
How to build self-driving AI operations on Amazon Bedrock at scale

在 Amazon Bedrock 上规模化构建自驱动 AI 运营

AWS Machine Learning Blog4312 字 (约 18 分钟)
87

通过 Amazon Bedrock Ops Alert 构建自驱动 AI 运营,提供多层主动监控、动态阈值、分类与自动工单、去重与上下文通知,显著降低运维开销并提升故障响应。

入选理由:使用 Amazon Bedrock Ops Alert 实现自驱动 AI 运营,减少 70%+ 手动运维开销并提升 MTTi。

精选文章#Amazon Bedrock#Ops Alert#AI SRE#全球跨区域推理#Prompt 缓存英文
主会话 + Thread 的模式,优化好的话 Token 消耗其实还好。

首先主会话反而不需要特别强的模型,Sonnet 5.5 这个级别都够用了,因为它的主要职责是甄别和路由,或者说调度。

就跟...

主会话与 Thread 模式结合,通过合理调度模型和使用缓存策略,可有效降低 Token 消耗。

入选理由:主会话使用 Sonnet 5.5 级别模型已足够,因其主要负责甄别和调度。

精选推文#AI#模型调度#Token 消耗#Prompt Caching中文
Four Amazon Bedrock inference choices that affect cost

Four Amazon Bedrock inference choices that affect cost

AWS Machine Learning Blog2214 字 (约 9 分钟)
85

Amazon Bedrock推理成本受缓存时长、服务层级、推理强度和maxTokens影响,需根据模型特性优化配置。

入选理由:Anthropic模型5分钟缓存写入成本是输入费率的1.25倍,1小时写入是2倍

精选文章#AWS#机器学习#成本优化#Amazon Bedrock英文
Prompt Caching Explained: Stop Overpaying for AI Agents

Prompt Caching Explained: Stop Overpaying for AI Agents

Hugging Face3347 字 (约 14 分钟)
85

正确实现Prompt Caching可避免AI代理重复计费,节省高达90%的上下文处理成本。

入选理由:缓存LLM输出无效,应缓存输入prompt以避免重复处理

精选视频#AI代理#Prompt Caching#LLM优化#成本控制英文
频繁到 80% 并不是什么大问题,compact 并不会频繁执行,因为执行太多一方面影响正在执行任务上下文准确性(也许压缩后,需要重新补充上下文),一方面也不能充分利用 Prompt Caching。...

Codex上下文优化策略:无需频繁compact,合理使用handoff和Prompt Caching可保持性能,模型自身处理能力已足够强。

入选理由:Codex上下文压缩机制可减少80%token消耗,无需频繁执行compact

精选推文#Codex#Prompt Caching#上下文优化#AI模型#token管理中文
现在 Codex/Claude Code 的上下文压缩确实做的挺好了,加上 Prompt Caching,一个 Session 内持续聊没那么大成本压力了。我现在也越来越多的在一个会话内继续任务。

...

Codex 和 Claude Code 的上下文压缩与 Prompt Caching 技术显著降低了持续会话的成本,同时支持分支和侧边提问功能,提升交互效率。

入选理由:Codex 和 Claude Code 的上下文压缩技术有效降低会话成本。

精选推文#Codex#Claude#AI#Prompt Caching中英混合

跨材料问答 · Prompt Caching

回答基于:Prompt Caching 相关 8 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容