Building Graph-Enhanced GenAI Applications with graphrag-toolkit
KDnuggets3368 字 (约 14 分钟)
85
GraphRAG通过知识图谱增强检索,解决传统RAG在处理复杂关系查询时的不足,AWS开源工具链实现多跳研究助手构建。
入选理由:GraphRAG利用知识图谱连接分散信息,提升复杂查询准确性达30%以上
精选文章#GraphRAG#知识图谱#RAG#Neo4j#pgvector英文
产品
别名:pgvector扩展
PostgreSQL向量检索扩展
已跟踪 5 条高相关材料
最近变化
2026-11-12 · GraphRAG利用知识图谱连接分散信息,提升复杂查询准确性达30%以上
为什么值得关注
pgvector 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Building Graph-Enhanced GenAI Applications with graphrag-toolkit
KDnuggets · 8.5 分
GraphRAG通过知识图谱增强检索,解决传统RAG在处理复杂关系查询时的不足,AWS开源工具链实现多跳研究助手构建。
CoreWeave Database Is Here: Managed PostgreSQL Where Your AI Runs
CoreWeave · 8.5 分
CoreWeave推出托管PostgreSQL数据库,专为AI工作负载优化,实现与GPU同集群部署、自动备份及高可用性。
Build a Hybrid Search Engine in PostgreSQL: BM25 + Vector Retrieval
freeCodeCamp.org · 8.5 分
PostgreSQL可通过BM25和向量检索构建混合搜索引擎,无需依赖Elasticsearch。
已收录 5 条与 pgvector 相关的内容,按评分排序。
GraphRAG通过知识图谱增强检索,解决传统RAG在处理复杂关系查询时的不足,AWS开源工具链实现多跳研究助手构建。
入选理由:GraphRAG利用知识图谱连接分散信息,提升复杂查询准确性达30%以上
CoreWeave推出托管PostgreSQL数据库,专为AI工作负载优化,实现与GPU同集群部署、自动备份及高可用性。
入选理由:CoreWeave Database支持现有PostgreSQL无缝迁移,兼容原生工具。
PostgreSQL可通过BM25和向量检索构建混合搜索引擎,无需依赖Elasticsearch。
入选理由:使用pg_textsearch实现BM25关键词匹配,pgvector存储384维句子嵌入
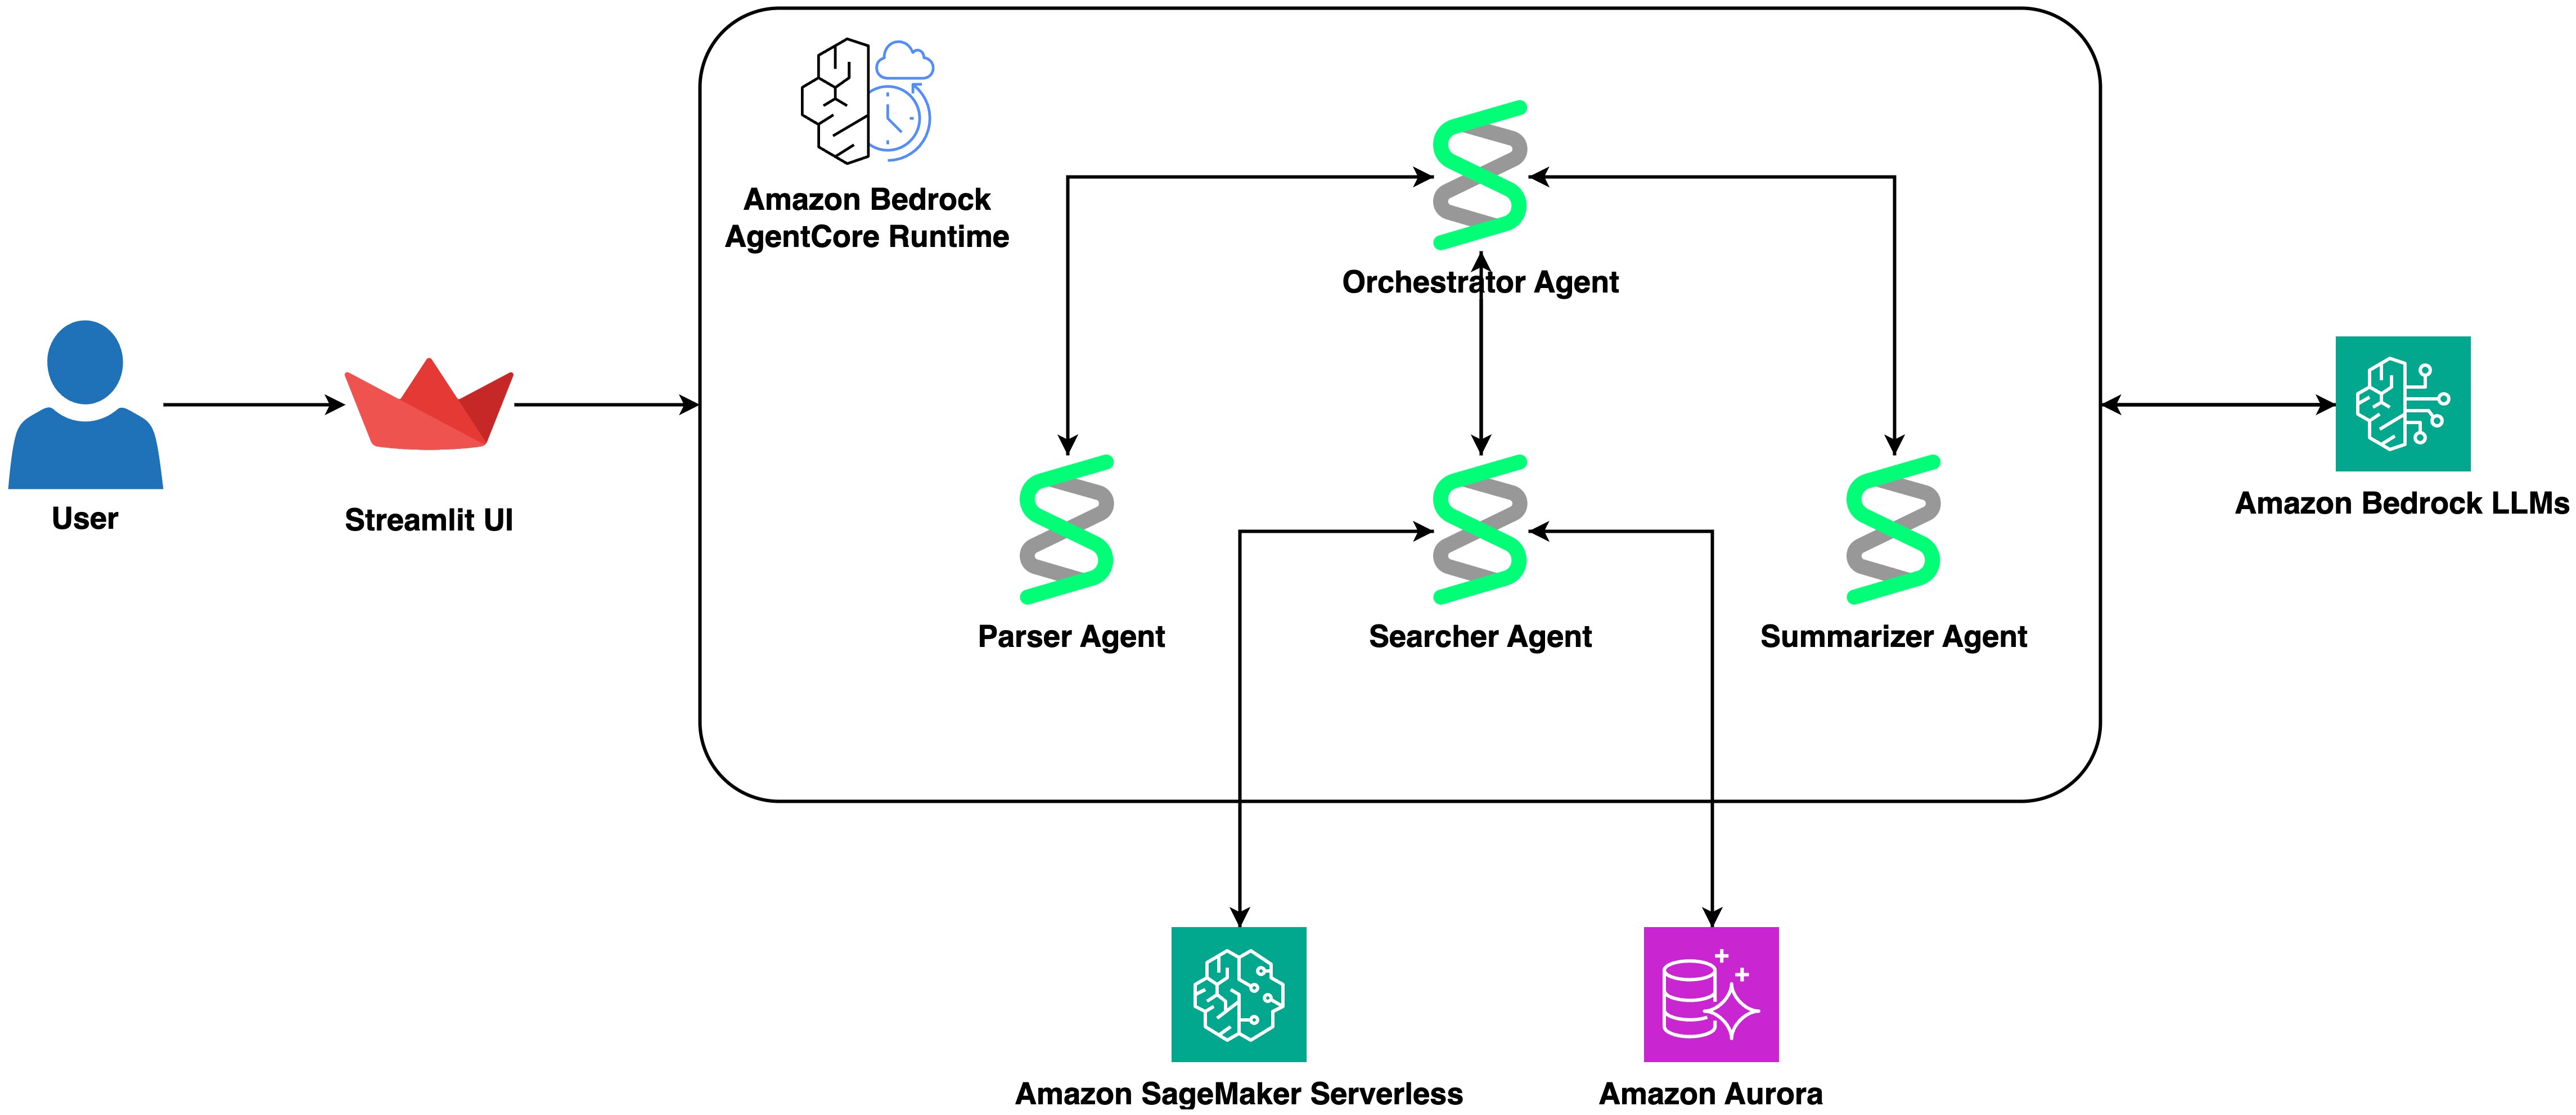
本文展示如何使用 Amazon Bedrock AgentCore 构建蛋白质研究助手,实现自然语言查询、向量相似性搜索和 AI 结果总结。
入选理由:使用 Strands Agents SDK 解析自然语言查询为结构化参数。
Agent 的存算分离架构通过将存储与计算解耦,实现云端 Agent 的可扩展性与安全性,关键在于使用 kv、db、向量数据库和对象存储分层管理数据,并结合 sandbox 和 serverless 模式提升效率。
入选理由:Agent 的生命周期包含读取提示词、工具、记忆、构建上下文、执行 Loop 并交付结果等步骤。