Import AI 481: AI sub-contractors; a wet lab for AI; and subterfuge during development
Import AI2731 字 (约 11 分钟)
85
AI系统现在能通过分配资金提升自身性能,FrontierML基准测试显示,AI在多个任务中能有效利用资本优化模型。
入选理由:AI系统在给定资金后,能通过训练计算和数据提升自身性能。
精选文章#AI#机器学习#FrontierML#模型优化英文
产品
别名:Claude Opus 5.5
运动设计软件
已跟踪 30 条高相关材料
最近变化
2026-11-16 · AI系统在给定资金后,能通过训练计算和数据提升自身性能。
为什么值得关注
Opus 5.5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Import AI 481: AI sub-contractors; a wet lab for AI; and subterfuge during development
Import AI · 8.5 分
AI系统现在能通过分配资金提升自身性能,FrontierML基准测试显示,AI在多个任务中能有效利用资本优化模型。
主会话 + Thread 的模式,优化好的话 Token 消耗其实还好。 首先主会话反而不需要特别强的模型,Sonnet 5.5 这个级别都够用了,因为它的主要职责是甄别和路由,或者说调度。 就跟...
宝玉(@dotey) · 8.5 分
主会话与 Thread 模式结合,通过合理调度模型和使用缓存策略,可有效降低 Token 消耗。
well if you were wondering why the Chinese labs have been silent lately, here you go: the 2.4 TRILLION param Qwen4-Max. it actually beats Opus 5.5 on DeepSWE and Agents Last Exam in Qwen’s evals, and costs just $1.50/$4.50 per 1M input/output tokens, compared to Opus’s $4/$20. it also falls behind substantially in some other benchmarks so take the numbers with a grain of salt, but compared to Qwen3.8-Max, it’s a giant leap. I just hope they drop a 27B soon too.
Hesam(@Hesamation) · 8.5 分
Qwen4-Max 是一个参数量达 2.4 万亿的模型,在部分基准测试中表现优于 Opus 5.5,且成本更低。
已收录 30 条与 Opus 5.5 相关的内容,按评分排序。
AI系统现在能通过分配资金提升自身性能,FrontierML基准测试显示,AI在多个任务中能有效利用资本优化模型。
入选理由:AI系统在给定资金后,能通过训练计算和数据提升自身性能。
主会话与 Thread 模式结合,通过合理调度模型和使用缓存策略,可有效降低 Token 消耗。
入选理由:主会话使用 Sonnet 5.5 级别模型已足够,因其主要负责甄别和调度。
Qwen4-Max 是一个参数量达 2.4 万亿的模型,在部分基准测试中表现优于 Opus 5.5,且成本更低。
入选理由:Qwen4-Max 在 DeepSWE 和 Agents Last Exam 基准测试中表现优于 Opus 5.5。
Claude Fable 5.2 (Max) 在 Agent Arena 中取得显著领先,性能比第二名 Opus-5.5 提升 30.4%。
入选理由:Claude Fable 5.2 (Max) 在 Agent Arena 中排名第一,性能比第二名 Opus-5.5 提升 30.4%。
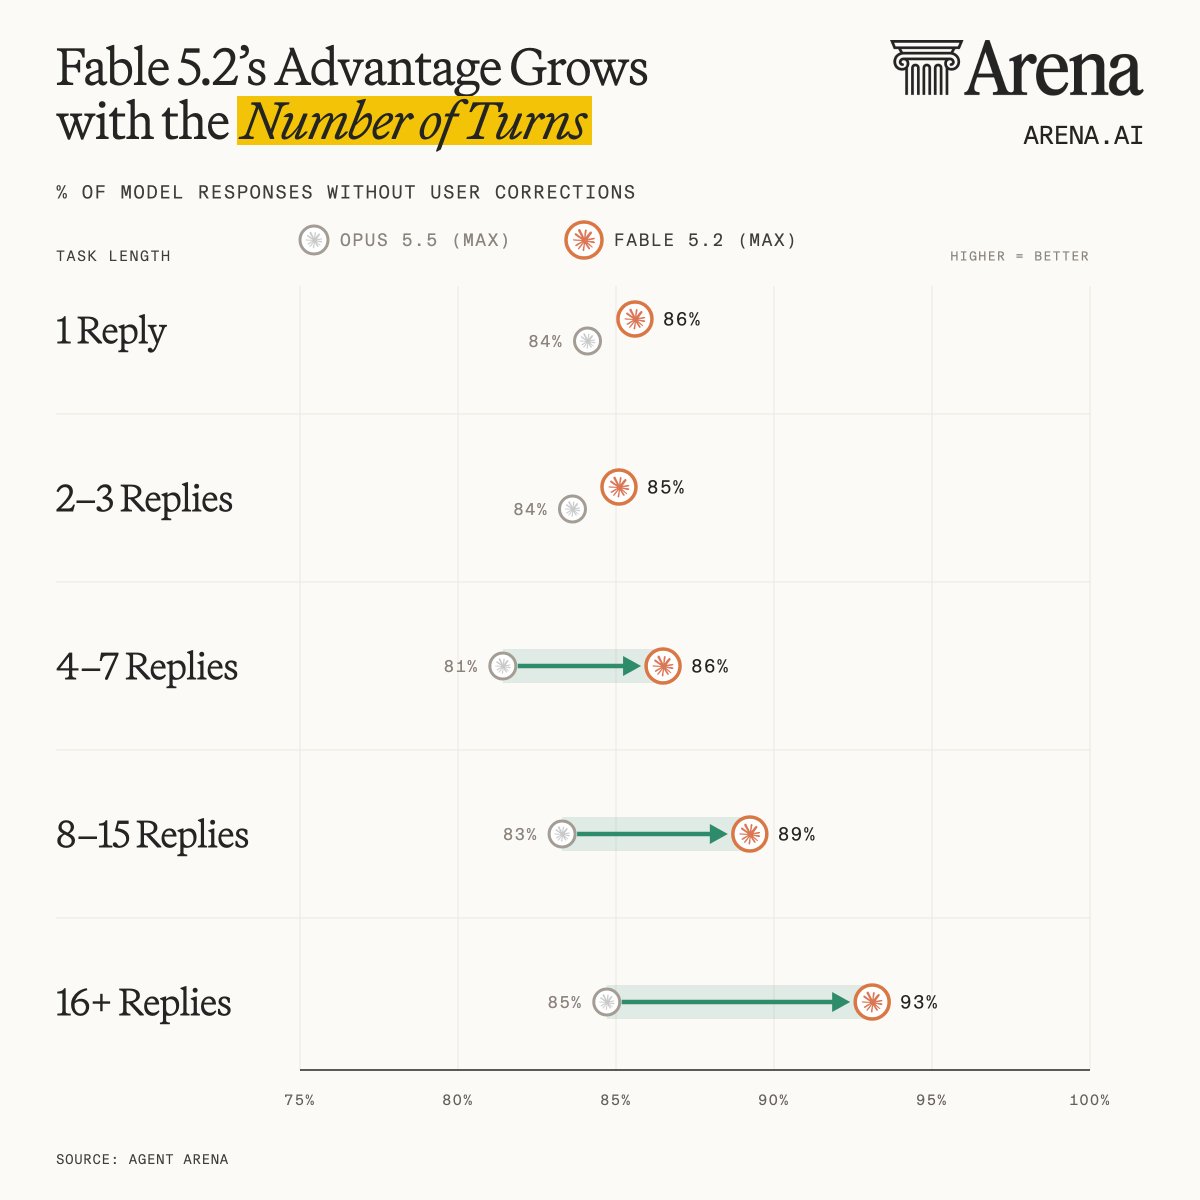
Fable 5.2在多轮对话任务中表现优于Opus 5.5,尤其在长任务中优势显著。
入选理由:Fable 5.2在8-15轮对话中准确率89%,优于Opus 5.5的83%。
ParseBench-2 是一个标准化的 OCR 工具评估框架,覆盖 40 个工具和 6 个维度,揭示了不同工具在特定场景下的表现差异。
入选理由:ParseBench-2 评估了 40 个 OCR 工具,覆盖 6 个维度,如表格、图表等。
Anthropic的Claude Fable 5.2在性能和成本优化上取得进展,但每任务成本增加。
入选理由:Fable 5.2输入/输出价格降20%,但任务成本因更多测试用例增加
Anthropic的Fable 5.2模型在视频生成、3D建模和复杂任务处理上表现突出,但网站设计能力仍需人工干预。
入选理由:Fable 5.2可将单条推文生成动画视频,效果优于传统幻灯片
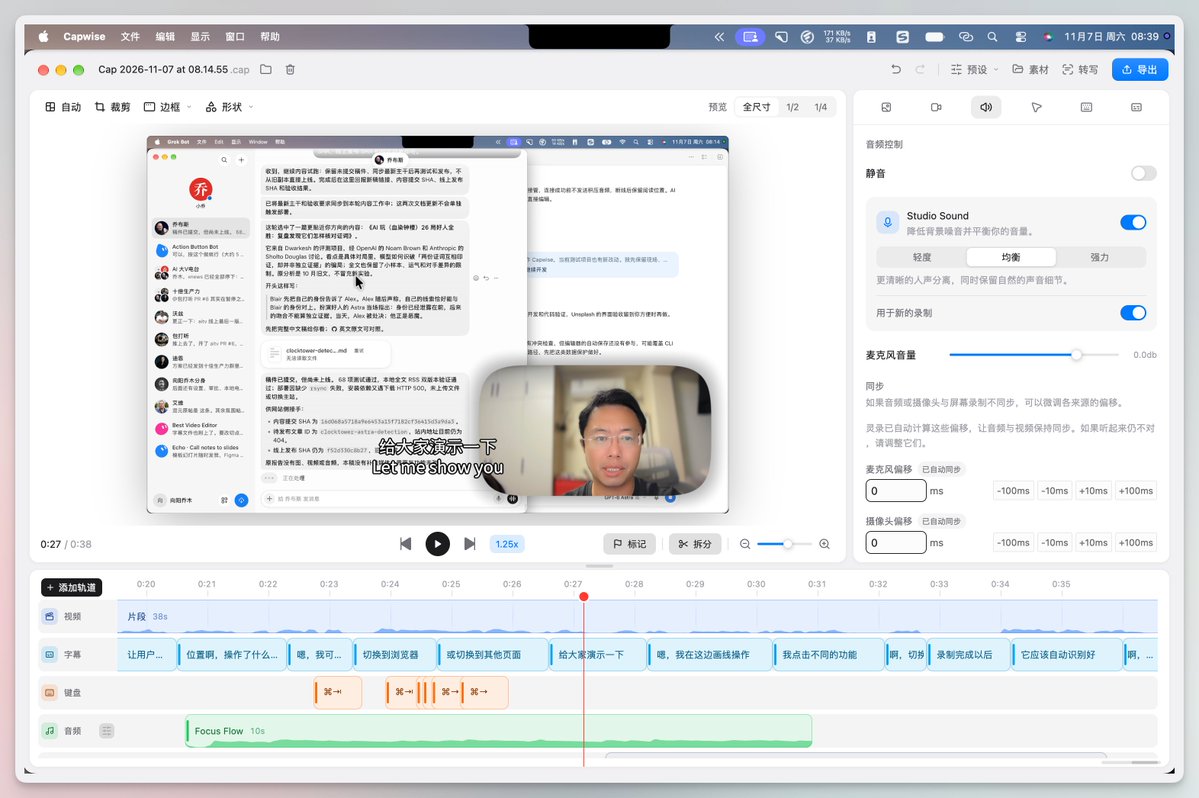
开源录屏工具 Capwise 完成第一版开发,集成 ASR/LLM 模型与素材库,计划下周开源。
入选理由:Capwise 集成本地和云端 ASR 模型实现双语字幕生成
llm 0.37 版本新增多个模型,优化默认配置,并改进嵌入支持,提升开发者使用体验。
入选理由:新增 gpt-6.1-sol 和 gpt-6.1-terra 模型,支持 OpenAI 兼容端点配置。
在Claude Code中,输入ultrathink可提升复杂任务的推理能力,适用于最新版本。
入选理由:使用ultrathink参数可增强Claude Code处理复杂任务的推理能力
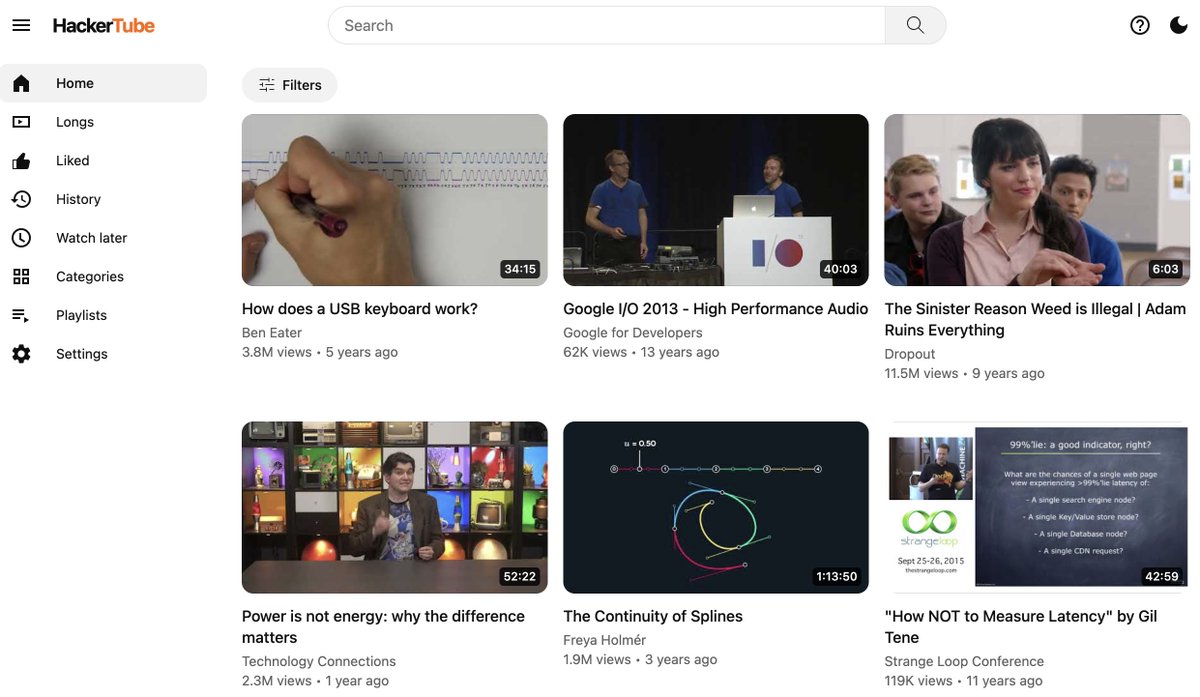
Andrej Karpathy利用Claude和Opus 5.5构建HackerTube,通过分析Hacker News评论生成高质量视频推荐,显著提升观看体验。
入选理由:使用Claude过滤43M评论生成6,454个推荐视频,观看时长缩短至2小时
Drew Breunig将NES模拟器嵌入Qwen3.5-4B模型权重,实现NES游戏在大模型中运行,展示了AI模拟硬件的潜力。
入选理由:Qwen3.5-4B模型成功嵌入NES模拟器,可运行超级马里奥等ROM(速度极慢)
Anthropic通过分离模型(Brain)与执行环境(Hands),实现Claude高效部署,降低运行成本并增强安全性。
入选理由:Opus 5.5模型运行成本降低,具体节省取决于工作负载和缓存上下文使用。
Kimi 3.1 Pro发布2.8T参数模型,Highspeed API提速2-3倍,独立测试排名第四。
入选理由:Kimi 3.1 Pro参数达2.8T,活跃参数104BA,支持100万token上下文。
Claude Duet是Claude推出的AI助手,具备任务自动化、多插件集成和智能简报功能,适合需要高效管理日常任务的用户。
入选理由:Claude Duet支持超过6000个插件和连接器
Meta Muse Wonder模型在代理任务中表现优异但设计能力薄弱,适合后端流程自动化但不适合前端交互。
入选理由:Muse Wonder在账单处理和邮件写作任务中准确率高达92%,但设计原型完成度仅达80%
Opus 5.5通过1个提示词实现视频全流程自动化编辑,结合AI分析、云渲染和Blender模板,3487帧视频在20分钟内渲染成本低于1美元。
入选理由:Opus 5.5用1个提示词完成15步视频编辑流程,包含B-roll搜索和Blender场景构建
DeepSeek V4.1 Flash 1017在浏览器使用场景中与Opus 5.5表现相当,但成本低19倍。
入选理由:DeepSeek V4.1 Flash 1017成本$0.22/task,仅为Opus 5.5的1/10.7
AI通过单条提示词在30小时内自主构建了包含CPU、操作系统和3D可视化的完整计算机系统,展示了AI在复杂工程中的潜力。
入选理由:Opus 5.5在Ultracode模式下30小时完成完整计算机系统构建
AI生成的完整计算机系统展示277k逻辑门和操作系统,但实际工程应用价值待验证。
入选理由:Opus 5.5模型用JavaScript实现277k逻辑门计算机
本文详解使用Opus 5.5/Astra/Tripo等工具制作3D叙事游戏的全流程,包含资产生成到Unity部署的完整方案。
入选理由:Opus 5.5可生成高质量3D模型,减少70%手工建模时间
Gemini 4 Argon已全球发布,支持代码生成等场景,定价为每百万输入/输出令牌$2/$10,内部测试显示效率提升35%。
入选理由:Gemini 4 Argon定价为$2/$10每百万输入/输出令牌(11月30日后翻倍)
Meta的Muse Wonder Full在KingBench 4测试中表现优于标准版,但订阅费用较高。
入选理由:Muse Wonder Full在KingBench 4测试中完成率45.8%,优于标准版的45.8%(部分任务表现更优)
AI工具实现全自动化音乐视频生成,通过代码直接渲染导出1080p视频,展示跨领域技术整合能力。
入选理由:Claude可分离音频轨道并精确同步229个歌词字词
通过AI和WebAssembly技术,作者成功将Windows 3.1和经典游戏移植到浏览器,如今因AI辅助逆向工程而获得广泛关注。
入选理由:WebAssembly使Windows XP等系统可在浏览器中运行,支持8万人同时在线。
Claude Haiku 5.5在Devin中发布,性能优于Sonnet 5且成本降低至八分之一,适合与Opus 5.5搭配使用。
入选理由:Claude Haiku 5.5在FrontierCode 1.1上得分为58.4%
LlamaIndex推出Extract v2.5文档提取代理,错误率降低2倍且成本仅为前沿模型的1/4。
入选理由:Extract v2.5代理将文档提取错误率降低2倍以上
Llamaindex推出Extract v2.5代理,在密集表格提取任务中达到93%-96%准确率,显著优于现有模型。
入选理由:Extract v2.5在长列表提取任务中准确率达93%-96%,优于Astra的30%
Llamaindex的Extract v2.5代理在跨页表格处理上超越Opus 5.5和GPT-6 Sol,成本降低30%-4倍,适用于保险、法律等复杂文档场景。
入选理由:Extract v2.5代理处理跨页表格准确率超越Opus 5.5和GPT-6 Sol