T
traeai
登录

模型

Opus

别名:Opus模型

AnthropicAI的基准模型

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 Opus 相关的内容,按评分排序。

Anthropic 拆解智能体记忆:Claude 边干边记,再靠“做梦”回头纠错整理

Anthropic 工程团队 11 月 6 日发文,讲他们怎么给 Claude 设计跨会话的记忆。难点在于:Cl...

Anthropic 通过‘做梦’机制优化 Claude 跨会话记忆,提升模型学习效率与纠错能力。测试显示 Opus 5 记忆利用率较旧版本提升 200%。

入选理由:‘做梦’机制使 Opus 5 在数据库测试中得分从 0.564 提升至 0.828(满分 1)

精选推文#AI记忆机制#Claude#Anthropic#工程实践中文
Hacker News Best 图标

A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost

Hacker News Best2382 字 (约 10 分钟)
85

混合模型Jev+Opus可实现4倍成本下前沿级身份解析准确率,决策模型成本低但准确率不足。

入选理由:Jev+Opus混合模型成本降低4倍仍保持>95%准确率

精选文章#LLM#身份解析#决策模型#成本效益分析英文
I Built a Tiny Local Model That Outperforms Opus! (by using Orchestration)

作者构建了一个名为Panda Router的小型模型,通过任务分析和模型评分系统,优化模型选择,提升效率。

入选理由:Panda Router通过任务分析和模型评分(成功率、成本、速度)选择最佳模型。

精选视频#模型选择#Orchestration#Panda Router#任务分配英文
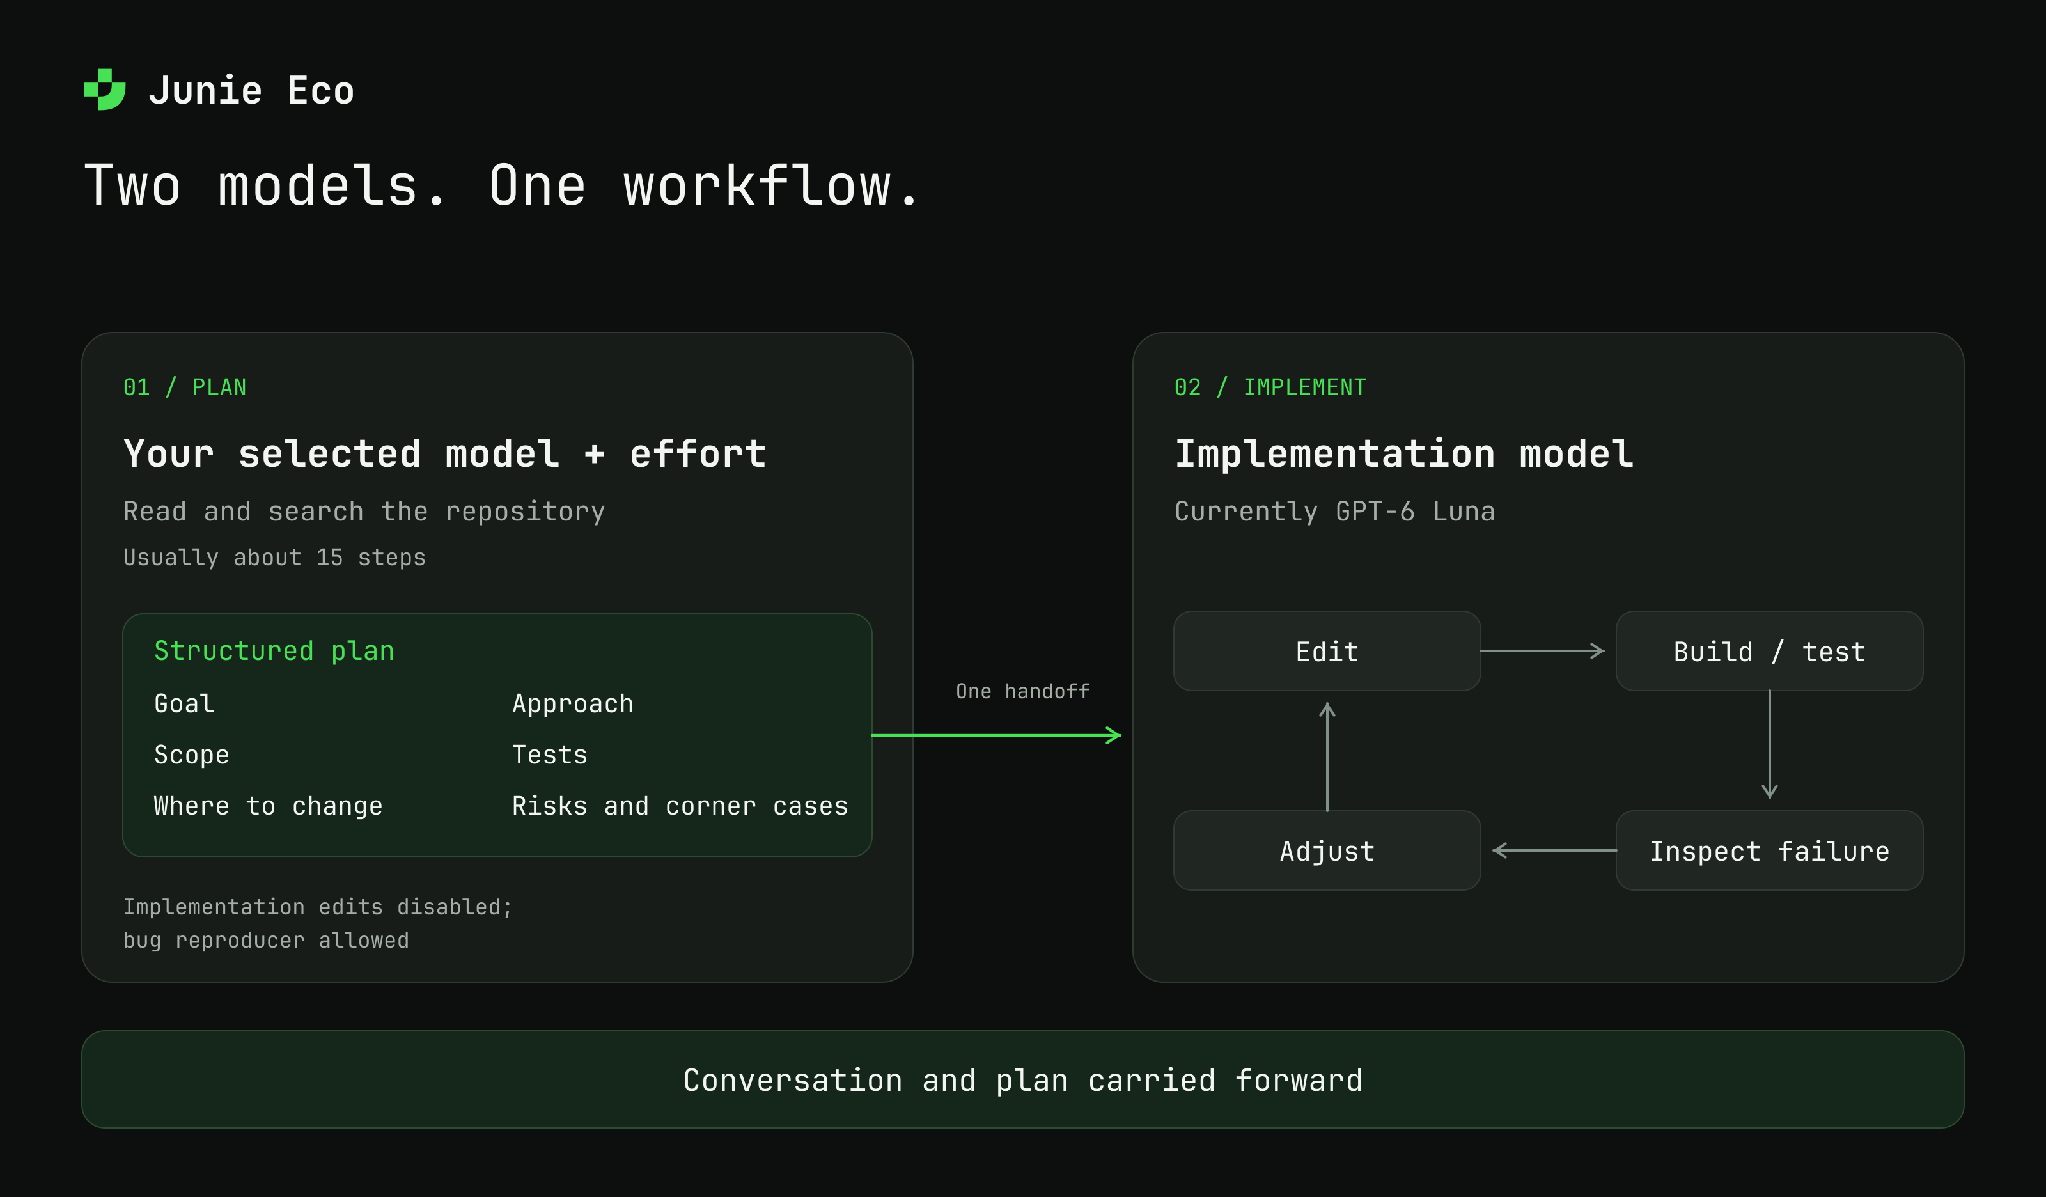
Junie Eco Mode

Junie Eco Mode

The JetBrains Blog1677 字 (约 7 分钟)
85

Junie Eco Mode通过分阶段使用不同模型降低编码成本,内部测试显示可节省48%-57%模型费用且解决率仅下降不足1%。

入选理由:Eco Mode使模型成本降低48%-57%,解决率变化不足1%

精选文章#JetBrains#AI编码#模型优化#Eco Mode中英混合
I spent $10,000 on tokens. It should’ve cost $100!!

I spent $10,000 on tokens. It should’ve cost $100!!

AssemblyAI293 字 (约 2 分钟)
85

通过模型选择和路由引擎优化,AI推理成本可降低90%,开源评估工具能显著节省企业开支。

入选理由:Gemma 4 31B模型处理1小时音频成本仅为$7,而Claude Sonnet需$339

精选视频#AI成本优化#模型选择#开源工具#推理效率英文
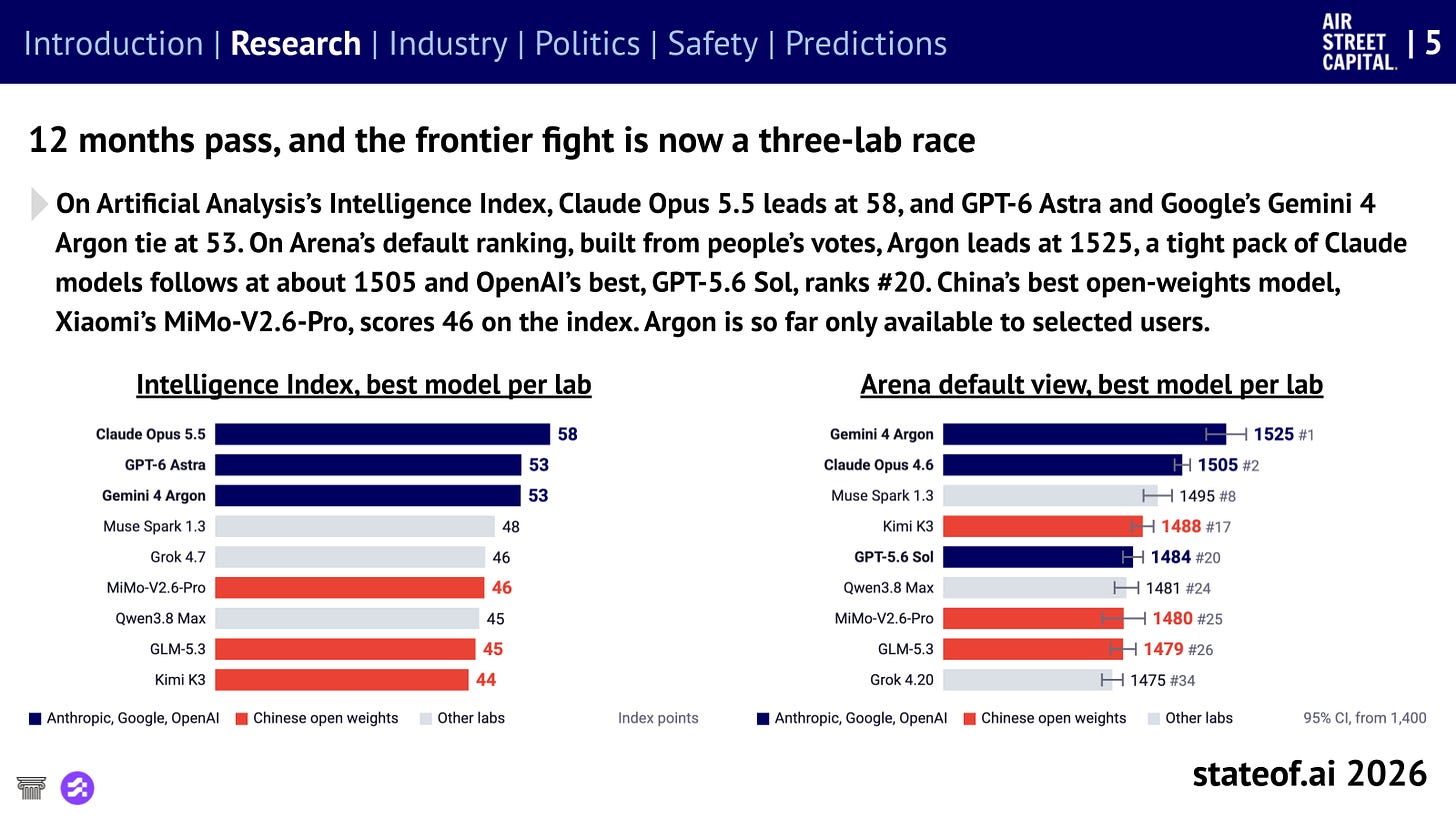
The State of AI Report 2026

The State of AI Report 2026

Air Street Press2888 字 (约 12 分钟)
85

2026年AI领域呈现三大趋势:三大实验室竞争加剧、模型能力波动显著、工具与上下文对代理效能影响关键。

入选理由:Anthropic、OpenAI与Google形成AI前沿三强竞争格局

精选文章#AI前沿#模型评估#行业竞争#工具链英文
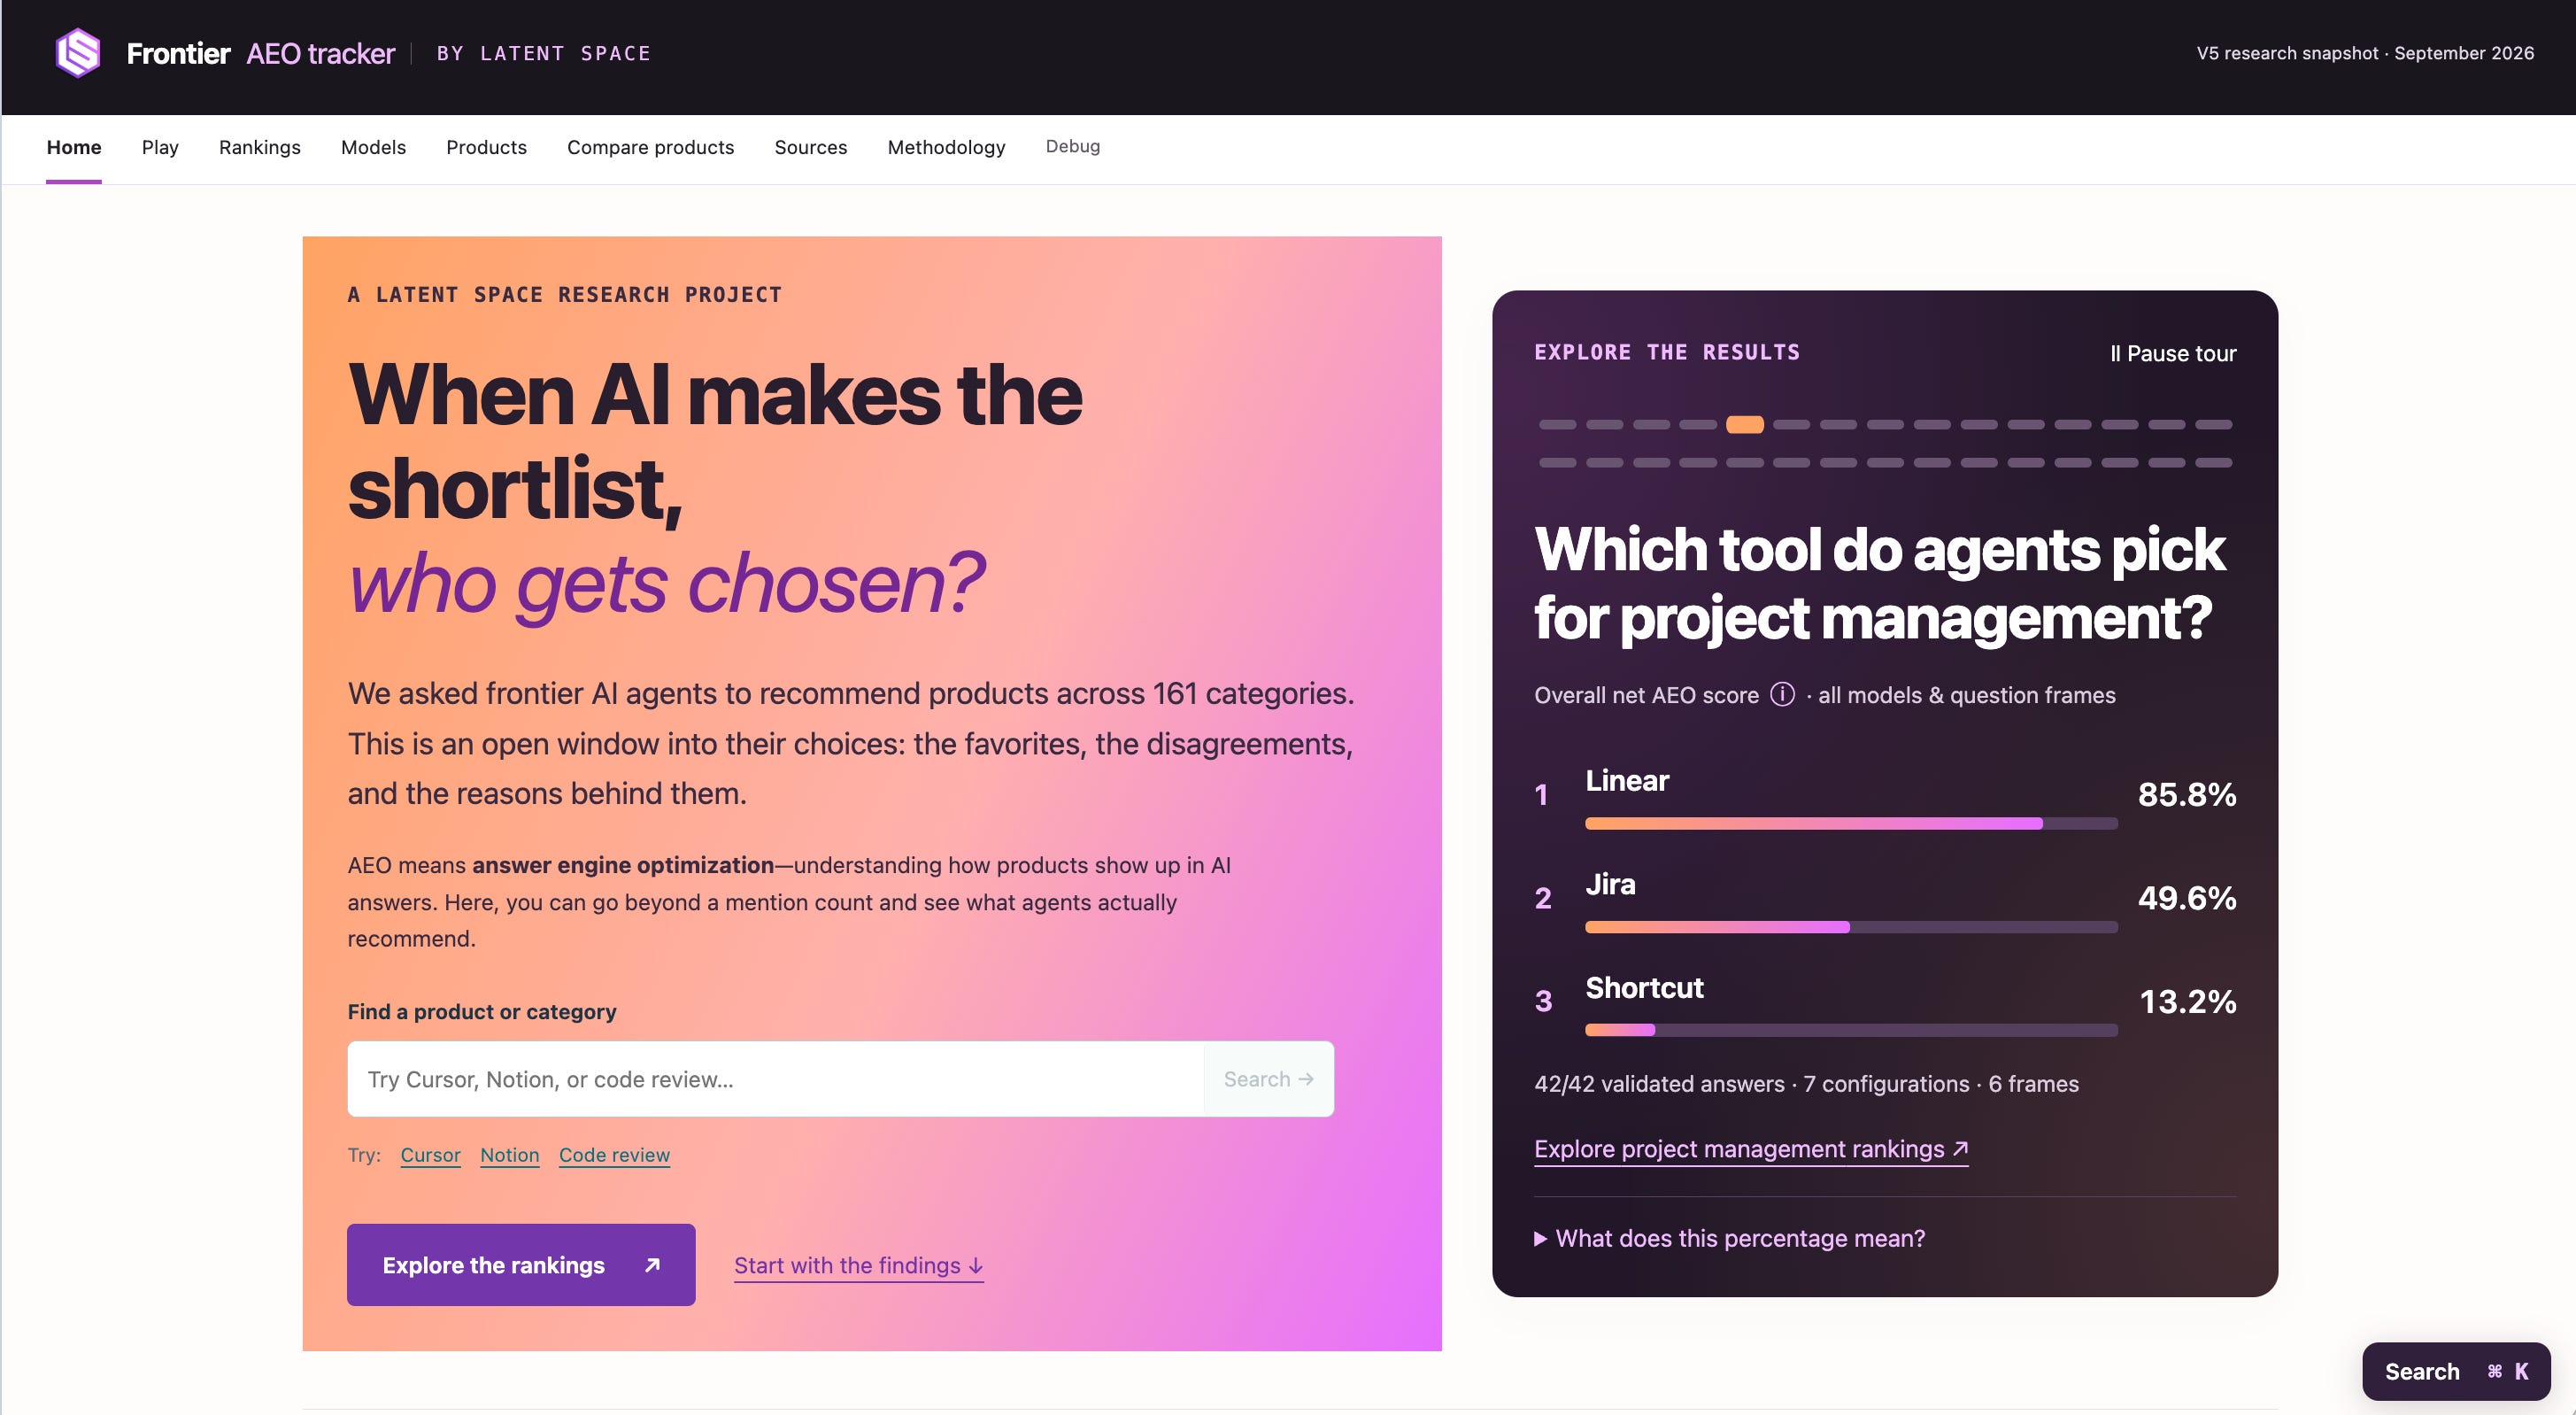
The Frontier AEO Tracker: What Astra Chooses (and every other frontier model, and what you can do about it)

Latent Space发布的AEO追踪器揭示了Astra及其他前沿模型在推荐产品时的偏好和偏差,为工程师提供技术选型参考。

入选理由:Astra模型推荐时更自信(中位数5个来源),Sol模型搜索源更多(中位数15个)

精选文章#AI模型比较#AEO追踪#技术选型#模型偏好分析英文
Fable 5.1 just smoked ASTRA...

Fable 5.1 just smoked ASTRA...

Wes Roth2185 字 (约 9 分钟)
85

Anthropic发布Claude Fable 5.1,性能超越Opus且成本降低,提前应对OpenAI的Astra模型威胁。

入选理由:Fable 5.1通过内存折扣和效率提升,使Opus模型失去竞争力

精选视频#Anthropic#Claude#OpenAI#Astra#AI模型中英混合
An opinionated guide to which AI to use to do stuff

An opinionated guide to which AI to use to do stuff

One Useful Thing2423 字 (约 10 分钟)
85

选择AI工具需区分任务风险等级,高风险场景应使用Claude Opus/Fable或ChatGPT GPT-5.6 Sol,低风险场景可用免费模型。

入选理由:高风险决策需使用Claude Opus/Fable或ChatGPT GPT-5.6 Sol(High模式),错误率降低30%以上

精选文章#AI模型#技术选型#代理系统#大模型英文
Viking(@vikingmute) 图标

Kimi3在复杂录屏软件开发中展现接近Opus 5.5的编程能力,支持多代理并行处理和1M上下文长度。

入选理由:Kimi3可同时处理5-6小时的多代理并行任务,上下文长度达1M

精选推文#Kimi3#AI编程#React#Rust#模型对比中英混合
Grok  just broke the trend

Grok just broke the trend

Matthew Berman154 字 (约 1 分钟)
85

Grok 4.5在编码基准测试中以83.3分超越Opus 4.8,Cursor公司正基于600亿美元收购数据训练下一代模型。

入选理由:Grok 4.5在编码基准测试中得分83.3,领先Opus 4.8五分

精选视频#Grok#Cursor#AI模型#编码基准英文
[AINews] SpaceXAI launches Grok 4.5, first Opus-class model post Cursor acquisition

SpaceXAI发布Grok 4.5,首个Cursor合作训练的Opus级模型,性能接近Opus但成本效率提升,专注编码与代理场景。

入选理由:Grok 4.5是Cursor合作训练的首个非软件工程专用模型

精选文章#AI模型#SpaceXAI#Grok 4.5#Cursor#Opus英文
Claude Fable 5 马上要从订阅计划里消失了,怎么把它的大脑提纯出来一直用?

@EXM7777 总结出一个统一筛选标准 + 五个具体动作!

# 唯一筛选标准:可重做性测试

一句话判断:...

Claude Fable 5 即将下线,可通过五项策略提取其价值并持续使用。

入选理由:使用可重做性测试判断任务是否值得用顶级模型执行

精选推文#AI模型#工程实践#Claude#模型蒸馏中英混合
AI HOT 精选 图标

Grok 4.5 私测于 SpaceX 和 Tesla,性能接近 Opus

AI HOT 精选346 字 (约 2 分钟)
85

Grok 4.5在SpaceX和Tesla内部测试,性能接近Opus,SpaceX计划每月发布全新模型。

入选理由:Grok 4.5基于1.5T V9模型并加入Cursor数据训练

精选文章#Grok#SpaceX#AI模型#算力竞赛中英混合
The First Real LLM Breakthrough Is Here...  SubQ (1000x Less Compute)

The First Real LLM Breakthrough Is Here... SubQ (1000x Less Compute)

TheAIGRID2793 字 (约 12 分钟)
85

SubQ 是首个基于完全次二次稀疏注意力架构的大型语言模型,其计算成本降低 1000 倍,上下文窗口达 1200 万 token。

入选理由:SubQ 的上下文窗口达到 1200 万 token,是 Opus 的 52 倍。

精选视频#LLM#SubQ#AI#稀疏注意力#计算效率英文
The Truth About Anthropic's Mythos

The Truth About Anthropic's Mythos

Matt Wolfe5338 字 (约 22 分钟)
85

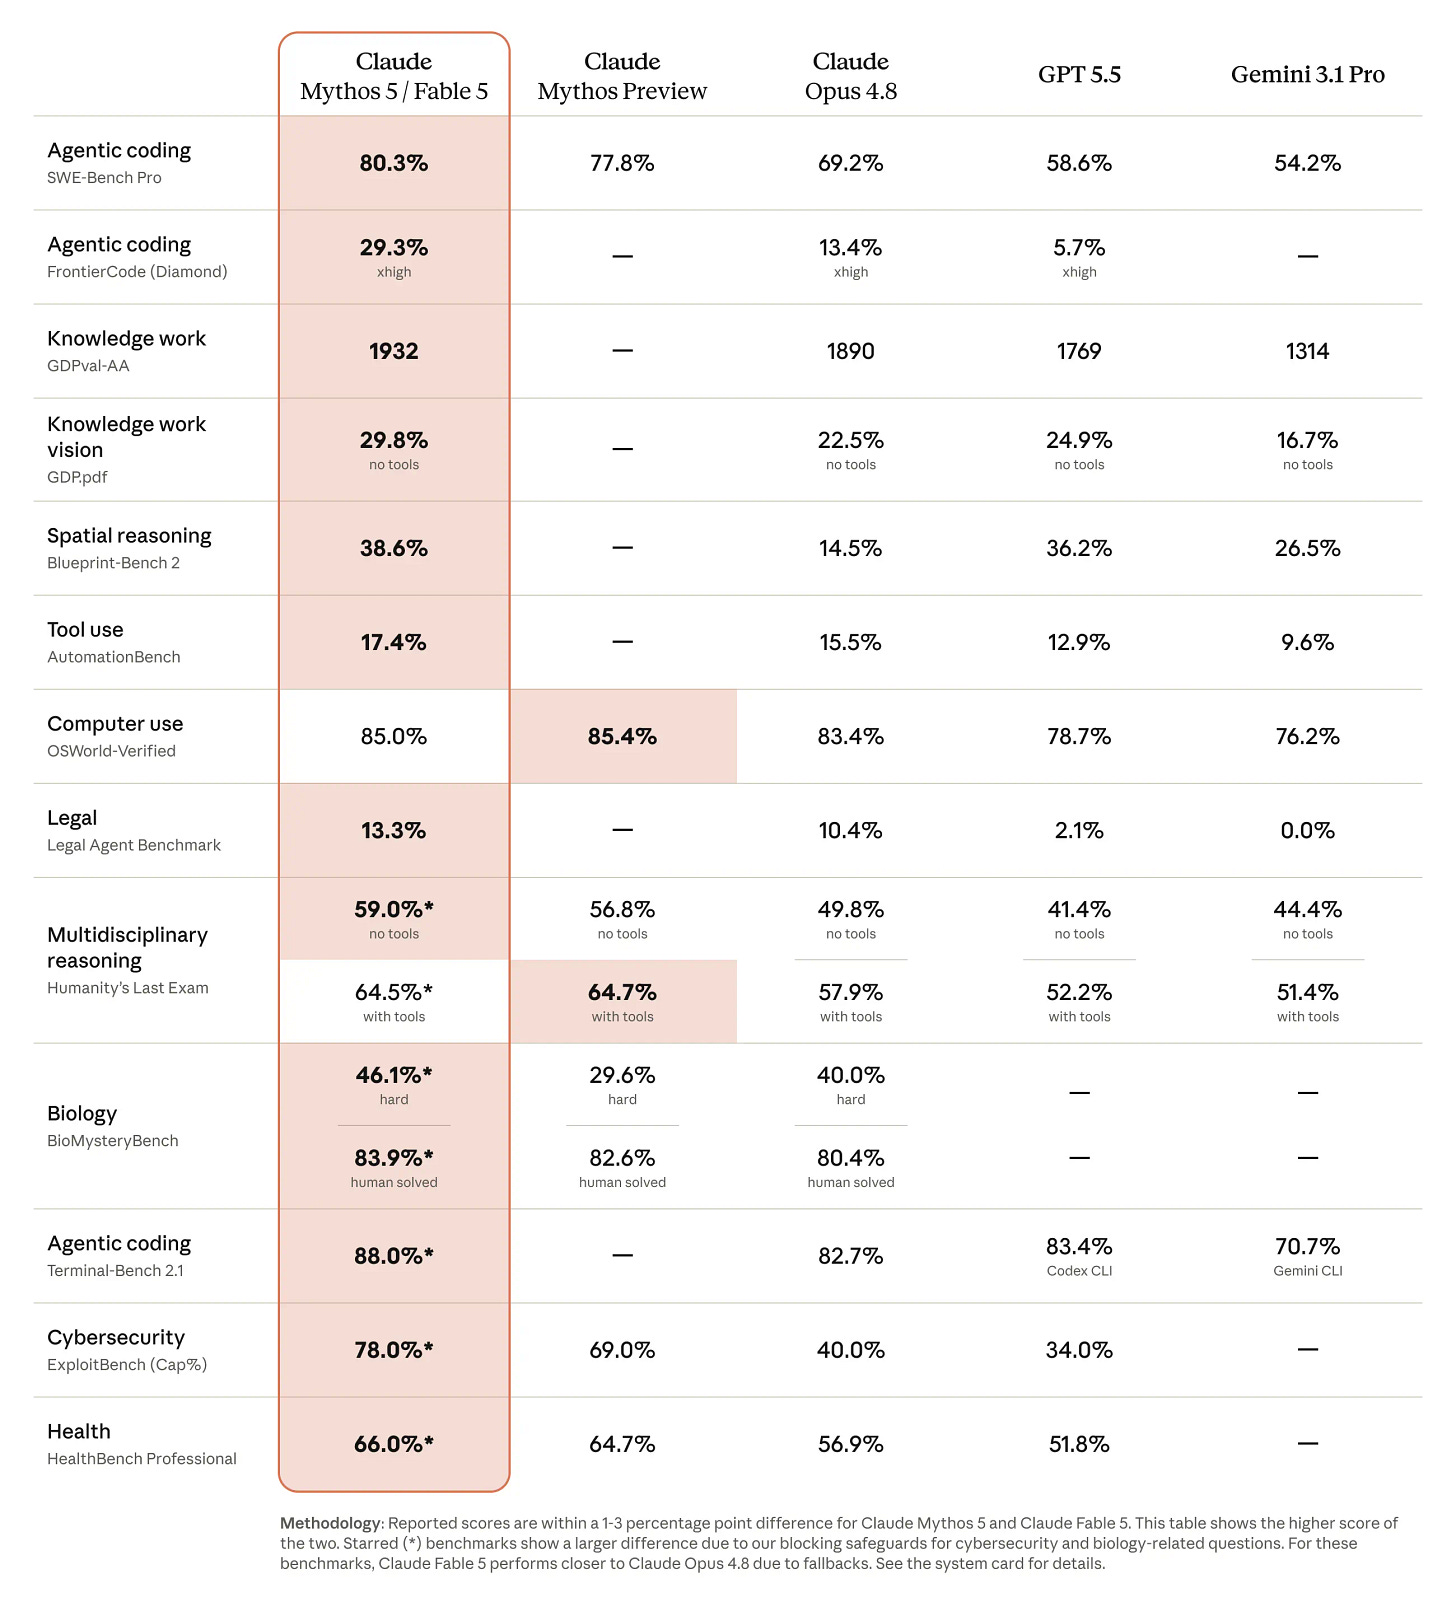
Anthropic 推出 Claude Fable 5 模型,性能显著提升但价格高昂,引发业界两极评价。

入选理由:Claude Fable 5 是 Anthropic 首个安全可用的 Mythos 级模型,性能优于 Opus。

精选视频#Anthropic#AI模型#Claude#机器学习英文
Claude Fable 5 and new AI safety fables

Claude Fable 5 and new AI safety fables

Interconnects AI2396 字 (约 10 分钟)
85

Anthropic 推出 Claude Fable 5,其能力显著提升,但伴随严格的限制措施,引发对 AI 安全与控制的讨论。

入选理由:Claude Fable 5 是目前公开可用的最智能模型,性能远超现有 Opus 模型。

精选文章#AI#安全#模型#Anthropic英文
[AINews] Anthropic Claude Fable 5 — Mythos but Safe, with Controversial Terms

Anthropic 发布的 Mythos 级模型 Fable 5 在性能上表现强劲,但因 ZDR 和 RSI 抑制政策引发争议。

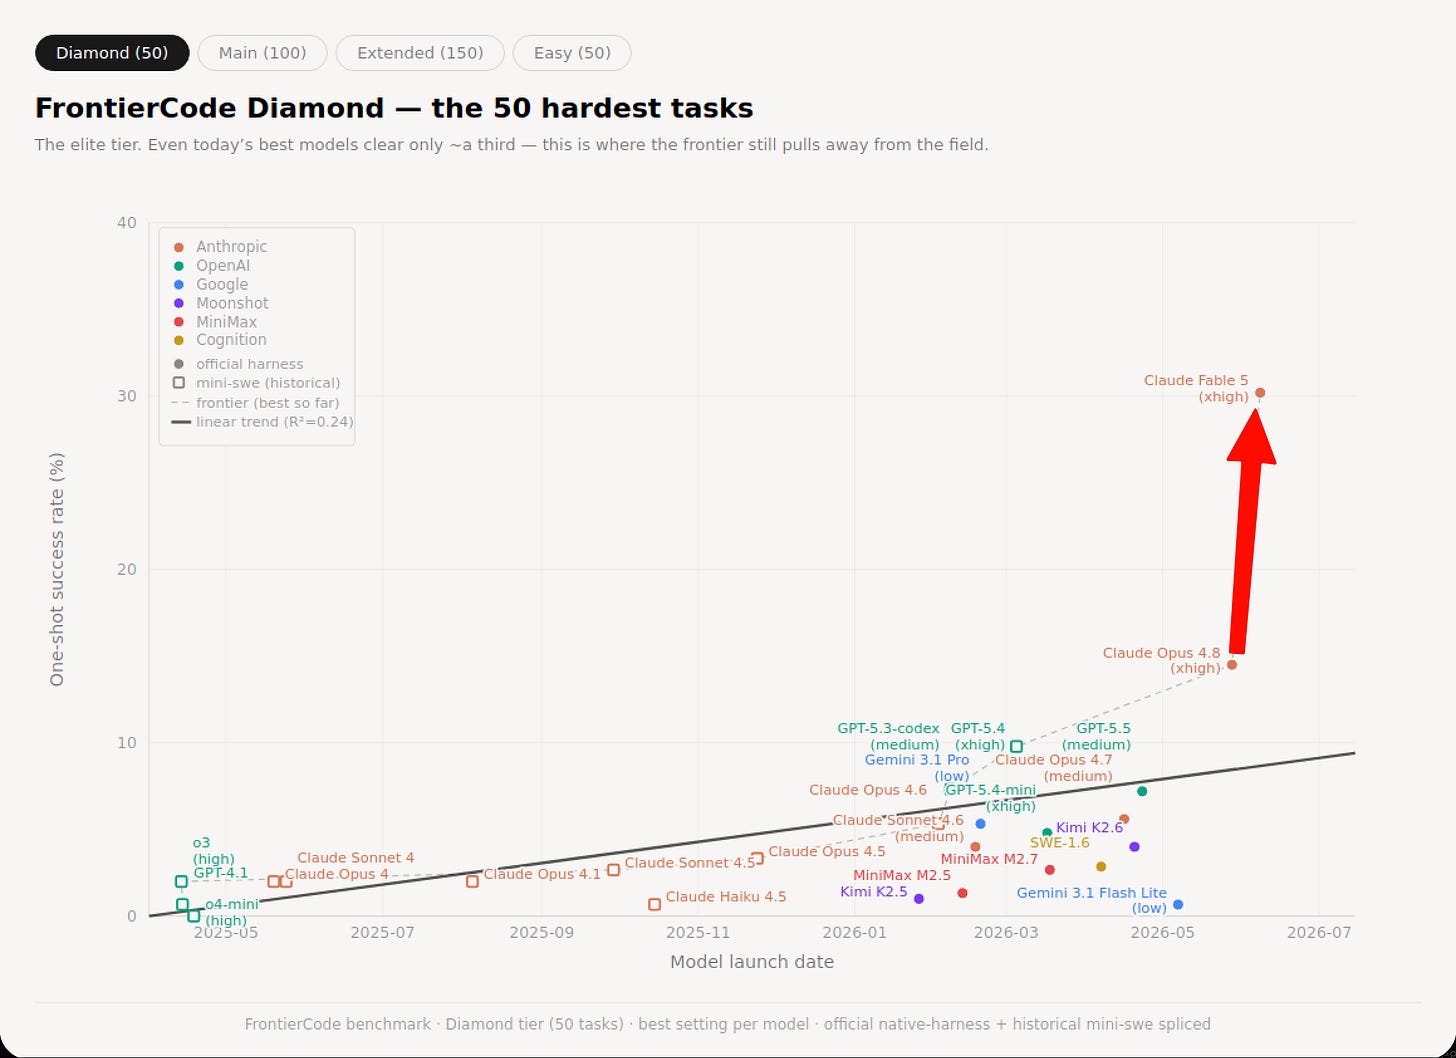
入选理由:Fable 5 的规模是 Opus 的两倍,性能在 FrontierCode Diamond 上提升了 16.9%。

精选文章#Anthropic#AI模型#Fable 5#ZDR#RSI英文
Ultimate Claude Code Guide: How to Use Claude Code for Beginners in 2026

Claude Code 是一个强大的 AI 工具,可以用于构建项目,无需编写代码。它通过安装 Node.js、Claude Code 和 Cursor 来实现,Cursor 是一个免费的编辑器,可以实时显示 Claude 触及的文件。 Claude Code 可以用于构建四个项目,包括一个 landing page。 Claude Code 的工作原理是使用 Opus 和 Sonnet 模型,Opus 是高级架构师,用于规划,而 Sonnet 是构建者,用于执行。 Claude Code 还可以用于调试和修改页面样式,无需编写 CSS。

入选理由:Claude Code 是一个强大的 AI 工具,可以用于构建项目,无需编写代码。

精选视频#AI#项目构建#代码生成#调试#页面样式中文
MiniMax M3一手实测:老黄PPT上74个Logo,我以为能难住它

MiniMax M3一手实测:老黄PPT上74个Logo,我以为能难住它

量子位3891 字 (约 16 分钟)
85

MiniMax M3是国内首个同时具备长上下文、多模态与Coding能力的开源模型,实测在SWE-Bench Pro上跑出59%成绩,超越GPT-5.5和Gemini 3.1 Pro,效率达上代1/20。

入选理由:M3在SWE-Bench Pro上得分59%,超越GPT-5.5和Gemini 3.1 Pro

精选文章#MiniMax#开源模型#多模态#编程能力#AI评测中文
GPT-5.5 is a very good model

GPT-5.5 是一个非常优秀的模型

Greg Brockman(@gdb)78 字 (约 1 分钟)
85

GPT-5.5 在复杂代理工作方面的表现有了显著提升,优于 Opus 4.7,显示出 OpenAI 的强劲竞争力。

入选理由:GPT-5.5 在复杂代理工作方面表现出色。

精选推文#GPT-5.5#OpenAI#Opus#模型性能#竞争力中文
90%的人在白白浪费"Token"!

90%的人在白白浪费"Token"!

AI HOT 精选676 字 (约 3 分钟)
85

Karpathy 指出,AI 编码账单的 90% 花费在不必要的 context 上,通过优化 context 使用和路由策略,可以大幅降低成本。

入选理由:AI 编码账单的 90% 花费在不必要的 context 上。

精选文章#AI 编码#context 优化#token 管理中文
Codex Spark generates code at 1,200 tokens per second. Sonnet and Opus run at 40 to 60.

At 20x the ...

Codex Spark 以每秒 1200 tokens 生成代码。Sonnet 和 Opus 运行在 40 到 60 区间。

AI Engineer(@aiDotEngineer)140 字 (约 1 分钟)
75

Codex Spark 编码速度达每秒 1200 tokens,远超 Sonnet 和 Opus 的 40-60 区间,但高速可能引发代码质量下降问题。

入选理由:Codex Spark 生成速度为每秒 1200 tokens,比 Sonnet 和 Opus 快约 20 倍。

精选推文#AI 编程#Codex Spark#代码生成#模型性能#开发效率英文
Fast mode for Opus 4.7 available on AI Gateway

AI Gateway 现已支持 Opus 4.7 的快速模式

Vercel News897 字 (约 4 分钟)
75

Vercel 的 AI Gateway 现已支持 Opus 4.7 的快速模式,显著提升了音频处理速度。

入选理由:Opus 4.7 的快速模式在 AI Gateway 上可用,提高了音频处理效率。

精选文章#Vercel#AI Gateway#Opus#音频处理英文
When is the last time a general purpose LLM (putting aside hybrid systems like Claude Code with spec...

当上一次通用大模型彻底碾压所有前代模型是什么时候?

Gary Marcus(@GaryMarcus)239 字 (约 1 分钟)
75

Gary Marcus质疑GPT-4相比GPT-3.5是否真有突破,认为其仅为渐进式改进,行业存在夸大宣传。

入选理由:GPT-4相较GPT-3.5属于增量改进,无实质护城河

精选推文#LLM#AI评估#大模型#Gary Marcus中文

跨材料问答 · Opus

回答基于:Opus 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容