推出 Gemma 4 12B:面向本机的统一、无编码器多模态模型
Gemma 4 12B 是面向本机运行的统一、无编码器多模态模型,将视觉与音频直接接入 LLM,性能接近 26B MoE 但内存仅其一半,可在 16GB VRAM 紧凑设备上运行,支持离线语音处理与低延迟多步推理。
入选理由:Gemma 4 12B 性能接近 26B MoE,内存仅其一半,适合在 16GB VRAM 现代本机运行。
公司
别名:@ollama
发布AI模型的公司,CEO为@jmorgan。
已跟踪 30 条高相关材料
最近变化
2026-11-16 · 智能体每次请求都需发送完整对话历史,导致推理效率下降。
为什么值得关注
ollama 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Introducing Gemma 4 12B: a unified, encoder-free multimodal model
The Keyword (blog.google) · 8.7 分
Gemma 4 12B 是面向本机运行的统一、无编码器多模态模型,将视觉与音频直接接入 LLM,性能接近 26B MoE 但内存仅为其一半,可在 16GB VRAM 紧凑设备上运行,支持离线语音处理与低延迟多步推理。
How to Build Optimal AI Agents That Actually Work – A Handbook for Devs
freeCodeCamp.org · 8.7 分
AI代理系统的最优组织结构取决于任务复杂度与模型类型,Google研究通过150+实验发现:集中式或混合架构对OpenAI模型更有效,而Google模型在去中心化协作中表现更优。
Making open models work for long-horizon agentic workloads
Together AI Blog · 8.5 分
长周期智能体工作负载需要优化模型推理效率,Together AI 和 Ollama 提出通过前缀缓存减少重复计算。
已收录 30 条与 ollama 相关的内容,按评分排序。
Gemma 4 12B 是面向本机运行的统一、无编码器多模态模型,将视觉与音频直接接入 LLM,性能接近 26B MoE 但内存仅其一半,可在 16GB VRAM 紧凑设备上运行,支持离线语音处理与低延迟多步推理。
入选理由:Gemma 4 12B 性能接近 26B MoE,内存仅其一半,适合在 16GB VRAM 现代本机运行。
AI代理系统的最优组织结构取决于任务复杂度与模型类型,Google研究通过150+实验发现:集中式或混合架构对OpenAI模型更有效,而Google模型在去中心化协作中表现更优。
入选理由:超过150次实验证明,OpenAI模型在集中式管理架构下性能提升37%,优于去中心化模式。
长周期智能体工作负载需要优化模型推理效率,Together AI 和 Ollama 提出通过前缀缓存减少重复计算。
入选理由:智能体每次请求都需发送完整对话历史,导致推理效率下降。
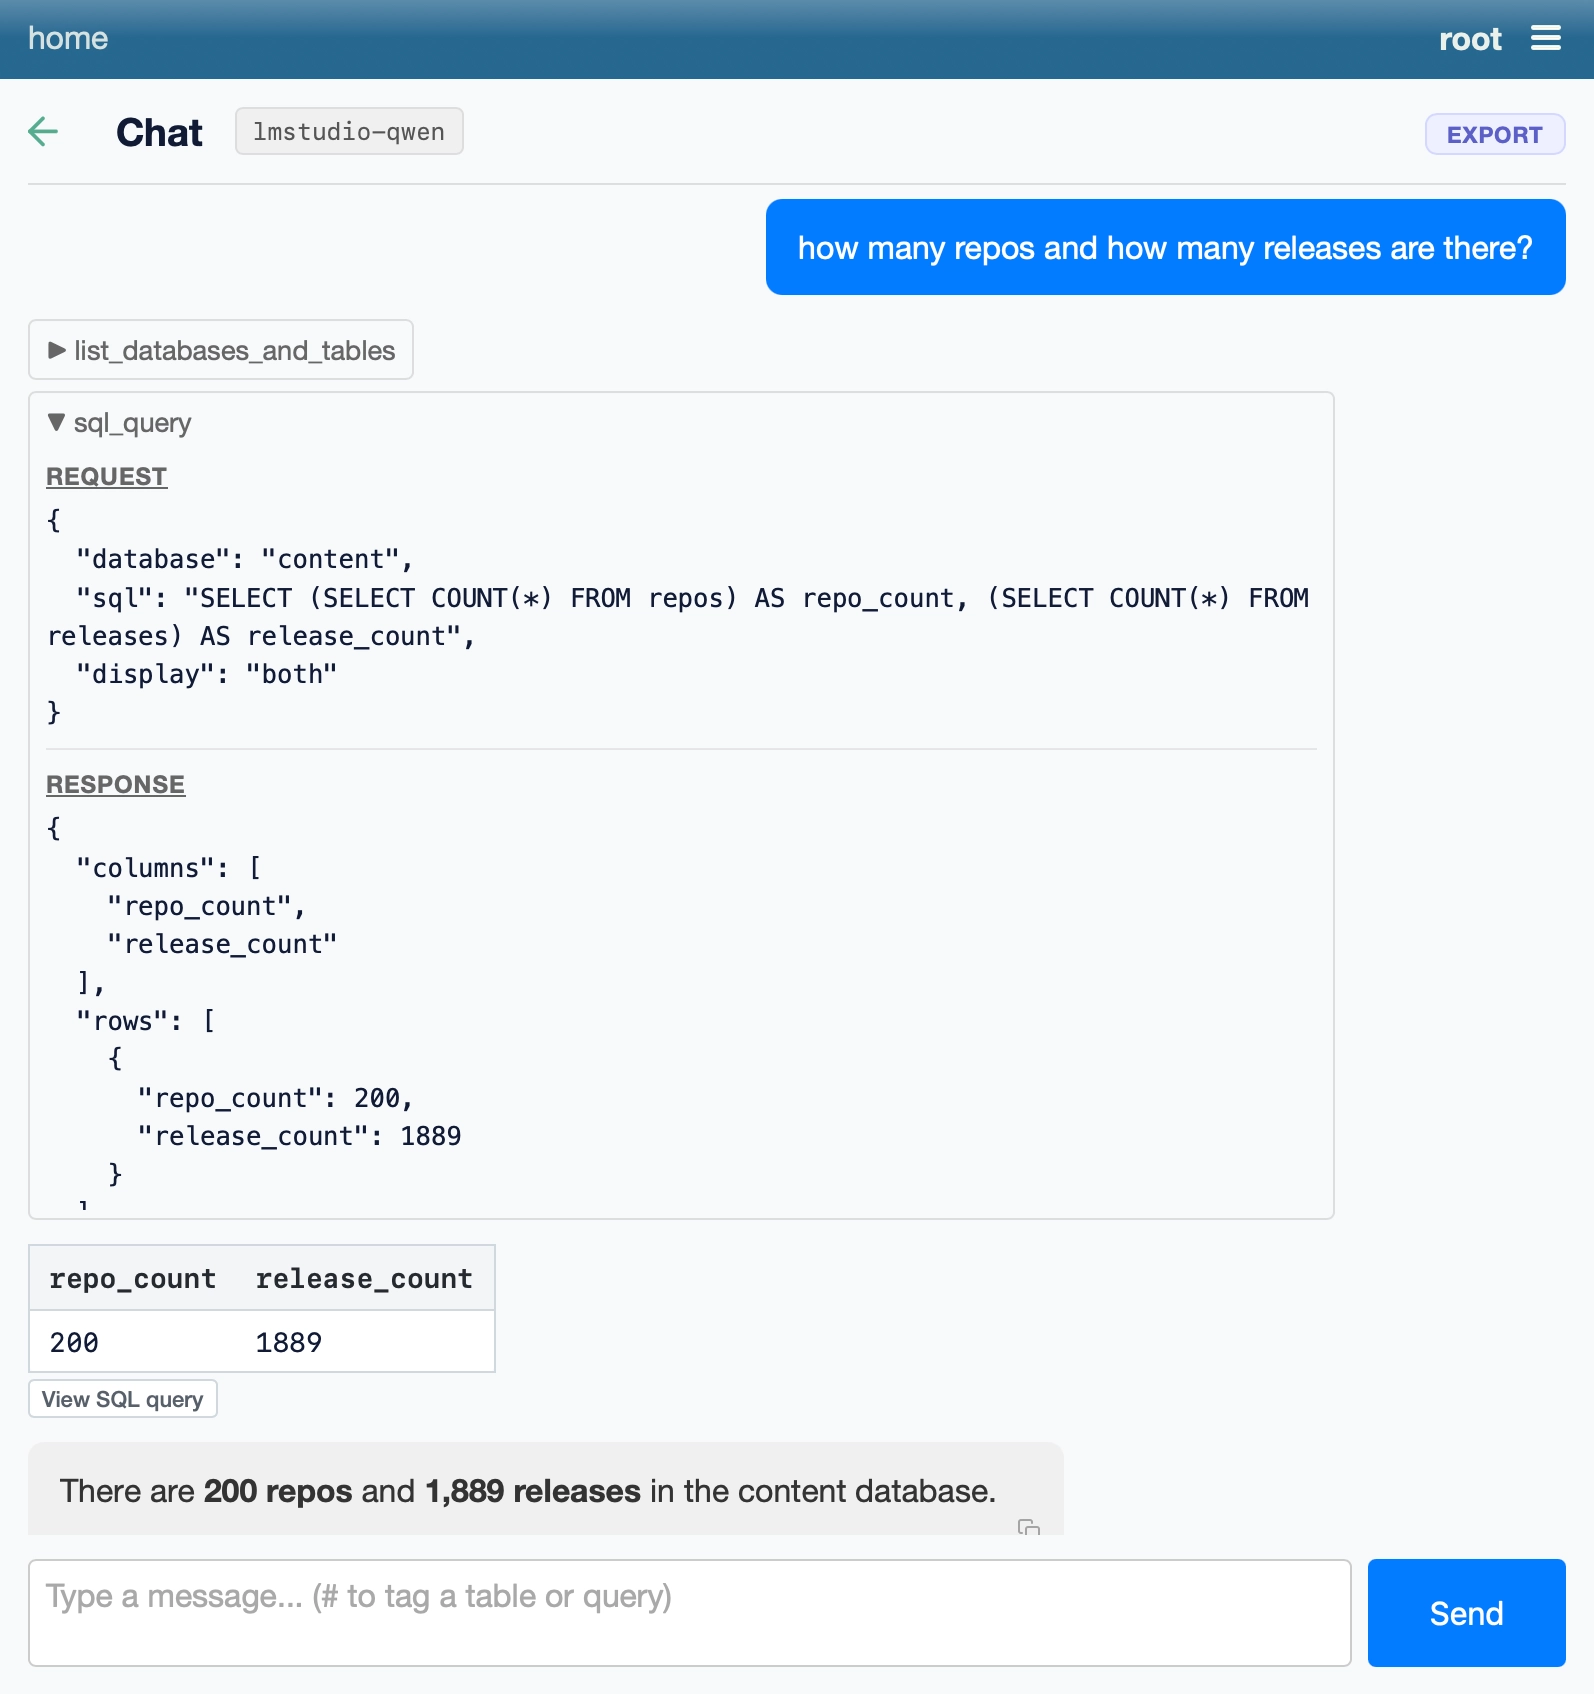
datasette-llm 0.1a11 支持 OpenAI 兼容端点,允许使用本地模型运行 Datasette Agent。
入选理由:datasette-llm 0.1a11 支持 OpenAI 兼容端点。
Inkling 2 Small模型在Ollama上线,具备594B参数和1M上下文窗口,适用于视觉和金融推理任务。
入选理由:Inkling 2 Small是594B参数的混合专家模型,支持1M上下文窗口。
ollama发布594B参数的Mixture-of-Experts模型,支持图像输入和1M上下文,专为代理编码和知识工作设计。
入选理由:inkling-2-small模型参数量达594B,采用17B激活专家架构
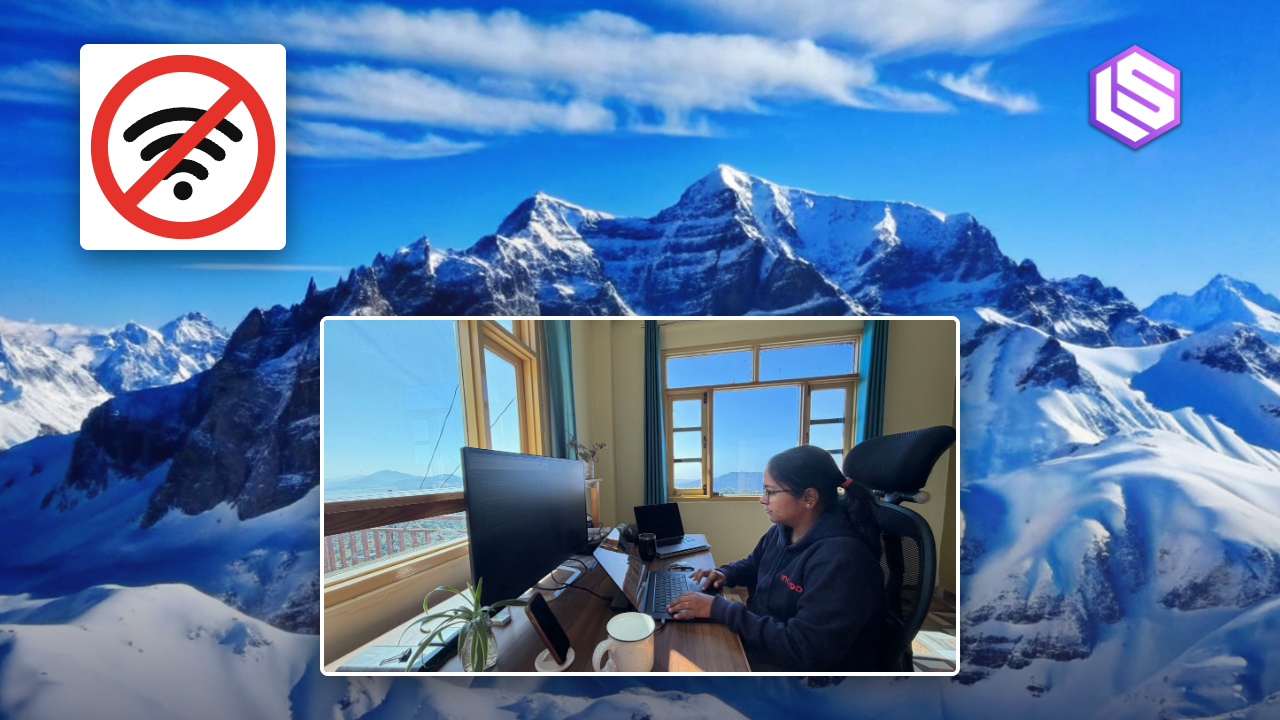
工程师可在无网络环境下通过本地AI代理(如OpenCode+Ollama+Qwen)完成编码任务,无需依赖云端模型。
入选理由:OpenCode与Ollama结合可在本地运行Qwen模型,实现无网络编码
通过OpenAI Agents SDK为本地LLM代理添加运行时防护,使用Gemma 4和Ollama实现对工具输出的验证与修改。
入选理由:使用OpenAI Agents SDK可设置四类防护:输入、工具输入、工具输出和最终输出。
DeepSeek-V4.1-Flash-1017模型已在Ollama平台上线,提供美国托管和零数据保留服务,优化代理任务性能并降低成本。
入选理由:DeepSeek-V4.1-Flash-1017模型在代理任务上表现优于前代,且每任务成本降低。
Ollama与Reflection AI合作推出开源模型Beam,限时免费,支持1M token上下文窗口及多种权重格式。
入选理由:Beam模型提供1M token上下文窗口,适用于软件工程和长期代理任务
Meta Muse Spark Open模型在Together AI上线,支持1M-token上下文和多模态输入,适用于复杂代码重构场景。
入选理由:Muse Spark Open具备1M-token上下文窗口,可处理完整项目代码库
Liquid AI发布LFM2.5-24B-A8B模型,参数达240亿,支持131K上下文长度,专为本地设备多步骤任务优化。
入选理由:LFM2.5-24B-A8B模型拥有240亿总参数,每个token激活20亿参数
OpenAI的Codex Harness和App Server协议为开发者提供了构建自定义接口的开源工具,支持多种模型集成。
入选理由:Codex App Server基于JSON-RPC协议,支持VS Code扩展和IDE集成。
数据科学家可使用10个免费AI工具替代昂贵商业软件,开源工具在性能和功能上已能有效替代付费版本。
入选理由:Ollama+Open WebUI组合可替代OpenAI和Anthropic API,节省每月数千美元
掌握Python基础是工程实践的核心,KDnuggets备忘录提供无需安装的实用指南,涵盖文件处理、数据格式转换等关键技能,提升调试与协作效率。
入选理由:Python基础(如文件处理、数据格式转换)占实际工程工作量的60%以上
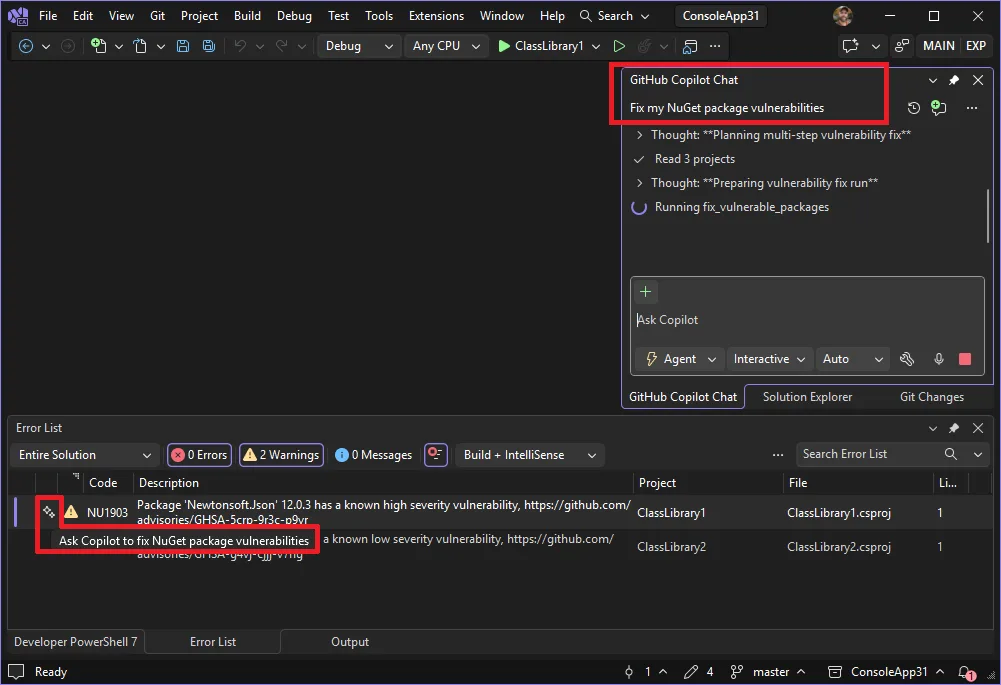
Visual Studio 2026更新支持自定义模型集成与NuGet漏洞自动修复,提升开发效率与安全性。
入选理由:BYOM功能支持OpenAI、Anthropic等模型接入,预览版默认启用
配置优化对本地LLM服务器性能影响显著,不同平台的设置可带来最高63%的性能提升。
入选理由:启用CUDA graphs可使L40S解码速度提升16.8%(0.8B模型)
使用Scikit-LLM和多语言嵌入可构建无需单独训练每种语言模型的多语言文本分类流水线。
入选理由:BGE-M3模型支持多语言嵌入生成,可替代付费API实现本地化部署
DeepSeek-V4-Flash和Pro模型在非高峰时段价格减半,影响AI推理成本和使用策略。
入选理由:工作日UTC 12:00-18:00外及周末全天,DeepSeek-V4系列价格减半
本地AI堆栈需分层构建,Ollama与LM Studio等工具在模型服务层各有优劣,选择需匹配硬件与工作流需求。
入选理由:Ollama适合单开发者快速部署,但牺牲深度调优能力
本文系统讲解如何用Scikit-LLM生成文本嵌入,并结合UMAP和SHAP实现可解释性分析,揭示大模型内部语义结构。
入选理由:使用Scikit-LLM和Ollama本地模型生成文本嵌入向量
Visual Studio 将推出 Bring Your Own Model 功能,允许开发者使用自定义 AI 模型。
入选理由:BYOM 预览版集成于 Visual Studio 18.10 Insiders Release,支持 OpenAI/Anthropic 等 4 种提供商
Ollama、vLLM、SGLang三大模型引擎各具优势:Ollama适合本地开发,vLLM擅长高并发服务,SGLang优化多轮对话,Claude水印技术通过概率筛选实现内容溯源。
入选理由:Ollama适用于本地开发,采用FIFO队列和GGUF压缩模型
构建本地流式AI代理需采用两阶段过滤器处理维基百科实时编辑流,结合Ollama实现本地推理,无需API密钥或云服务。
入选理由:两阶段过滤器可减少90%无意义编辑的模型计算负载
Kimi K3模型已在Ollama云平台上线,但需Pro/Max订阅及额外积分,且未包含在订阅计划中。
入选理由:Kimi K3为2.8T MoE模型,支持1M-token上下文窗口
Kimi K3模型在Ollama云上发布,具备2.8T MoE架构和1M token上下文窗口,但需付费使用。
入选理由:Kimi K3是2.8T参数的MoE模型,支持原生视觉理解和1M token上下文
多模型AI架构能通过动态路由和自动回退机制,平衡成本与性能,避免单一模型风险。
入选理由:使用OpenAI和Anthropic双模型可降低60%复杂任务成本
OpenWorker是开源AI代理工具,支持多模型本地运行,强调数据隐私和模型独立性。
入选理由:支持GPT 5.6 Sol、Claude Fable等8种大模型,用户可自定义API密钥
提示工程和上下文工程能显著提升AI代理性能,通过优化输入和上下文信息。
入选理由:使用LangChain v1和Ollama可本地运行AI代理,避免API成本
开源模型已具备代理应用能力,但API兼容性不足成为生产环境瓶颈,Mozilla提出开源网关Otari解决该问题。
入选理由:开源模型推理能力已满足代理产品需求,但API兼容性仅支持基础聊天功能