Today, @llama_index is an applied research lab for document OCR and document work. Our core focus i...
llama_index正在构建文档处理领域的前沿模型,通过基准测试、数据生成和代理优化实现准确率/成本/延迟的平衡。
入选理由:ParseBench和ExtractBench是当前最流行的文档解析基准测试
模型
别名:OCRia
支持复杂文档解析的通用目的模型
已跟踪 2 条高相关材料
最近变化
2026-11-11 · ParseBench和ExtractBench是当前最流行的文档解析基准测试
为什么值得关注
OCRia-1 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Today, @llama_index is an applied research lab for document OCR and document work. Our core focus i...
Jerry Liu(@jerryjliu0) · 8.5 分
llama_index正在构建文档处理领域的前沿模型,通过基准测试、数据生成和代理优化实现准确率/成本/延迟的平衡。
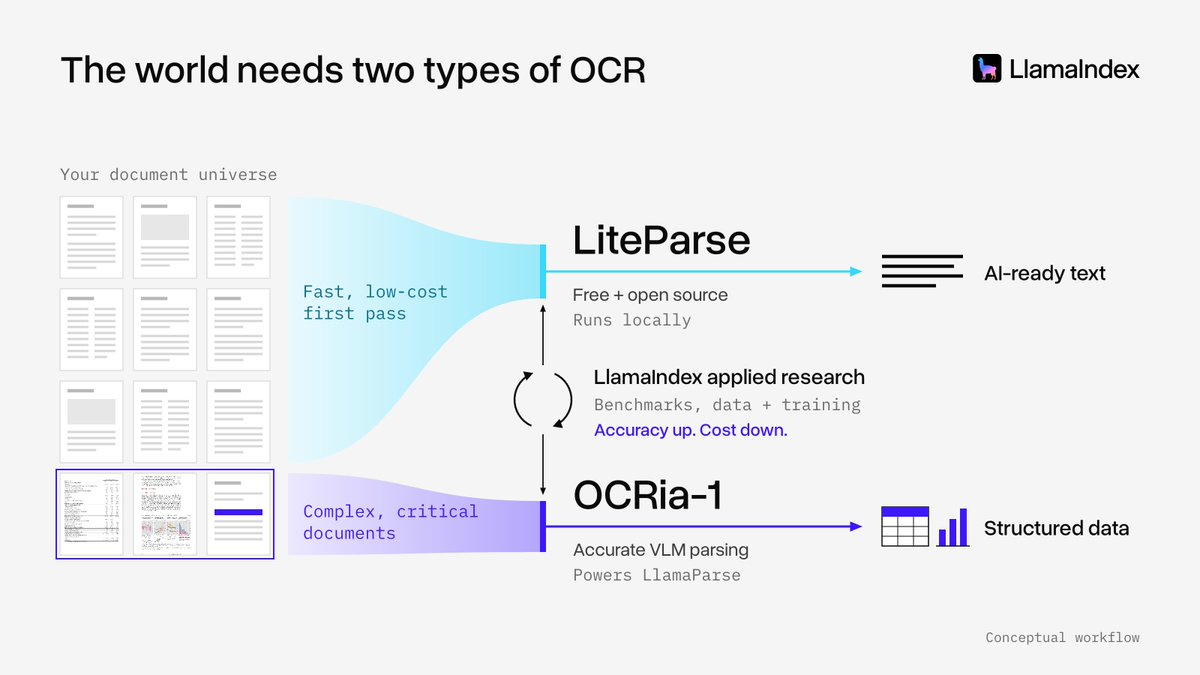
The world needs two types of document OCR: 1. Extremely fast/cheap OCR tools: Each organization mig...
Jerry Liu(@jerryjliu0) · 8.5 分
世界需要两种文档OCR:快速廉价的用于大规模预处理,高精度VLM-based OCR用于关键业务场景。LlamaParse推出OCRia-1模型,支持复杂文档解析。
已收录 2 条与 OCRia-1 相关的内容,按评分排序。
llama_index正在构建文档处理领域的前沿模型,通过基准测试、数据生成和代理优化实现准确率/成本/延迟的平衡。
入选理由:ParseBench和ExtractBench是当前最流行的文档解析基准测试
世界需要两种文档OCR:快速廉价的用于大规模预处理,高精度VLM-based OCR用于关键业务场景。LlamaParse推出OCRia-1模型,支持复杂文档解析。
入选理由:liteparse是最快的开源文档解析工具,集成5种OCR模型