Accelerating PyTorch on AMD GPUs with FlyDSL
PyTorch Blog4733 字 (约 19 分钟)
85
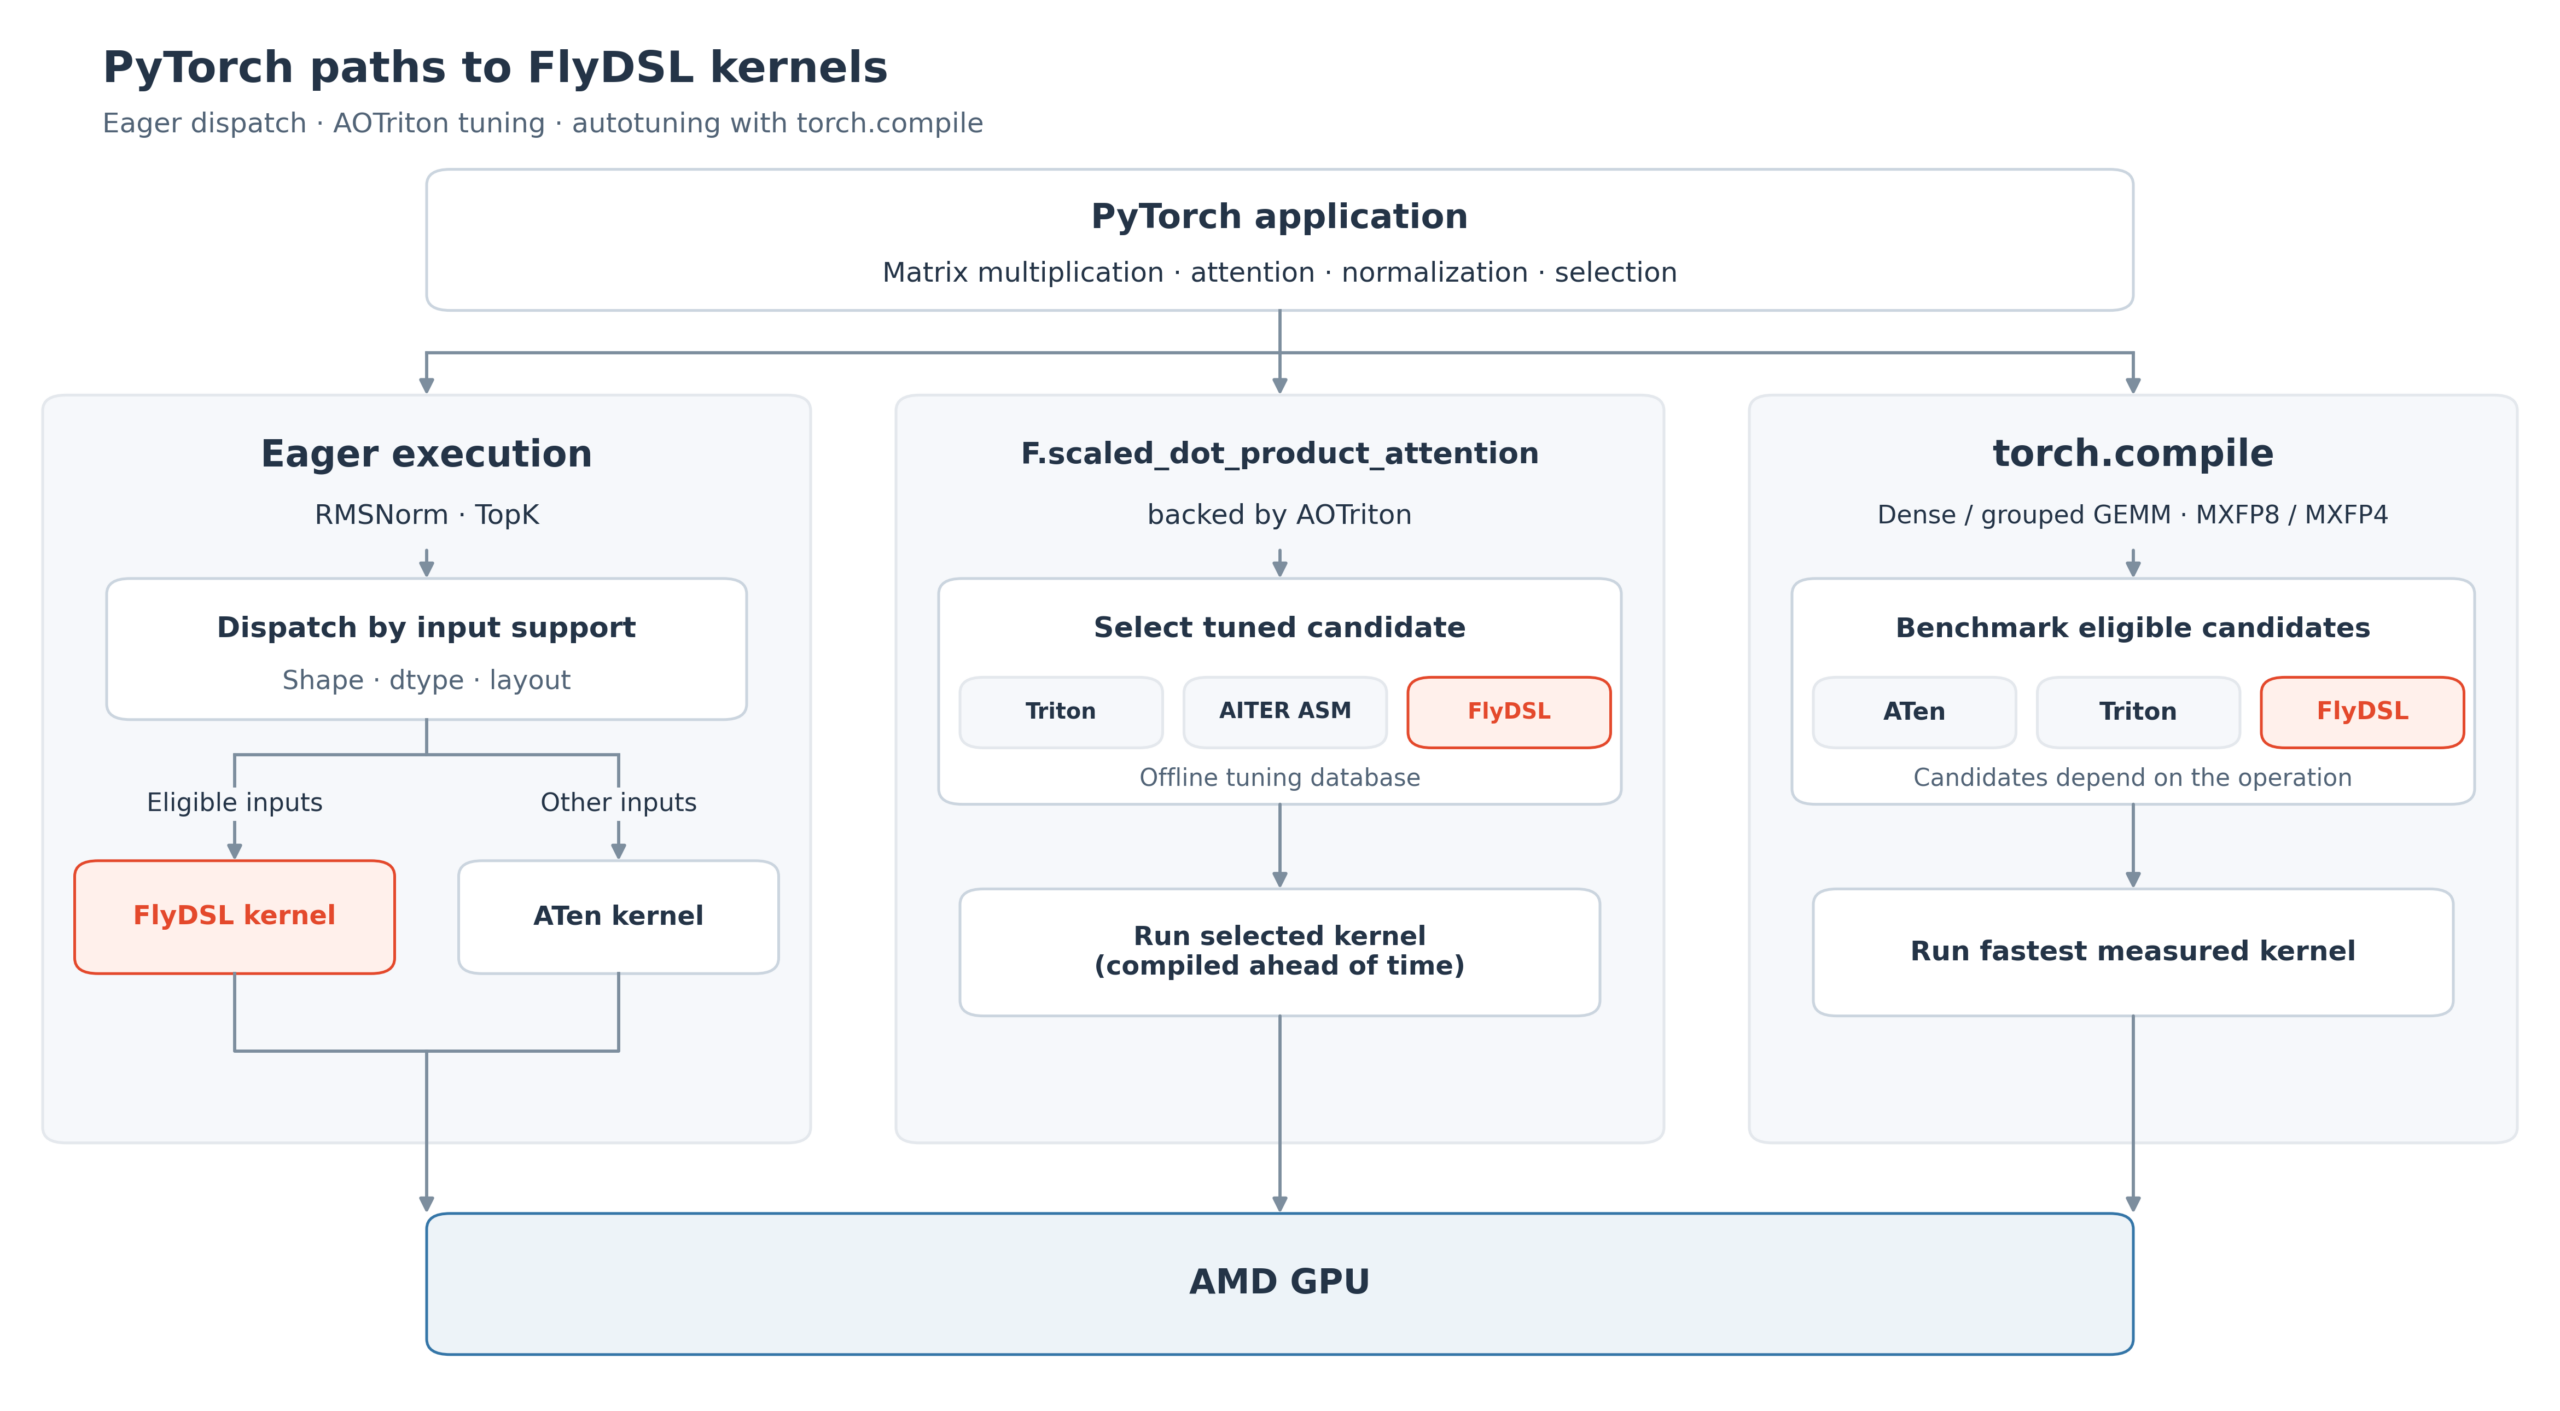
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
精选文章#PyTorch#AMD GPU#FlyDSL#性能优化#深度学习框架英文
概念
混合精度浮点格式
已跟踪 2 条高相关材料
最近变化
2026-10-21 · FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
为什么值得关注
MXFP8 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
已收录 2 条与 MXFP8 相关的内容,按评分排序。
FlyDSL通过显式硬件映射控制,使PyTorch在AMD GPU上实现最高3.66x加速,特别适用于大模型训练场景。
入选理由:FlyDSL在MXFP4格式下实现1.68x几何均值加速,优于ATen基准
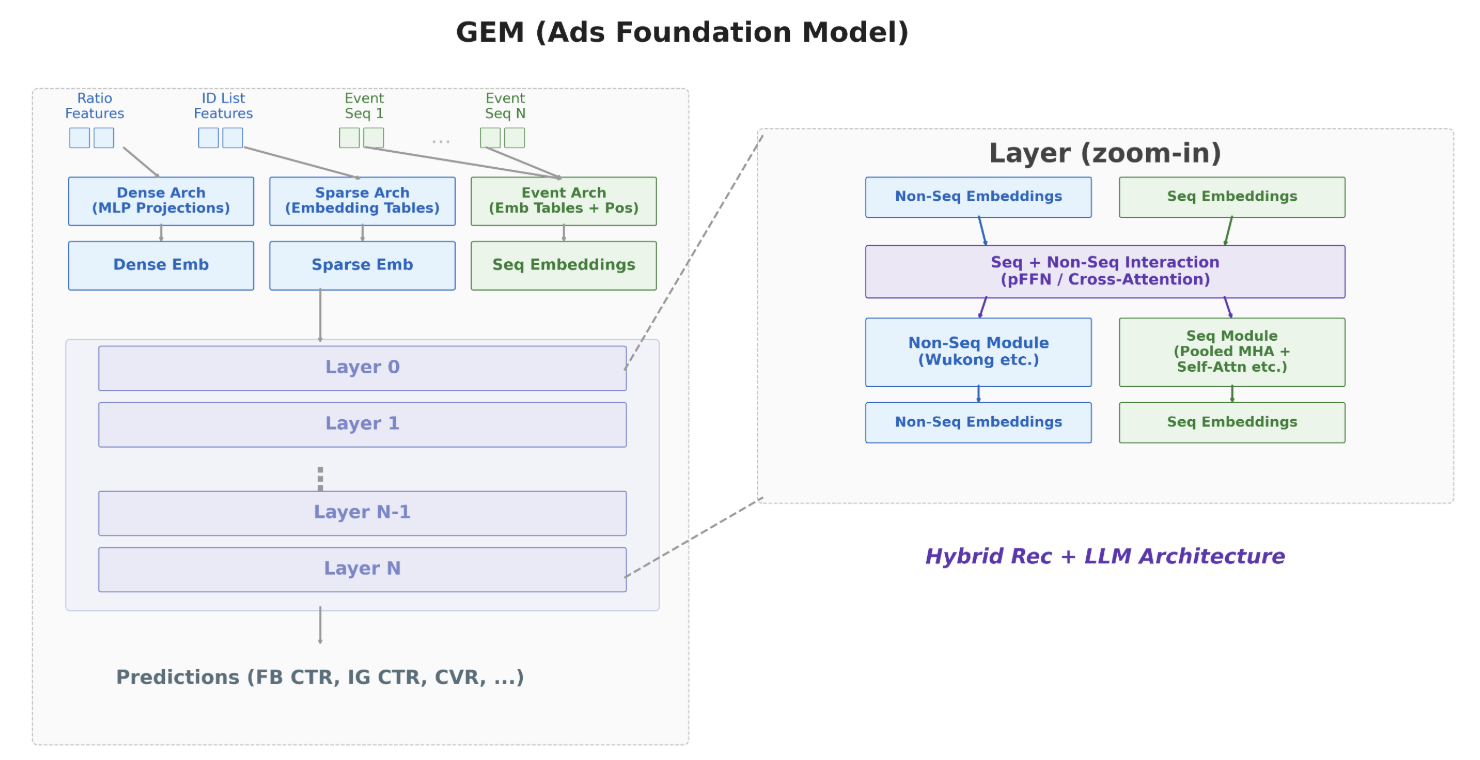
Meta通过自定义内核库和混合精度训练,将GEM广告推荐模型训练效率提升至20-25% MFU,同时实现4倍FLOPs扩展。
入选理由:Jagged Flash Attention(JFA)等自定义内核库使GPU利用率提升100%