@thinkymachines Model page: https://t.co/6V0FYri3x8
ollama(@ollama)51 字 (约 1 分钟)
85
ollama发布594B参数的Mixture-of-Experts模型,支持图像输入和1M上下文,专为代理编码和知识工作设计。
入选理由:inkling-2-small模型参数量达594B,采用17B激活专家架构
精选推文#AI模型#Mixture-of-Experts#图像输入#长上下文英文
概念
别名:MoE
一种模型架构方法,通过专家网络的组合实现计算效率与性能的平衡。
已跟踪 11 条高相关材料
最近变化
2026-11-13 · inkling-2-small模型参数量达594B,采用17B激活专家架构
为什么值得关注
Mixture-of-Experts 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
@thinkymachines Model page: https://t.co/6V0FYri3x8
ollama(@ollama) · 8.5 分
ollama发布594B参数的Mixture-of-Experts模型,支持图像输入和1M上下文,专为代理编码和知识工作设计。
来自:https://t.co/c0J98gds7s
AI Will(@FinanceYF5) · 8.5 分
当前20个最佳开源模型中18个采用Mixture-of-Experts架构,密集模型已基本被淘汰。
18 of the 20 best open models today are Mixture-of-Experts. Dense is basically over. And yet the kn...
Thomas Wolf(@Thom_Wolf) · 8.5 分
当前20个最佳开源模型中,18个采用Mixture-of-Experts架构,传统密集模型已基本被淘汰。
已收录 11 条与 Mixture-of-Experts 相关的内容,按评分排序。
ollama发布594B参数的Mixture-of-Experts模型,支持图像输入和1M上下文,专为代理编码和知识工作设计。
入选理由:inkling-2-small模型参数量达594B,采用17B激活专家架构
当前20个最佳开源模型中18个采用Mixture-of-Experts架构,密集模型已基本被淘汰。
入选理由:Mixture-of-Experts(MoE)架构已占据当前20个最佳开源模型中的18个
当前20个最佳开源模型中,18个采用Mixture-of-Experts架构,传统密集模型已基本被淘汰。
入选理由:MoE架构在18/20顶尖开源模型中成为主流,密集模型时代结束
Mistral Large 4模型在网络安全和多模态处理方面表现突出,参数达49B,支持1M上下文窗口,提供FP8和NVFP4两种版本。
入选理由:Mistral Large 4在网络安全测试中得分82%,远超其他封闭模型。
Google提出睡眠框架,通过模拟人类睡眠机制让LLM在持续学习中保留长期知识,实验显示可保留10M tokens上下文并提升推理能力。
入选理由:睡眠框架通过活跃阶段与睡眠阶段交替,使LLMs保留长达10M tokens的长期知识
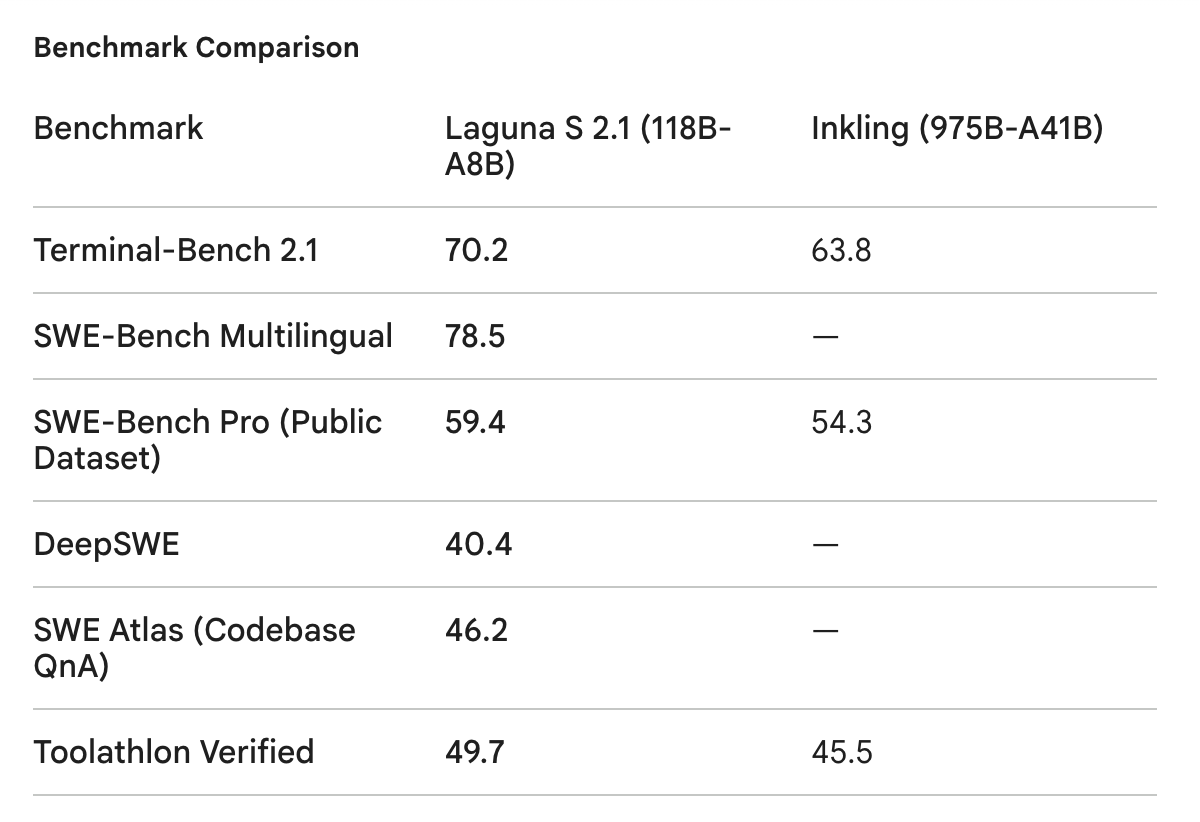
Poolside AI通过模型工厂技术实现高效训练,其Laguna S 2.1模型以118B参数规模超越竞品,揭示AGI研发路径与工程实践细节。
入选理由:模型工厂支持每月10,000–20,000次实验,实现8周内完成模型从预训练到发布的全流程
Cohere 发布 North Mini Code,一个 30B 参数的 Mixture-of-Experts 模型,专为开发者设计,在多个代码生成基准测试中表现优异。
入选理由:North Mini Code 是 Cohere 首个专为开发者设计的模型,参数量为 30B,其中 3B 为活跃参数。
Nemotron 3 Ultra是NVIDIA推出的开源AI模型,基于SSM和Mixture of Experts混合架构,推理速度比现有最佳开源模型快5倍,运行成本降低30%。
入选理由:Nemotron 3 Ultra采用SSM与Mixture of Experts混合架构,推理速度比现有最佳开源模型快5倍。
异构智能是未来AI发展的关键范式,通过融合不同架构、规模和硬件的模型协同工作,提升复杂问题解决效率。
入选理由:当前AI发展正从同质化向异构化演进,如Mixture of Experts和多代理系统已初现端倪。
目前没有明确的最佳开源MoE LLM推荐,但MoE架构可能在60GB内存下提升编码速度。
入选理由:MoE架构可能在60GB内存硬件上实现比12 tokens/秒更快的交互速度
推文内容信息密度不足,未提供技术细节或工程实践指导。
入选理由:推文内容信息密度不足,未提供技术细节或工程实践指导