多向量检索策略选型:分离度决定nDCG@10成败
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
公司
别名:milvusio
向量数据库公司,发布StructArray技术
已跟踪 30 条高相关材料
最近变化
2026-11-16 · Milvus 使用 MinHash 将文本转换为紧凑指纹以检测重复内容。
为什么值得关注
Milvus 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
With the same multi-vector model, and the same dataset, nDCG@10 can drop from 0.701 to 0.109 — rough...
Milvus(@milvusio) · 9.2 分
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
Most people use vector databases for chatbots and RAG pipelines. 𝗦𝗲𝗻𝗾𝗶 𝗔𝗜 𝘂𝘀𝗲𝘀 ...
Milvus(@milvusio) · 9.2 分
Senqi AI 使用 Milvus 向物理机器人注入长期语义记忆能力,解决真实世界任务中环境动态、任务无界、指令模糊和错误高成本等核心挑战。
𝗛𝗲𝗿𝗲'𝘀 𝗮 𝗰𝗼𝘀𝘁 𝘁𝗿𝗶𝗰𝗸 𝗺𝗼𝘀𝘁 𝘁𝗲𝗮𝗺𝘀 𝗺𝗶𝘀𝘀 𝘄𝗶𝘁𝗵 𝘁𝗵𝗲𝗶𝗿 𝘃𝗲𝗰𝘁𝗼𝗿 ...
Milvus(@milvusio) · 8.7 分
Milvus 提出通过 compaction(段合并与物理删除)和 TTL(自动过期)两项内置机制,可显著降低向量数据库存储成本,尤其适用于会话数据、时效性 RAG 等有生命周期的数据场景。
已收录 30 条与 Milvus 相关的内容,按评分排序。
多向量检索中近似策略选择错误会导致nDCG@10下降6倍,影响远超模型升级收益。应通过计算Token向量MaxSim标准差判断嵌入空间分离度:高分散选TokenANN/MUVERA,低分散选LEMUR,避免盲目调优。
入选理由:同模型数据集下,错误近似策略使nDCG@10从0.701跌至0.109,损失超模型升级收益
Senqi AI 使用 Milvus 向物理机器人注入长期语义记忆能力,解决真实世界任务中环境动态、任务无界、指令模糊和错误高成本等核心挑战。
入选理由:物理机器人Agent需实时重规划,因环境持续变化且任务无明确终点
Milvus 提出通过 compaction(段合并与物理删除)和 TTL(自动过期)两项内置机制,可显著降低向量数据库存储成本,尤其适用于会话数据、时效性 RAG 等有生命周期的数据场景。
入选理由:向量数据库中逻辑删除不释放磁盘空间,导致存储膨胀达2–5倍
Milvus 使用 MinHash 和 LSH 技术实现高效近似重复检测,可识别文本相似度。
入选理由:Milvus 使用 MinHash 将文本转换为紧凑指纹以检测重复内容。
Toss Securities通过优化Milvus的NUMA配置,使搜索吞吐量提升41%,同时保持召回率不变。
入选理由:使用HNSW与8位量化技术减少内存使用,提升搜索效率。
Milvus 3.0的StructArray技术通过单次查询获取匹配块及其上下文,提升RAG系统效率。
入选理由:StructArray将文档存储为单个实体,避免额外查询
Milvus团队通过双阶段Jev方法提升Graph RAG召回率,Recall@5达86.61%,比单阶段Jev提升6.6个百分点。
入选理由:双阶段Jev在MuSiQue和2Wiki数据集上将Recall@5从80.04%提升至86.61%
通过调整坐标轴参数,Milvus在Zilliz Cloud上将超球面图像嵌入搜索的召回率提升12.9个百分点,无需重排序即可实现98.2%的recall@10。
入选理由:调整高度坐标轴参数使召回率提升12.9%,从85.3%到98.2%
Hyper3-CLIP V1在描述性图像搜索中优于OpenAI CLIP,但广义类别搜索中余弦方法更优。
入选理由:Hyper3-CLIP V1分类准确率比OpenAI CLIP提升0.92%
Milvus 3.0支持在不中断搜索时升级嵌入模型,通过保留新旧向量实现平滑过渡,实测Recall@10提升3.8个百分点。
入选理由:Milvus 3.0允许同一集合中同时存在新旧向量字段
Milvus Function Chain通过结合语义相似性与业务信号,提升产品搜索的准确性。
入选理由:使用XGBoost模型可将语义相似性与价格/评分等业务信号融合
Jev模型通过实时验证缓存结果的五个关键维度,有效减少错误重用,节省成本并提升响应准确性。
入选理由:Jev模型在1152个案例中实现零错误重用缓存结果
Milvus 3.0通过分块嵌入和后期交互提升视觉密集PDF检索精度,解决单向量压缩导致的细节丢失问题。
入选理由:视觉密集PDF检索需采用分块嵌入替代单向量表示
Milvus 3.0的StructArray Hybrid Search通过同时处理多级数据结构,提升复杂场景下的搜索效率。
入选理由:StructArray Hybrid Search支持同时搜索视频层级和嵌套观察,如“白色卡车在交叉口”
Milvus向量数据库支撑全球最大音乐平台实现百亿级音轨检索,10ms级P99延迟,覆盖歌曲识别、版权匹配等场景。
入选理由:Milvus处理超百亿向量数据,支持每秒数百次搜索请求
EverOS结合Milvus实现AI代理长期记忆,支持BM25和向量搜索,适合需要跨对话记忆管理的项目。
入选理由:EverOS通过LLM提取对话记忆并保存为Markdown文件,支持人工审查
Jev在重排序任务中表现优于qwen3.7-text-rerank,但延迟和成本显著更高,适合离线场景而非实时RAG。
入选理由:Jev的nDCG@10提升0.0778,但延迟是qwen的10.2倍
Milvus 3.0 支持直接连接外部数据源进行索引和搜索,无需移动数据。Vector Lakebase 架构实现数据湖与向量数据库的原生集成。
入选理由:External Collection 支持 Parquet/Iceberg 等 5 种数据格式的原生接入
编写有效代理指令的8个技巧,涵盖流程图设计、明确目标、工具整合等关键点。
入选理由:使用流程图工具(如Mermaid.js)可视化业务流程可提升团队协作效率
Milvus开源DSH插件实现与DeepSeek Harness集成,通过‘Everything is a Plugin’设计支持多种搜索操作但限制只读访问。
入选理由:DSH插件已获192K+ GitHub星标,核心设计为‘Everything is a Plugin’架构。
Cốc Cốc采用Milvus实现越南国家级AI搜索,处理6亿向量,延迟低至19.8ms。
入选理由:Milvus支持6亿向量生产,计划扩展至15亿规模
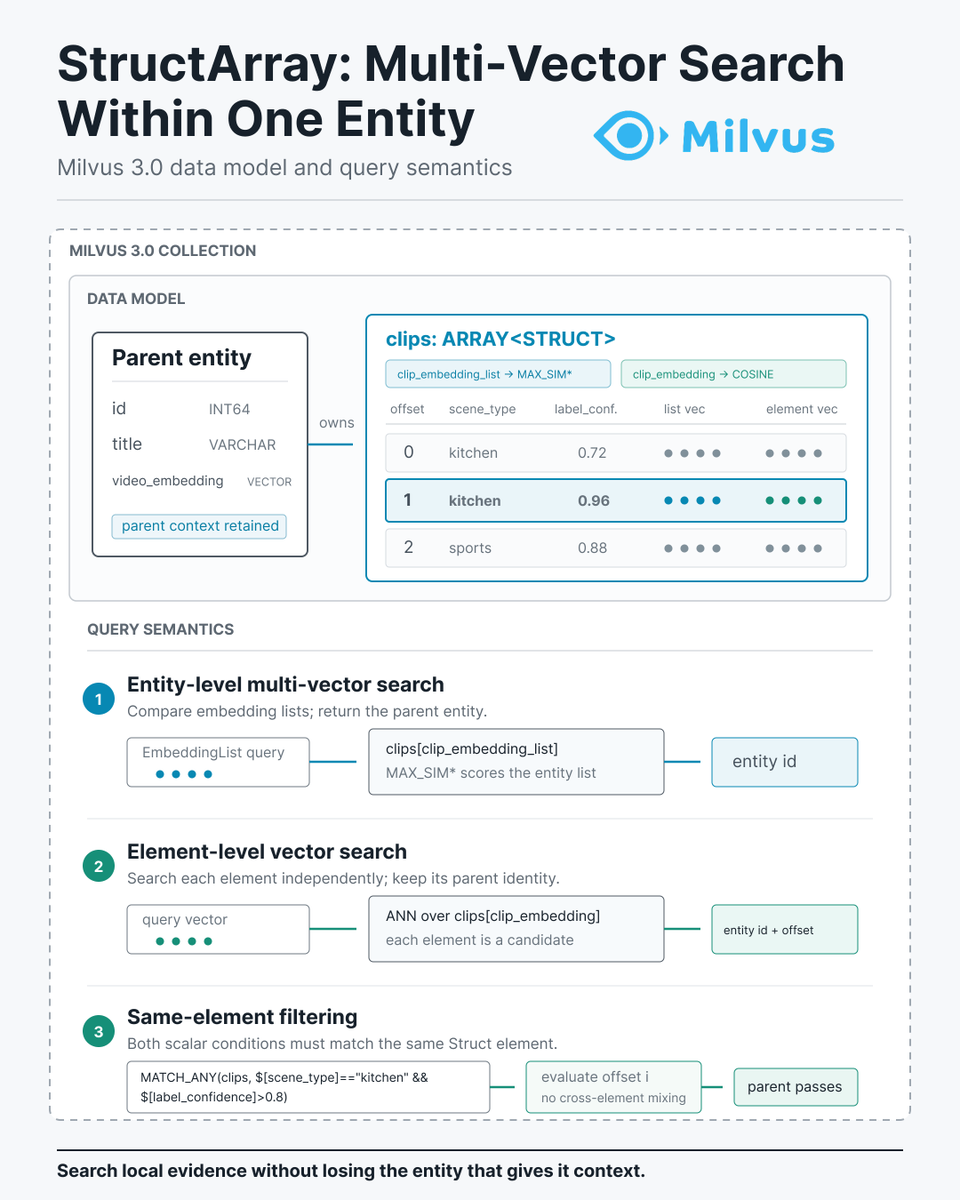
Milvus 3.0 StructArray 支持多向量搜索,保持元素与父实体关联,提升检索效率。
入选理由:StructArray 支持实体级、元素级和相同元素过滤三种检索模式
Milvus 3.0通过引入lake-native External Collections和增强检索功能,改变传统检索架构假设,提升数据处理灵活性和查询控制能力。
入选理由:External Collections支持数据原地处理,减少数据迁移开销
AI代理错误答案常源于检索系统缺陷而非模型本身,需优先调试召回层而非直接优化模型。
入选理由:调试AI代理应优先检查召回层的recall@k指标和过滤器命中率
Milvus 3.0通过in-engine排名、聚合和多向量搜索增强检索能力,减少生产环境中的自定义逻辑需求。
入选理由:Milvus 3.0支持ORDER BY对ANN候选结果进行排序,减少应用层逻辑
Milvus Snapshots通过轻量级快照机制解决向量数据库升级和数据回填的恢复痛点,避免全量备份开销。
入选理由:Milvus Snapshots仅记录元数据和索引文件,无需复制向量数据,备份效率提升显著
Milvus快照通过引用而非复制数据,实现高效的数据版本管理。其核心价值在于模型升级前的数据备份与回滚验证。
入选理由:快照通过引用对象存储文件实现零数据冗余,节省存储成本
嵌入模型选择在2026年更依赖数据形态而非排行榜,不同数据类型需匹配特定模型以保留上下文信息。
入选理由:文本知识库推荐Qwen3 Embedding、BGE-M3等密集嵌入模型
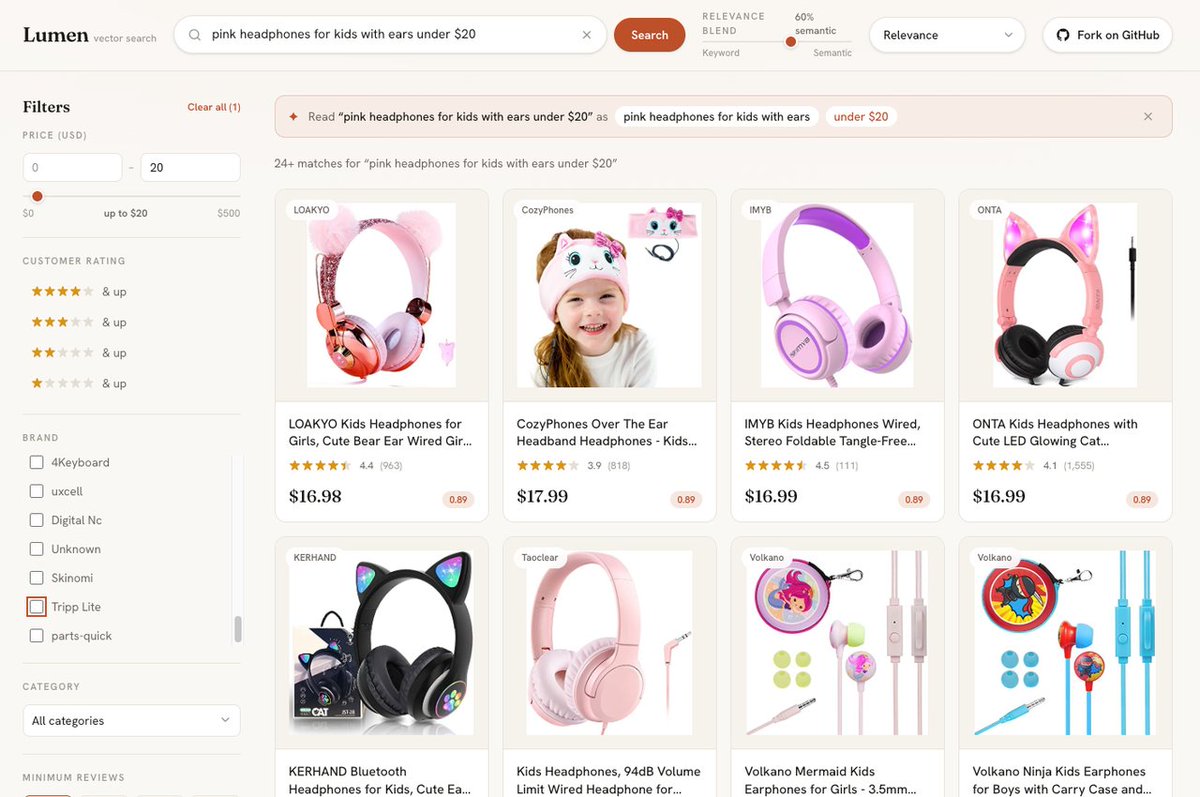
电商搜索需结合语义相似性、结构化过滤和关键词信号,Milvus的Lumen演示展示了多技术整合方法。
入选理由:使用BM25实现精确关键词匹配,结合密集向量搜索处理语义意图
Milvus 3.0 引入 External Collections,实现湖数据零拷贝索引,解决数据冗余与搜索效率问题。
入选理由:External Collections 支持 Parquet/Lance/Iceberg 等湖格式,无需数据迁移