T
traeai
登录

概念

LoRA

别名:low-rank adaptation

参数高效的模型微调技术

已跟踪 29 条高相关材料

TraeAI 观察

相关材料

已收录 29 条与 LoRA 相关的内容,按评分排序。

Machine Learning Mastery 图标

How to Train Your own Decision Model like Jev using Unsloth

Machine Learning Mastery4068 字 (约 17 分钟)
85

使用Unsloth和Qwen3.5-4B模型可训练决策模型,通过CLINC150数据集实现用户意图分类,输出结构化预测结果。

入选理由:Unsloth的FastDecisionModel可将语言模型转换为选择预定义选项的决策模型

精选文章#Unsloth#Qwen#决策模型#LoRA#CLINC150英文
Hugging Face Blog 图标

Palette: teaching a small model to build decks in your design language

Hugging Face Blog2079 字 (约 9 分钟)
85

Palette模型通过合成数据和分角色训练,使小模型能生成符合特定设计语言的幻灯片,且在PresentBench上表现优异。

入选理由:Palette使用合成数据训练,基于IBM设计语言生成幻灯片

精选文章#AI模型#设计语言#幻灯片生成#LoRA适配器#PresentBench英文
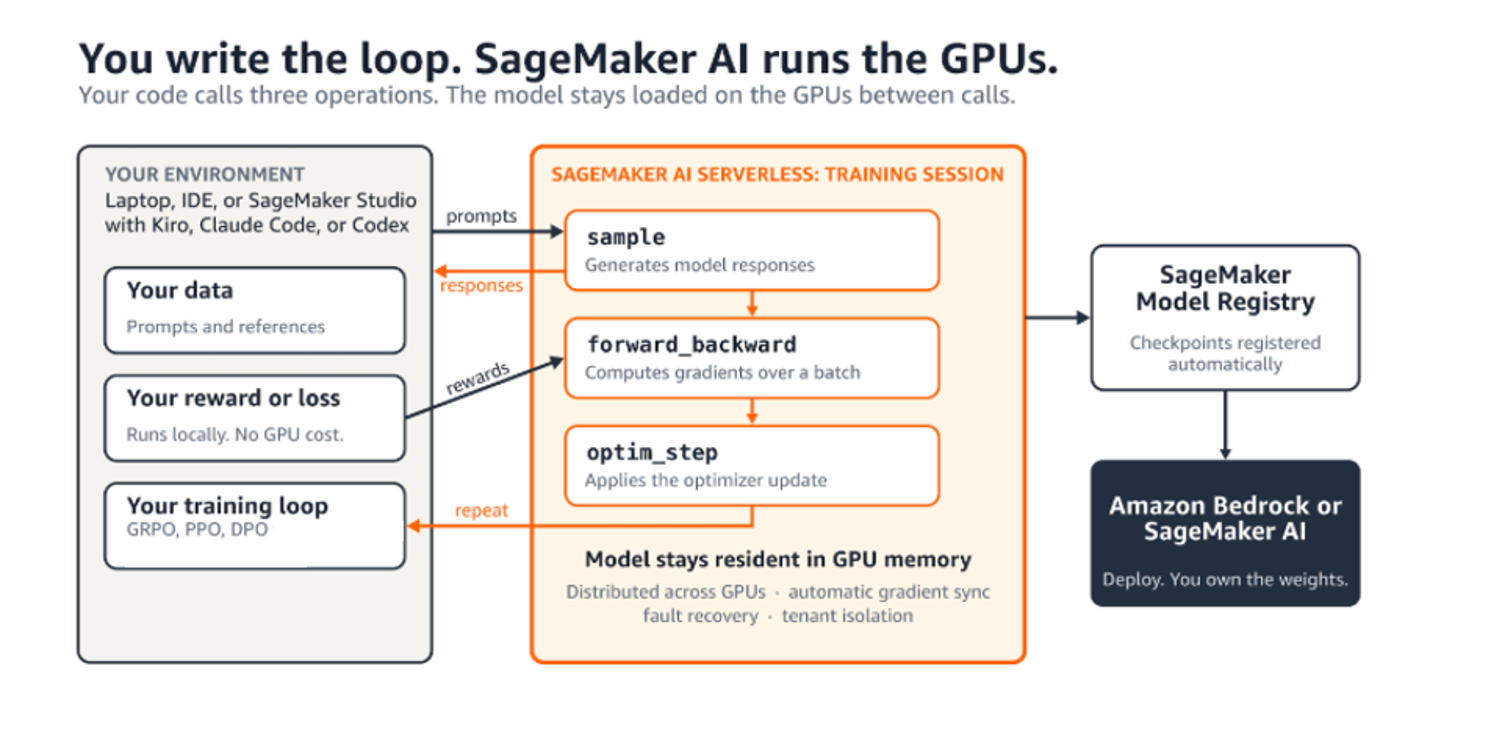
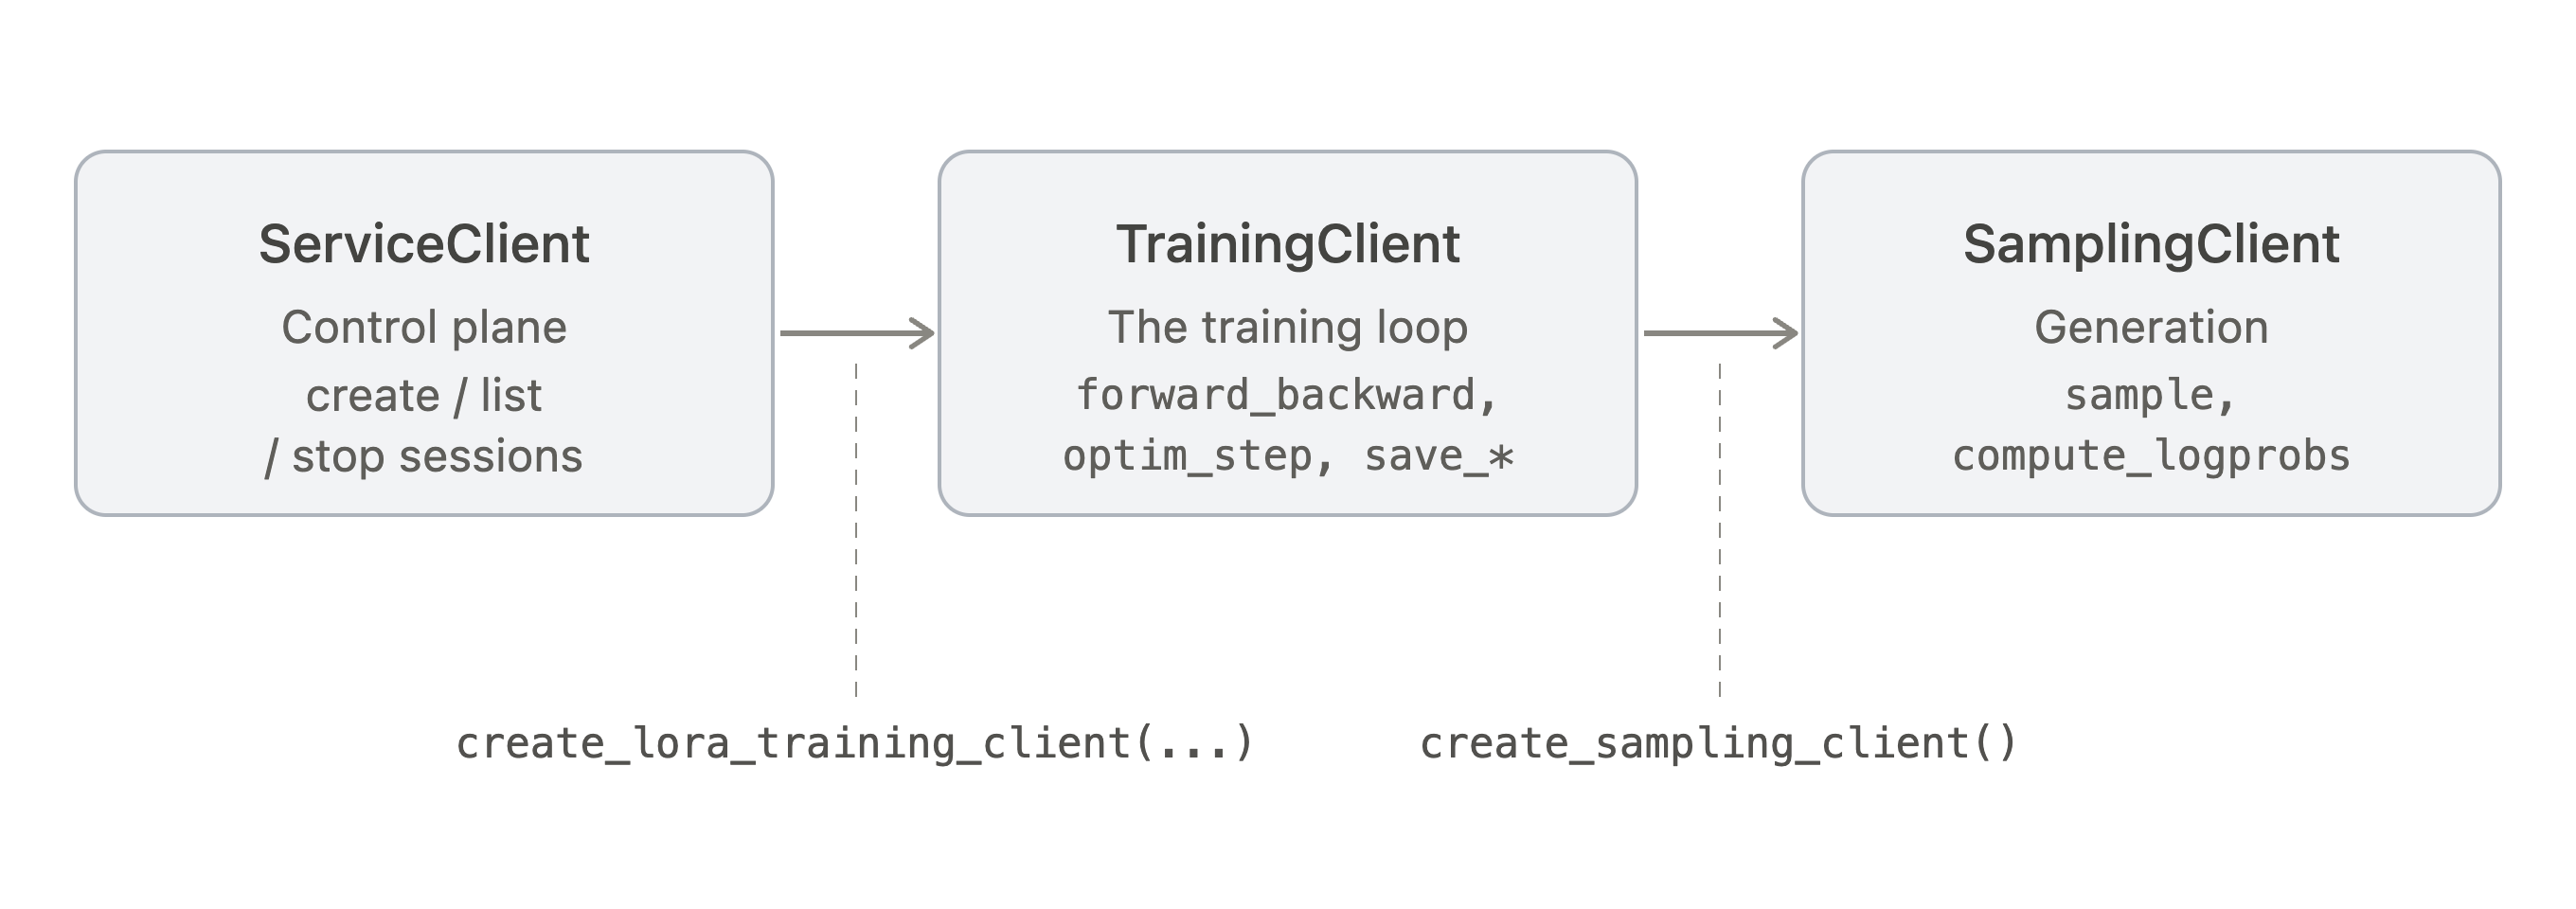
Write your own training loop — without managing GPUs — with Amazon SageMaker training session APIs

AWS SageMaker推出训练会话API,允许用户自定义训练循环而无需管理GPU,提升算法灵活性与基础设施效率。

入选理由:SageMaker训练会话API提供forward_backward()等操作,用户可组合成任意训练流程。

精选文章#Amazon SageMaker#机器学习#GPU管理#训练API英文
Announcing new ways to customize models with SageMaker AI, without managing GPUs

Announcing new ways to customize models with SageMaker AI, without managing GPUs

AWS Machine Learning Blog1093 字 (约 5 分钟)
85

AWS推出SageMaker AI无服务器模型定制功能,用户无需管理GPU即可进行LoRA/全微调等定制,提升模型精度与生产效率。

入选理由:SageMaker AI训练会话支持LoRA和全微调,无需管理GPU基础设施

精选文章#SageMaker AI#模型定制#AWS#无服务器#强化学习英文
What I learned from companies training their own models

What I learned from companies training their own models

Gradient Flow1367 字 (约 6 分钟)
85

企业自研模型时,持续预训练和模型工厂构建比单一模型优化更重要。多家企业通过混合训练策略实现领域知识深度适配。

入选理由:持续预训练使模型领域知识提升3倍(C3 AI案例中从11%到60%)

精选文章#模型训练#持续预训练#企业AI#模型工厂英文
Together AI Blog 图标

Together Post-Training: frontier-grade model shaping, the way that fits you

Together AI Blog1964 字 (约 8 分钟)
85

Together AI推出Post-Training服务,提供灵活高效的自定义模型训练,无需重基础设施负担。

入选理由:支持LoRA训练和全权重实验,提升模型灵活性

精选文章#AI模型训练#自定义模型#Together AI#RL#SFT英文
KDnuggets 图标

2026年,ML、AI和LLM工程师的职责差异显著,ML工程师负责模型训练,AI工程师连接模型与产品,LLM工程师专注于语言模型的微调。

入选理由:ML工程师核心工作是数据收集与模型训练

精选文章#AI职业#机器学习#LLM#职业规划英文
Google Developers Blog 图标

Autonomous LLM post-training with Tunix on TPUs

Google Developers Blog854 字 (约 4 分钟)
85

Google利用Tunix和Cloud TPUs实现LLM微调的自主研究循环,显著提升效率。

入选理由:AI代理可自动优化LoRA参数和学习率调度,减少人工干预

精选文章#LLM微调#Tunix#Cloud TPU#自主研究循环英文
Machine Learning Mastery 图标

Prompt Caching vs. Fine-Tuning: A Cost and Latency Decision Framework

Machine Learning Mastery1386 字 (约 6 分钟)
85

提示缓存和微调是优化代理AI系统成本与延迟的两种策略,文章提供决策框架帮助选择合适方案。

入选理由:提示缓存可使重复请求计算成本降至零,但需额外存储开销

精选文章#LLM#AI优化#微调#缓存策略英文
Together AI Blog 图标

The production platform for open-weight AI inference

Together AI Blog1714 字 (约 7 分钟)
85

Together AI推出的新推理平台使用户能高效部署和管理开放权重模型,兼顾控制、成本与性能。

入选理由:开放权重模型成本仅为封闭模型的几分之一,但质量相当。

精选文章#AI推理平台#开放权重模型#模型部署#Together AI英文
Hugging Face Blog 图标

Beyond LoRA: Can you beat the most popular fine-tuning technique?

Hugging Face Blog2821 字 (约 12 分钟)
85

LoRA 是当前最流行的 PEFT 技术,但文章建议探索其他方法以获得更优效果。

入选理由:LoRA 在 Hugging Face Hub 上被 98.4% 的模型卡提及,是当前最主流的 PEFT 技术。

精选文章#PEFT#LoRA#模型微调#Hugging Face英文
OpenAI Blog 图标

Parameter Golf挑战赛教会了我们什么

OpenAI Blog1224 字 (约 5 分钟)
85

Parameter Golf挑战赛展示了AI辅助研究的潜力,包括训练优化、量化、测试策略和新模型创意。

入选理由:超过1,000名参与者提交了2,000多个方案,展示了广泛的技术创造力。

精选文章#AI#机器学习#竞赛#参数优化中文
Five Ways to Fine-Tune Chronos-2, the Time Series Foundation Model

微调Chronos-2时间序列基础模型的五种方法

Towards Data Science4139 字 (约 17 分钟)
82

Chronos-2时间序列基础模型可通过LoRA微调解决零样本预测偏差,文章详解了单建筑适配、组合池化、协变量注入等五种实战场景及数据划分规范。

入选理由:使用LoRA冻结120M参数主模型,仅训练低秩适配器以高效适配私有数据。

精选文章#Chronos-2#时间序列基础模型#LoRA#微调#预测英文
Vol.119|对话 Macaron AI 创始人 Andrew:下一代模型公司正在从 Agent 产品里长出来?

Mind Lab(Macaron AI)创始人Andrew提出,下一代模型公司正从Agent产品中诞生,通过LoRA强化学习和持续学习技术,在真实场景中让AI Agent不断进化,实现个性化、可交互的长期智能服务。

入选理由:Mind Lab实现了万亿参数规模的LoRA强化学习,并构建了支持DSA和MTP的LoRA RL基础设施。

精选播客#Agent#LoRA#强化学习#持续学习#Personal AGI中文
科技爱好者周刊(第 396 期):互联网通信的替代方案

科技爱好者周刊(第 396 期):互联网通信的替代方案

阮一峰的网络日志4964 字 (约 20 分钟)
80

文章介绍互联网中断时的替代通信方案,包括LoRa协议和Meshtastic设备。

入选理由:LoRa协议可实现几十公里无线通信,设备成本低至几百元。

精选文章#LoRa#Meshtastic#AI开发中文
SuperTechFans 图标

2026年5月29日HackerNews热点摘要

SuperTechFans13231 字 (约 53 分钟)
78

AI提升白领产能催生四天工作制设想,但收益多被资本攫取;YouTube将自动为逼真AI视频打标;Opus 4.8小幅改进,社区更关注GRAM小模型路径;LLM事实核查分歧大;Win10可4K运行《模拟城市3000》。

入选理由:AI提升生产力未显著改善普通开发者薪资与休假,反而加剧财富集中,需政策与工会集体行动保障员工权益

精选文章#AI伦理#生成式AI#LLM#工作制度#内容治理中文
本周 HuggingFace 热度第一的论文:RecursiveMAS(递归多Agent系统)

多个 AI 组队协作,现在已经是主流方案。

模型 A 想好了传给模型 B,模型 B 想好了传给模型 ...

RecursiveMAS 提出 Agent 间直接传递内部向量而非文本,减少 token 翻译开销,在数学推理任务上提升 13–18 个百分点,推理快 2.4×,Token 节省 75%。

入选理由:Agent 协作中文字中转导致严重信息损失与计算冗余

精选推文#Multi-Agent#LLM#Recursive Reasoning#HuggingFace#AI Systems中文
Stream live training runs on Hugging Face!

Stream live training runs on Hugging Face!

Hugging Face(@huggingface)86 字 (约 1 分钟)
75

Hugging Face 正在直播训练 LoRA 适配器以提升模型效率和准确性,涉及 LFM2.5/3 和 Twil-9B 模型。

入选理由:使用 LoRA 适配器优化 LFM2.5/3 和 Twil-9B 模型

精选推文#Hugging Face#机器学习#模型训练#LoRA#RL英文
“After PMF” is the when. How to post-train is more complex: which technique fixes which problem? 

W...

模型微调应在产品市场契合点(PMF)后进行,以利用真实用户数据优化模型。Fireworks AI分享了不同技术如何解决特定问题及降低成本的方法。

入选理由:模型微调应在产品市场契合点(PMF)后启动,此时用户数据更具训练价值。

精选推文#模型微调#产品市场契合#AI优化#推理成本英文

跨材料问答 · LoRA

回答基于:LoRA 相关 29 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容