EP233: Kubernetes Explained for Busy Engineers
ByteByteGo Newsletter1129 字 (约 5 分钟)
85
Kubernetes 是一个用于管理容器化应用部署和维护的编排平台,适合工程师快速理解其核心机制。
入选理由:Kubernetes 通过 deployment.yaml 文件定义应用的期望状态。
精选文章#Kubernetes#容器化#系统设计英文
产品
别名:K8s
容器编排系统,开源社区治理典型案例
已跟踪 30 条高相关材料
最近变化
2026-11-14 · Kubernetes 通过 deployment.yaml 文件定义应用的期望状态。
为什么值得关注
Kubernetes 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
EP233: Kubernetes Explained for Busy Engineers
ByteByteGo Newsletter · 8.5 分
Kubernetes 是一个用于管理容器化应用部署和维护的编排平台,适合工程师快速理解其核心机制。
LinkedIn Replaces Argo CD with a Custom GitOps Engine for Kubernetes Deployments
InfoQ · 8.5 分
LinkedIn用自定义GitOps引擎替代Argo CD,提升Kubernetes部署效率,故障率下降93%。
CoreWeave Database Is Here: Managed PostgreSQL Where Your AI Runs
CoreWeave · 8.5 分
CoreWeave推出托管PostgreSQL数据库,专为AI工作负载优化,实现与GPU同集群部署、自动备份及高可用性。
已收录 30 条与 Kubernetes 相关的内容,按评分排序。
Kubernetes 是一个用于管理容器化应用部署和维护的编排平台,适合工程师快速理解其核心机制。
入选理由:Kubernetes 通过 deployment.yaml 文件定义应用的期望状态。
LinkedIn用自定义GitOps引擎替代Argo CD,提升Kubernetes部署效率,故障率下降93%。
入选理由:自定义GitOps引擎使部署故障率从925降至63,降幅达93%。
CoreWeave推出托管PostgreSQL数据库,专为AI工作负载优化,实现与GPU同集群部署、自动备份及高可用性。
入选理由:CoreWeave Database支持现有PostgreSQL无缝迁移,兼容原生工具。
LinkedIn、Netflix和DoorDash等公司分享了在生产环境中运行AI代理、评估和推理的架构与实践,涵盖权限管理、评估流程和模型服务优化。
入选理由:Figma通过预热池将代理配置延迟降低90%,可用性提升至99.95%
Red Hat OpenShift 5通过引入agentic applied AI和Lightspeed功能,实现跨混合云的自主运维,同时保持人工控制关键决策。
入选理由:Red Hat OpenShift Lightspeed将AI从对话助手升级为可执行集群变更的代理
开源社区需通过治理框架应对AI辅助开发带来的代码审查瓶颈,Red Hat提出需结合责任、透明度与法律考量的AI政策。
入选理由:Kubernetes社区通过AI政策解决代码审查效率与信任问题
Lakebase的分支技术通过copy-on-write机制,使CI/CD中的PR数据库创建时间缩短至60秒内,存储效率提升显著。
入选理由:copy-on-write分支使100个并发PR数据库的存储仅增加变更数据
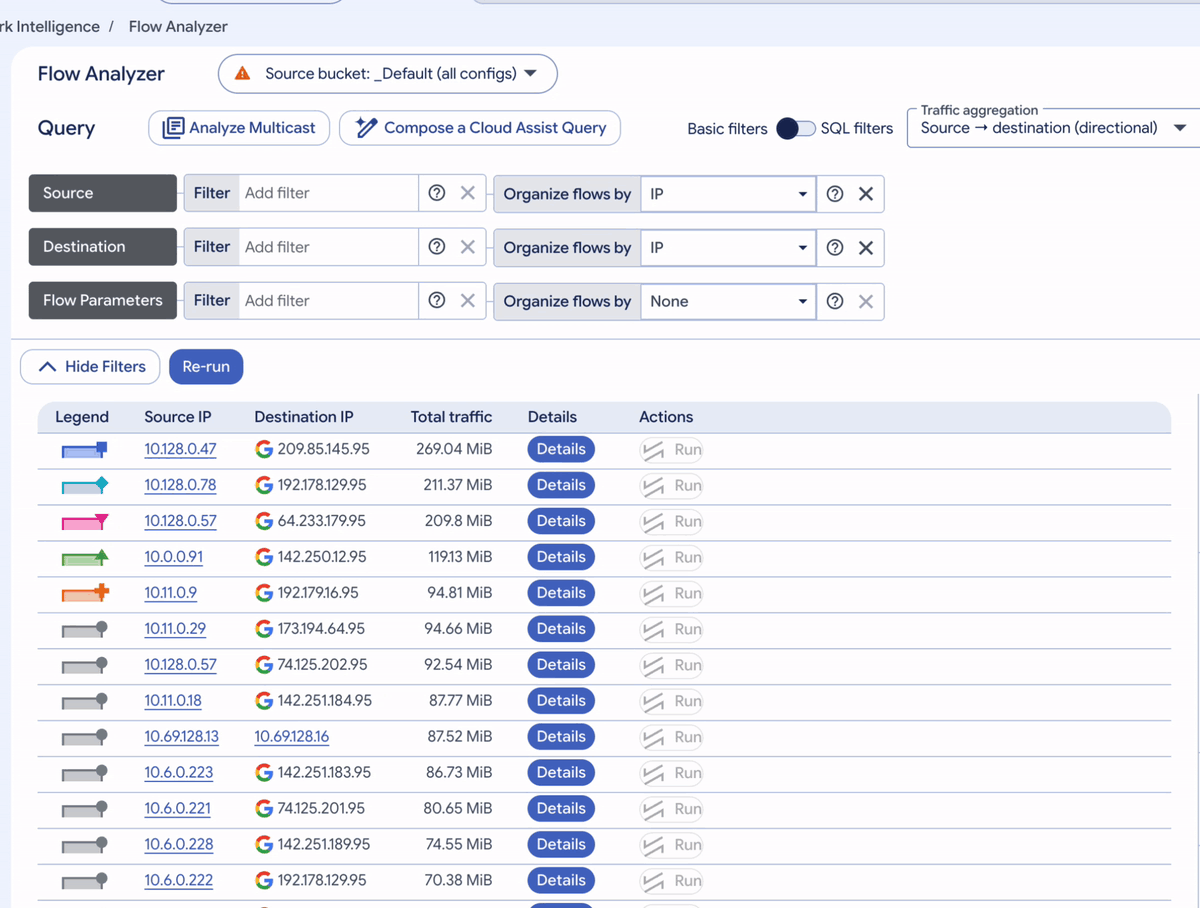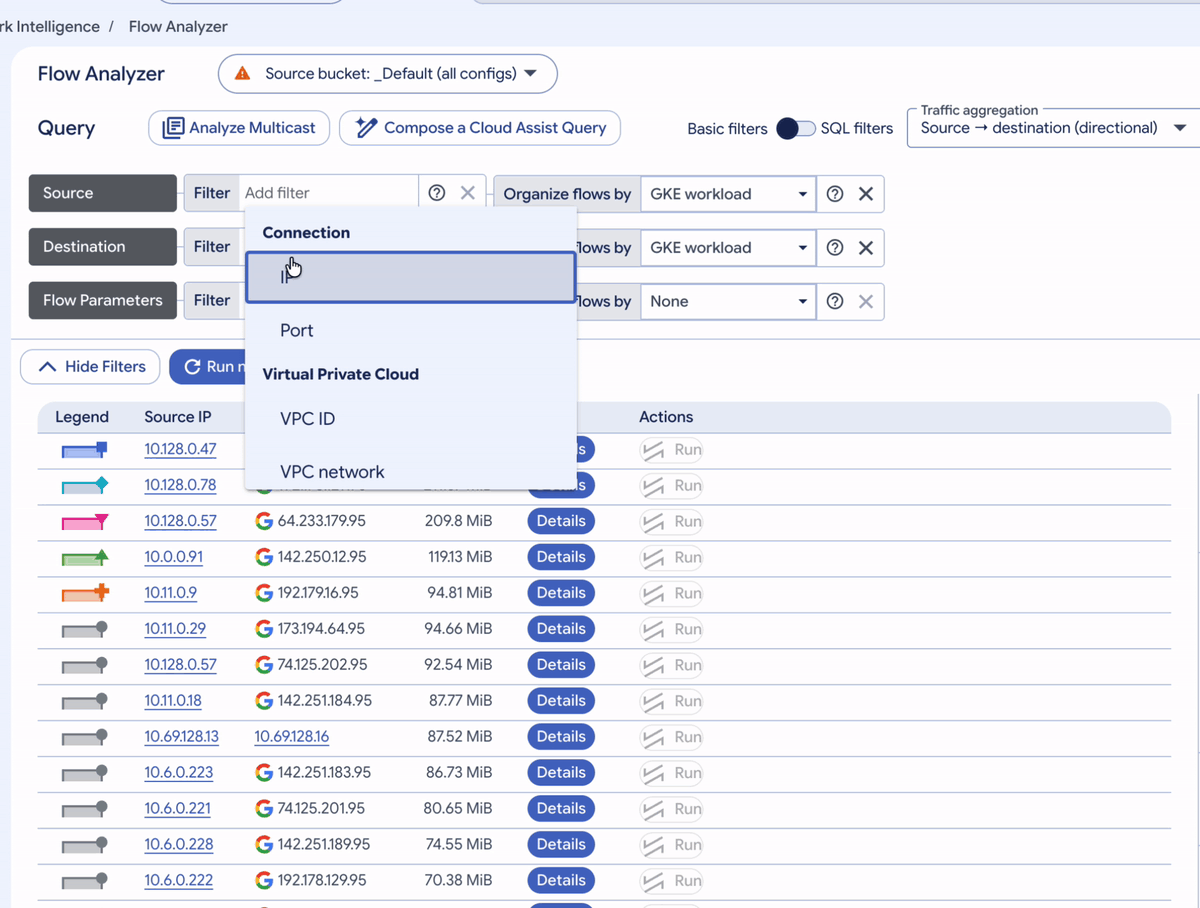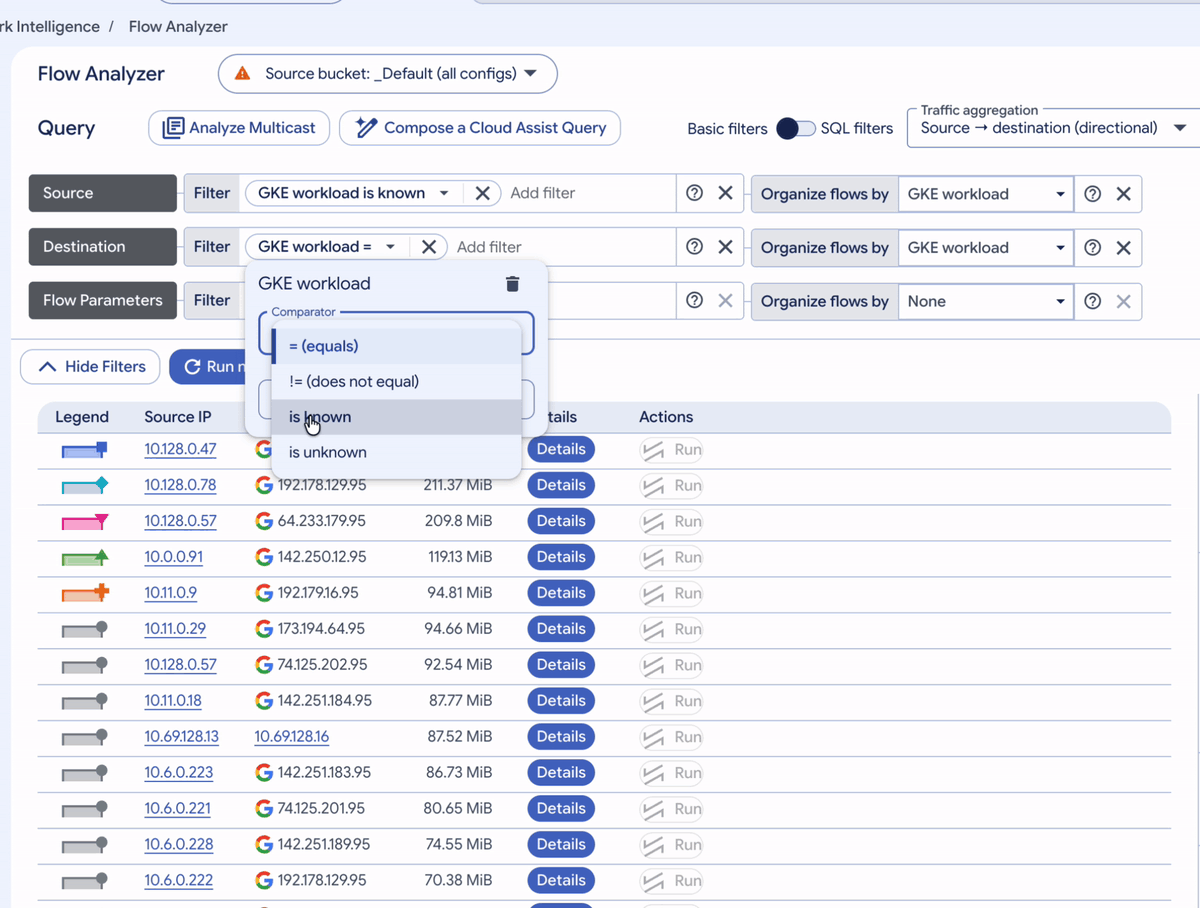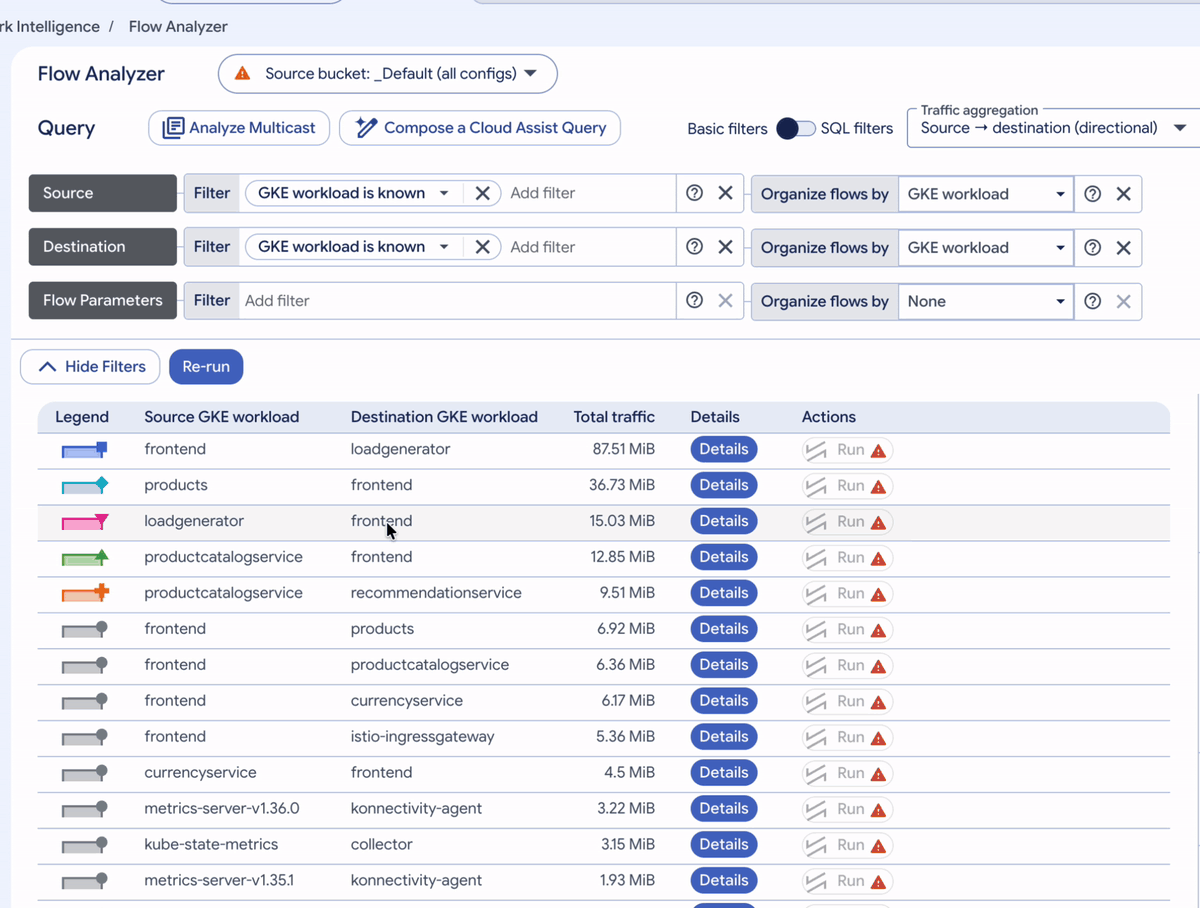
Google Cloud的VPC Flow Logs通过集成GKE元数据,显著提升排查GKE工作负载问题的效率。
入选理由:VPC Flow Logs可自动关联GKE元数据(如Pod名称、命名空间)实现网络流量溯源
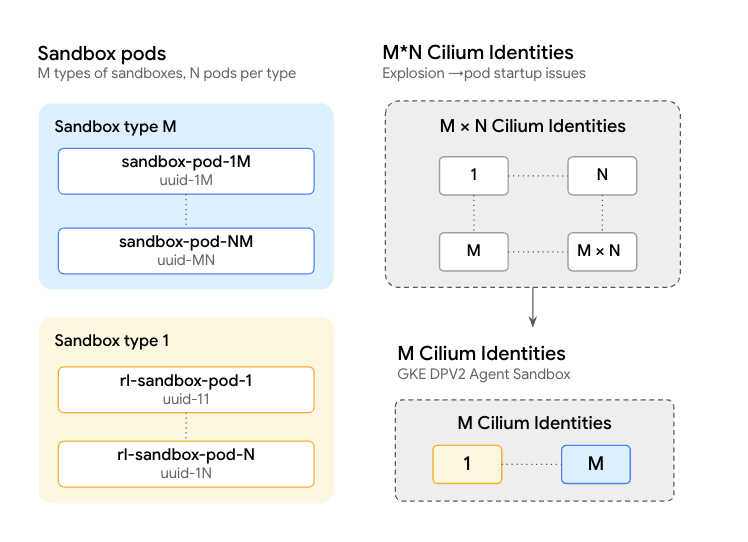
GKE Dataplane V2通过eBPF技术优化网络身份管理,实现亚秒级配置,支持高密度AI代理工作负载。
入选理由:GKE Dataplane V2使用eBPF将Pod标签映射为数字身份,提升网络安全性。
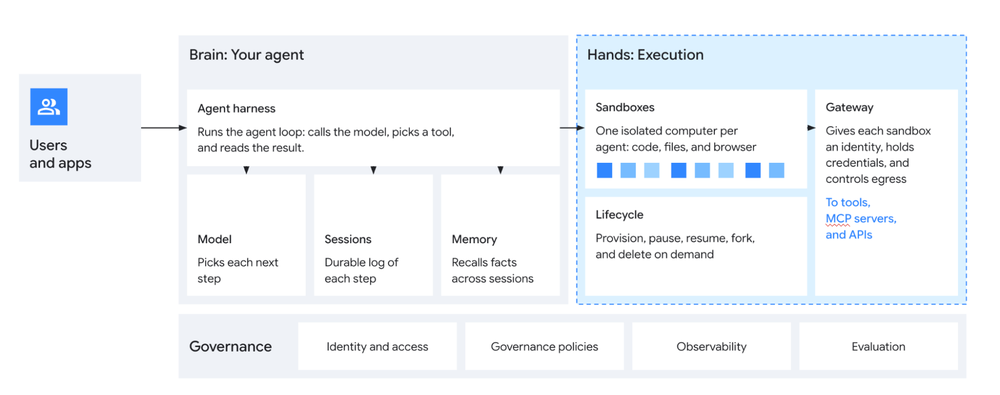
Google推出Agent Compute Engine,为每个AI代理提供硬件隔离的微虚拟机,解决agentic AI在大规模部署中的性能与安全挑战。
入选理由:ACE通过硬件隔离的microVM实现容器级性能与安全隔离
开源AI服务已从实验阶段进入成熟基础设施,Red Hat的vLLM和llm-d项目解决了大规模集群中的模型服务挑战。
入选理由:vLLM项目已纳入PyTorch基金会并支持多硬件架构
Red Hat AI 3.5通过优先级感知服务机制,在共享GPU上实现低延迟处理,95%的高优先级请求在0.5秒内响应。
入选理由:Red Hat AI 3.5的优先级队列机制使95%的高优先级请求在0.5秒内得到第一个token。
CoreWeave推出SUNK新功能,简化AI研究集群构建,提升训练效率。
入选理由:SUNK自我服务功能可将集群搭建时间缩短30%以上
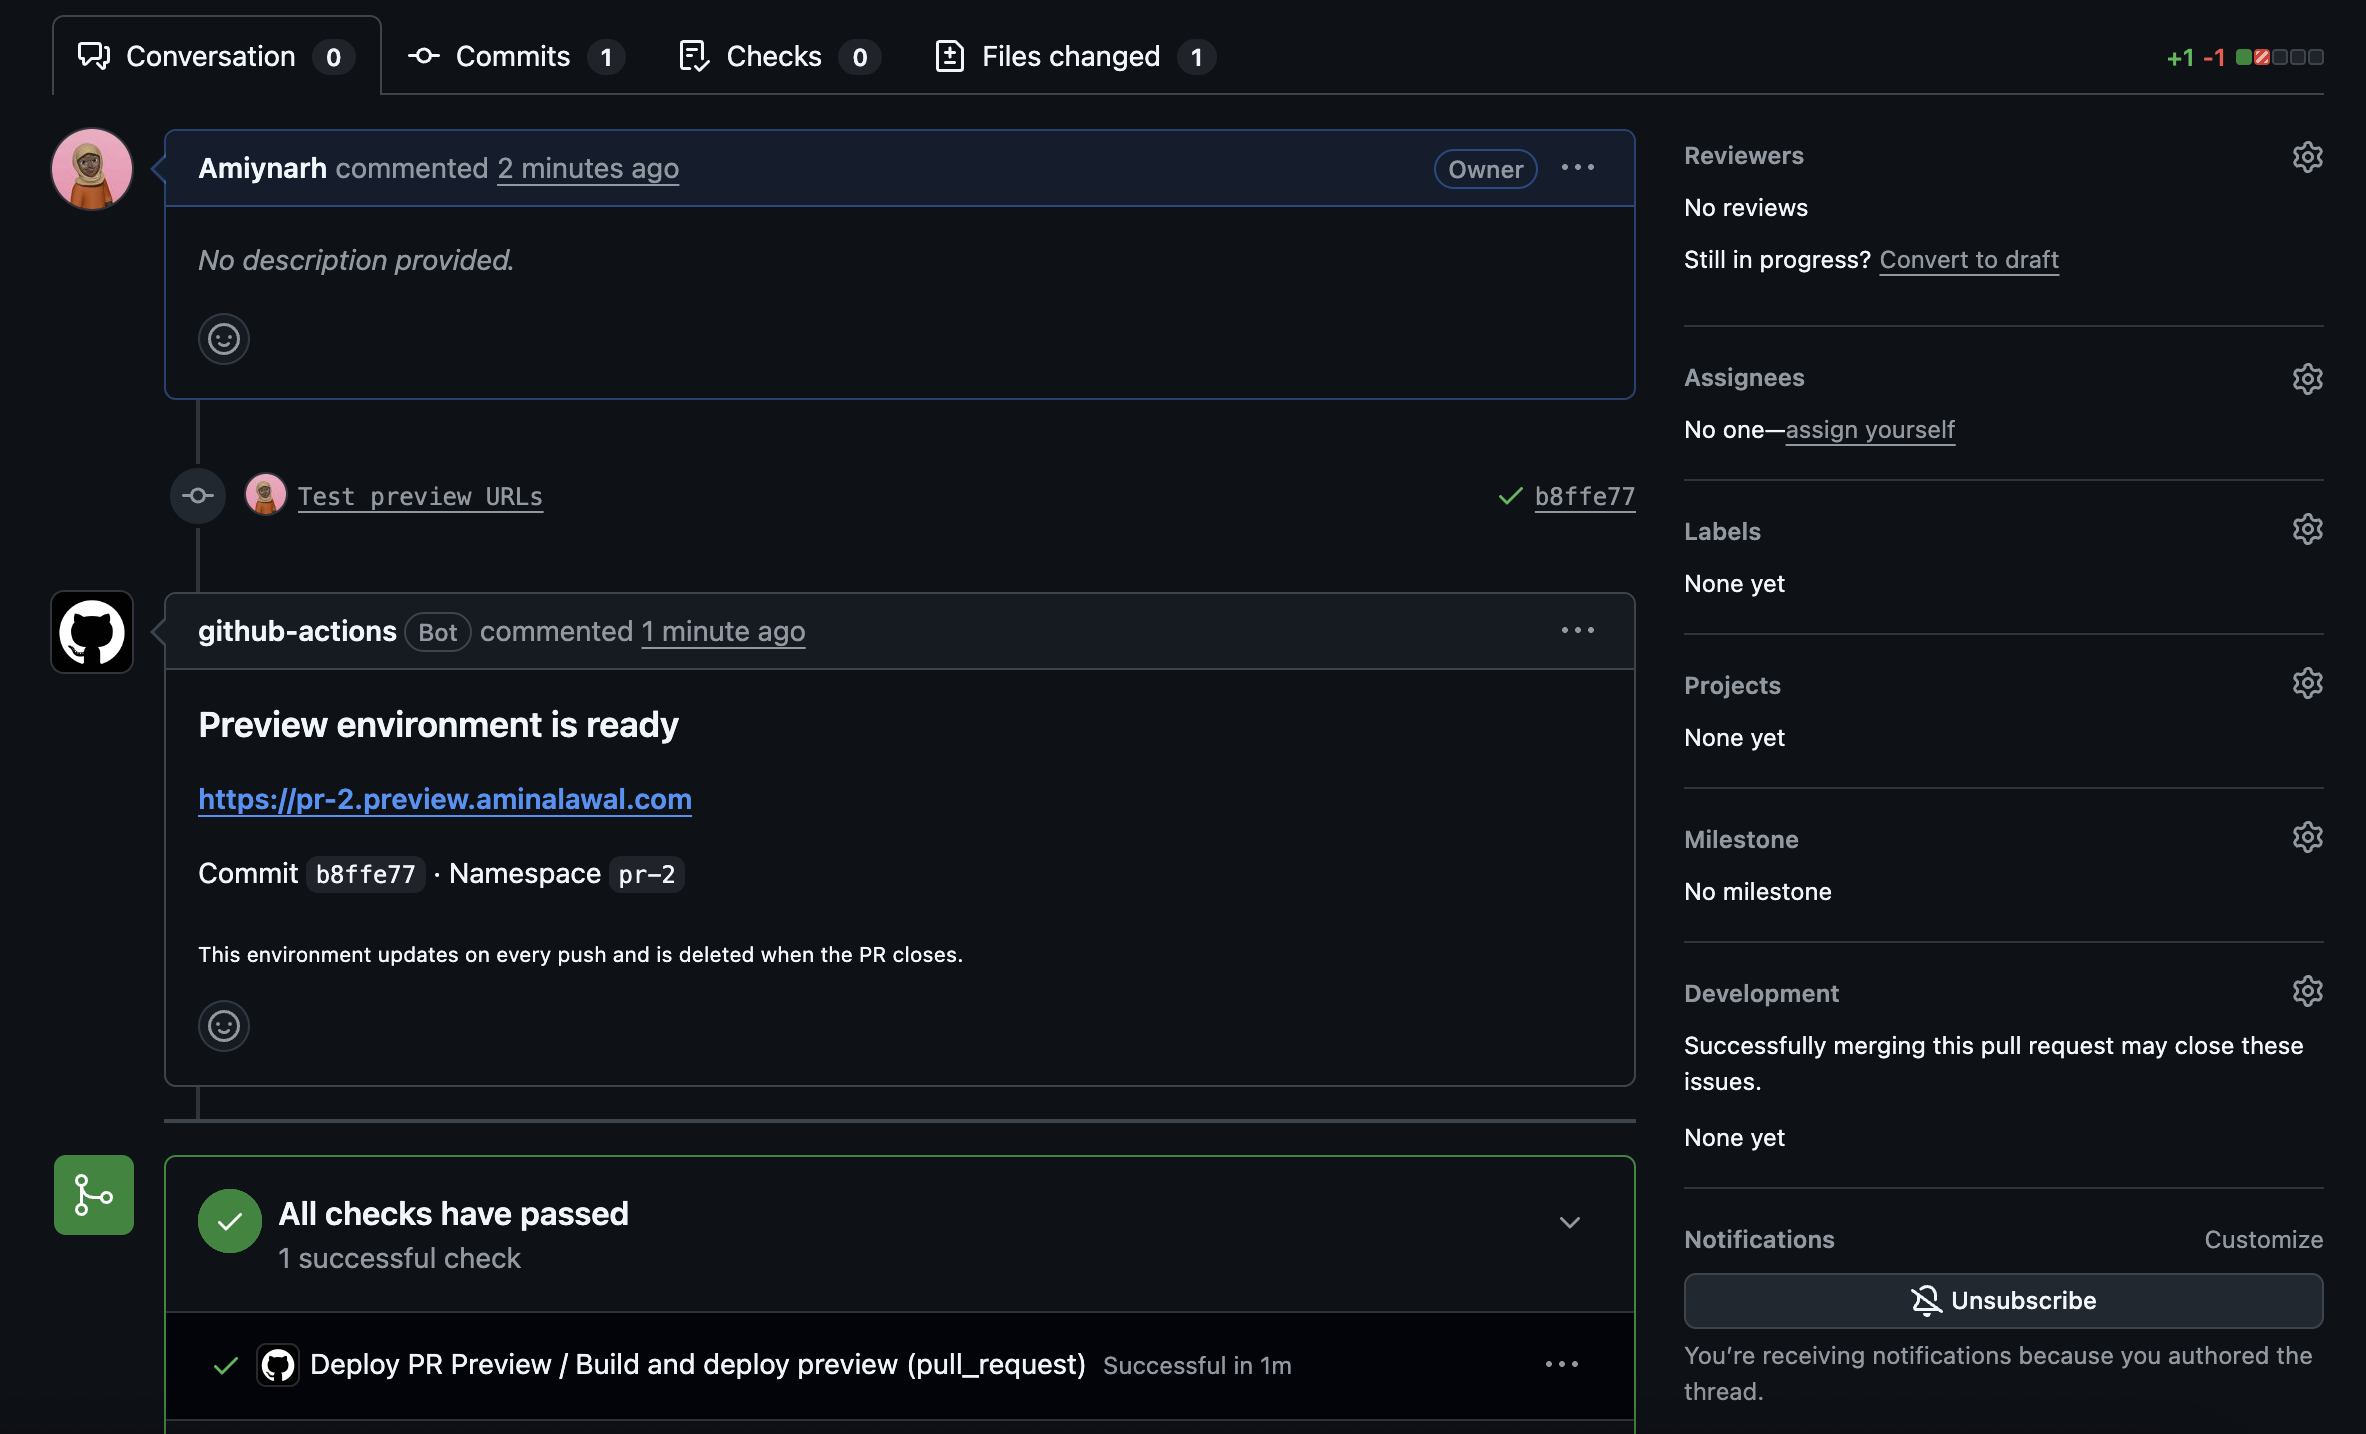
本文介绍如何使用GitHub Actions、Ingress和自动TLS在GKE上构建临时PR预览环境,实现每个PR独立部署和自动清理。
入选理由:每个PR触发GitHub Actions构建独立Kubernetes命名空间(如pr-42)
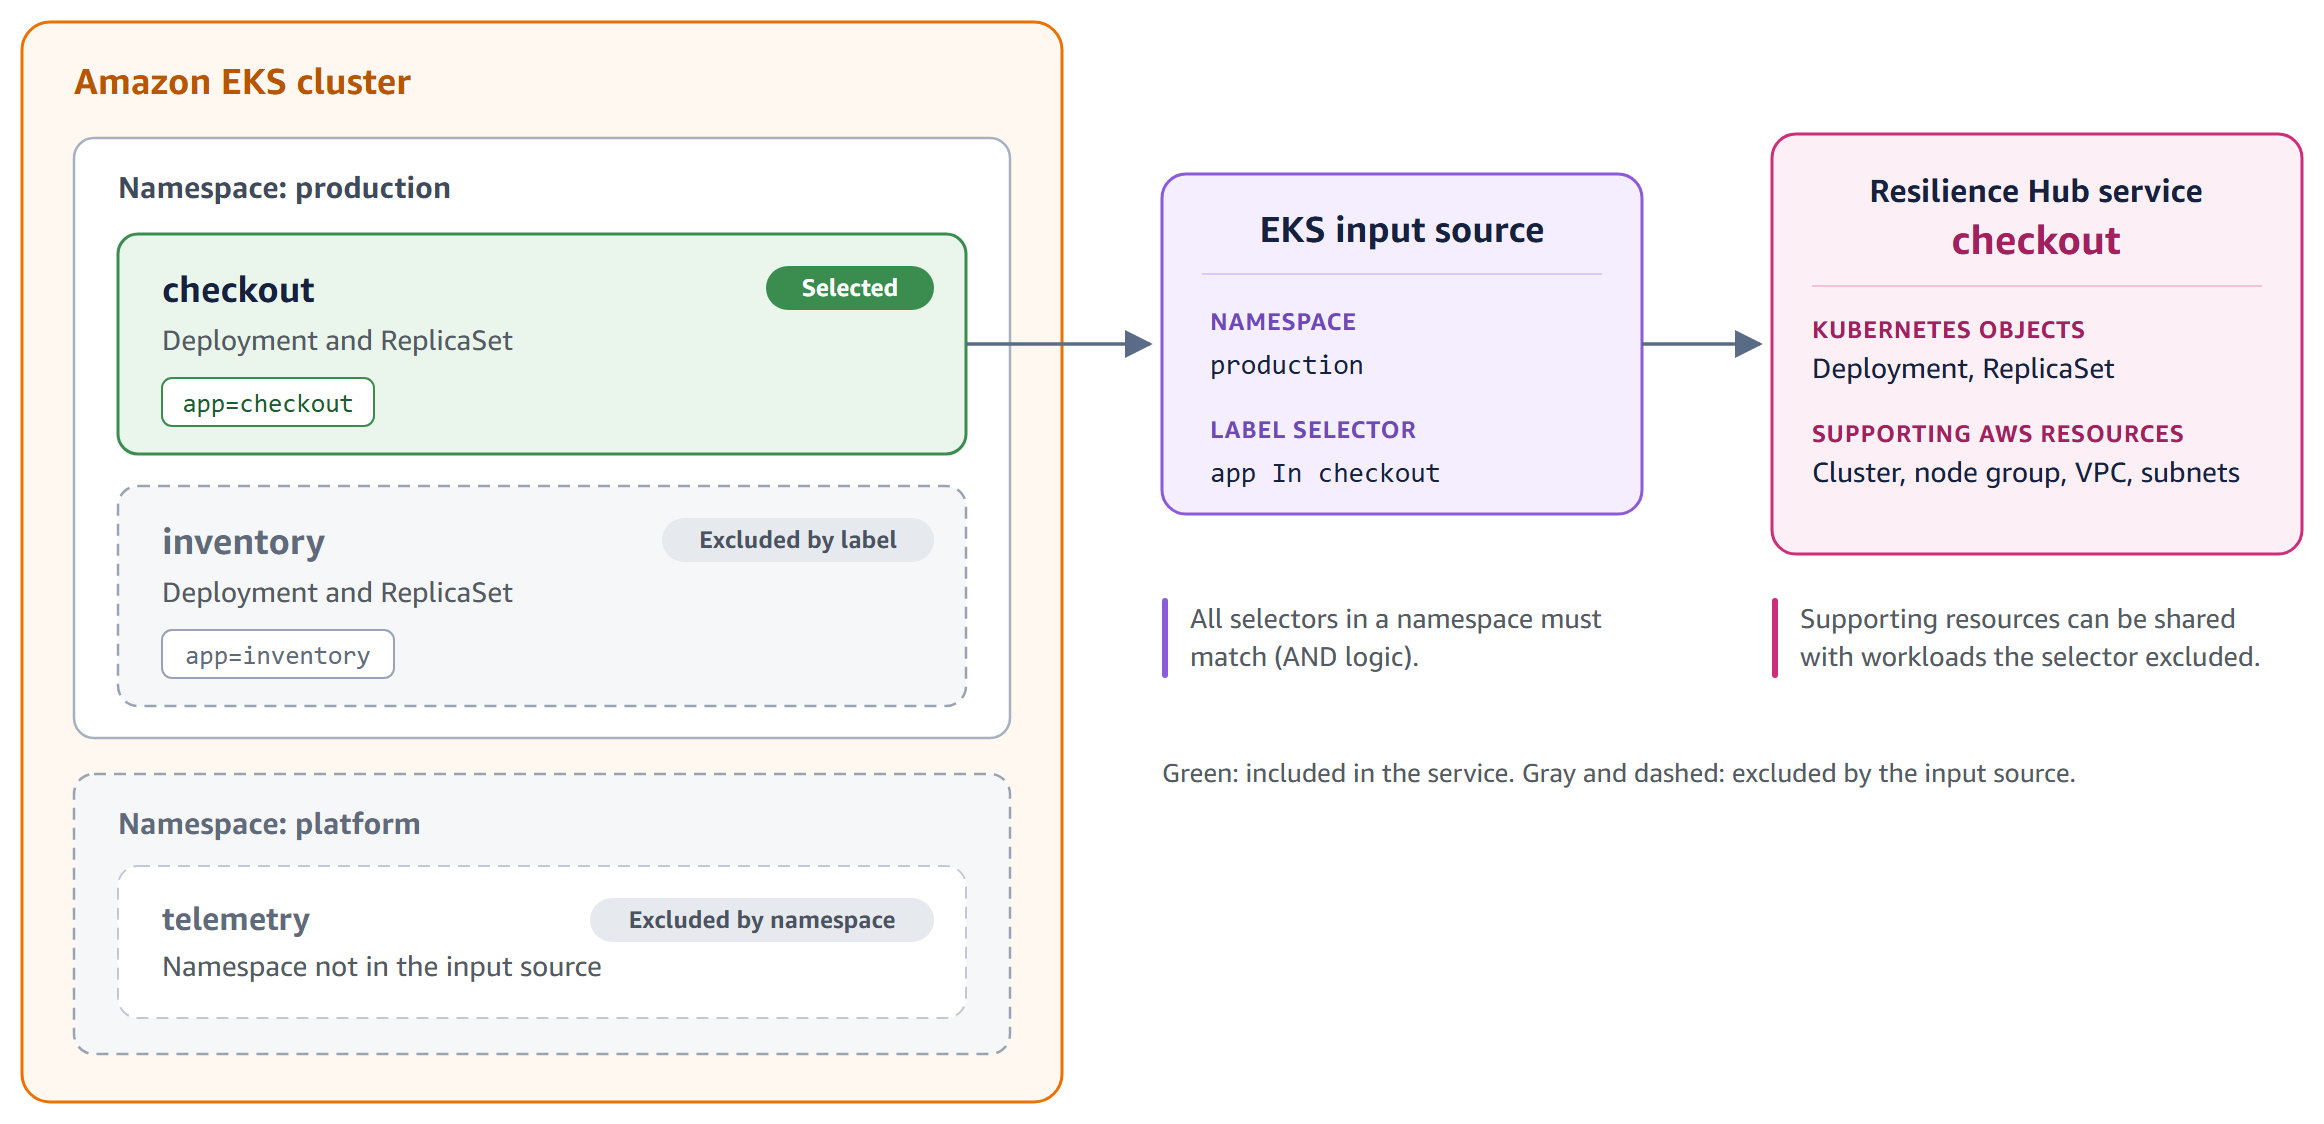
AWS Resilience Hub新增Kubernetes标签支持、AI依赖分析和跨账户策略共享功能,提升云环境韧性管理效率。
入选理由:使用Kubernetes标签精准定义服务资源边界
生产环境中的AI代理需平衡权限控制、评估机制与成本,InfoQ 2026年QCon会议揭示了授权模型、评估循环和提示压缩等实践方案。
入选理由:生产代理需结合长期服务账户与细粒度权限控制,避免过度授权或限制
OpenTelemetry的Kubernetes Attributes Processor升级至v1.0.0,提升可观测性数据稳定性。
入选理由:Kubernetes Attributes Processor已稳定支持日志、指标和跟踪数据
Ray框架成为AI基础设施标准,与Kubernetes整合构建统一AI栈,LinkedIn展示三层PyTorch训练架构。
入选理由:Ray与Kubernetes协同进化是AI基础设施核心趋势
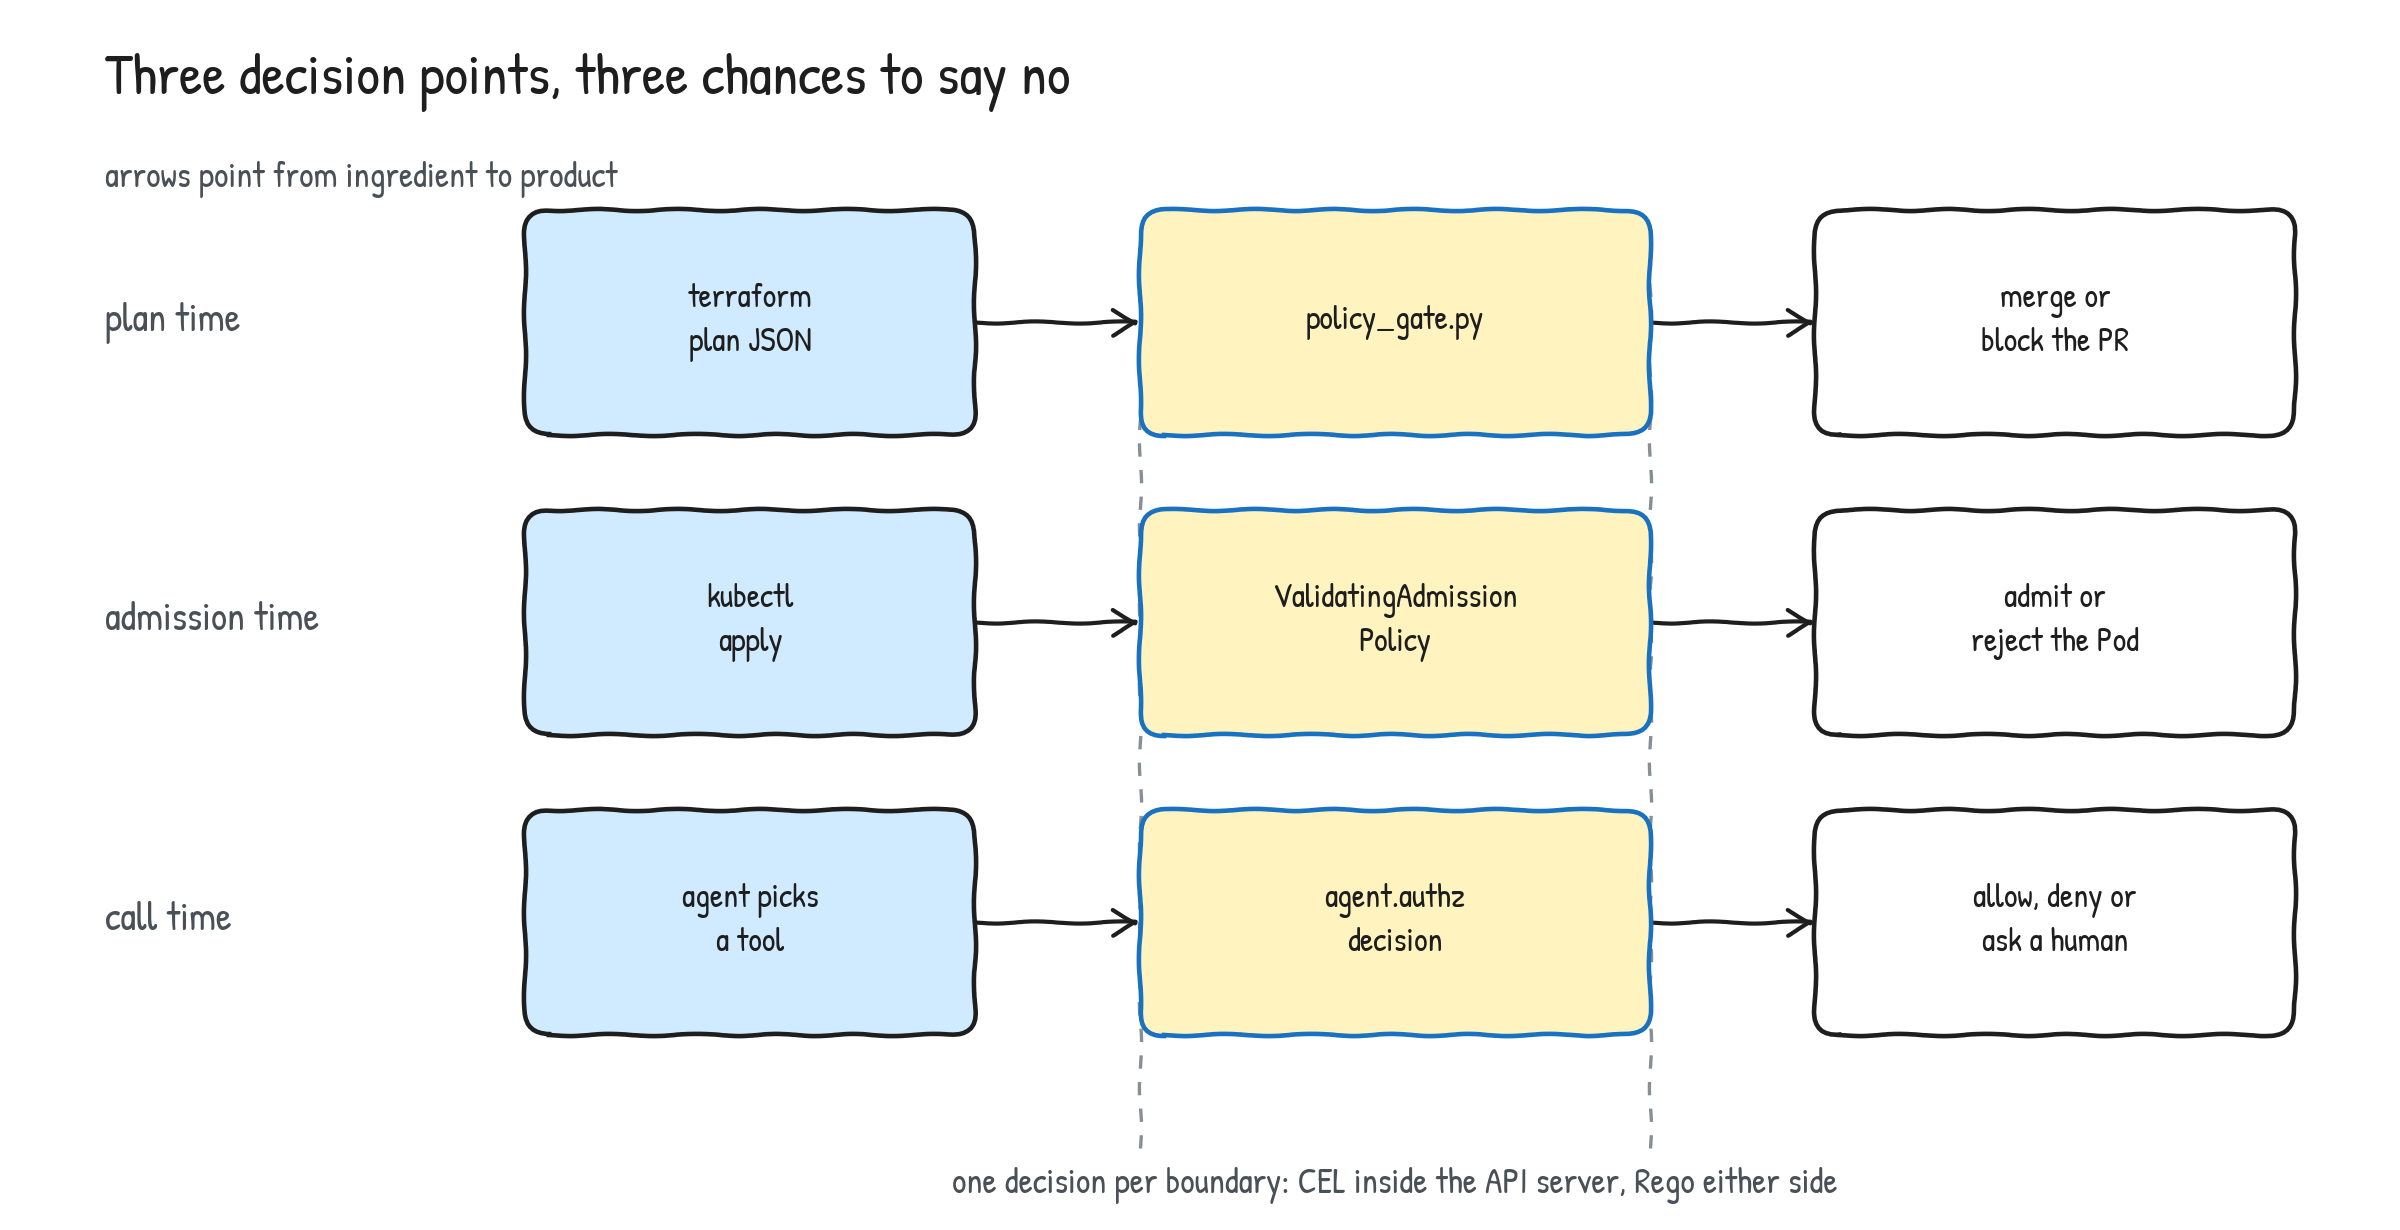
AI生成的基础设施代码存在44%安全漏洞,需用Policy as Code和OPA实现自动化治理,包含Veracode等权威机构的实证数据。
入选理由:AI生成代码安全通过率仅56%,44%存在风险漏洞
Karmada成为首个CNCF毕业的多集群Kubernetes项目,支持AI训练任务调度和跨云资源管理。
入选理由:Karmada v1.19版本实现AI训练任务的多组件调度增强
Together AI推出预占式计算,以一半价格提供相同GPU资源,适用于中断容忍型任务。
入选理由:预占式节点按50%按需价格计费且支持亚小时计费
Red Hat与Rafay联合发布的主权AI云参考架构,为电信运营商提供标准化、自助服务的GPU云解决方案,解决平台和商业化双重挑战。
入选理由:Red Hat平台解决多站点GPU环境标准化部署难题,降低70%运维复杂度
Red Hat通过赞助OpenClaw基金会推动生产级AI代理的开源基础设施,解决企业级安全与部署需求。
入选理由:Red Hat通过BYOA策略支持混合云环境中自主代理运行
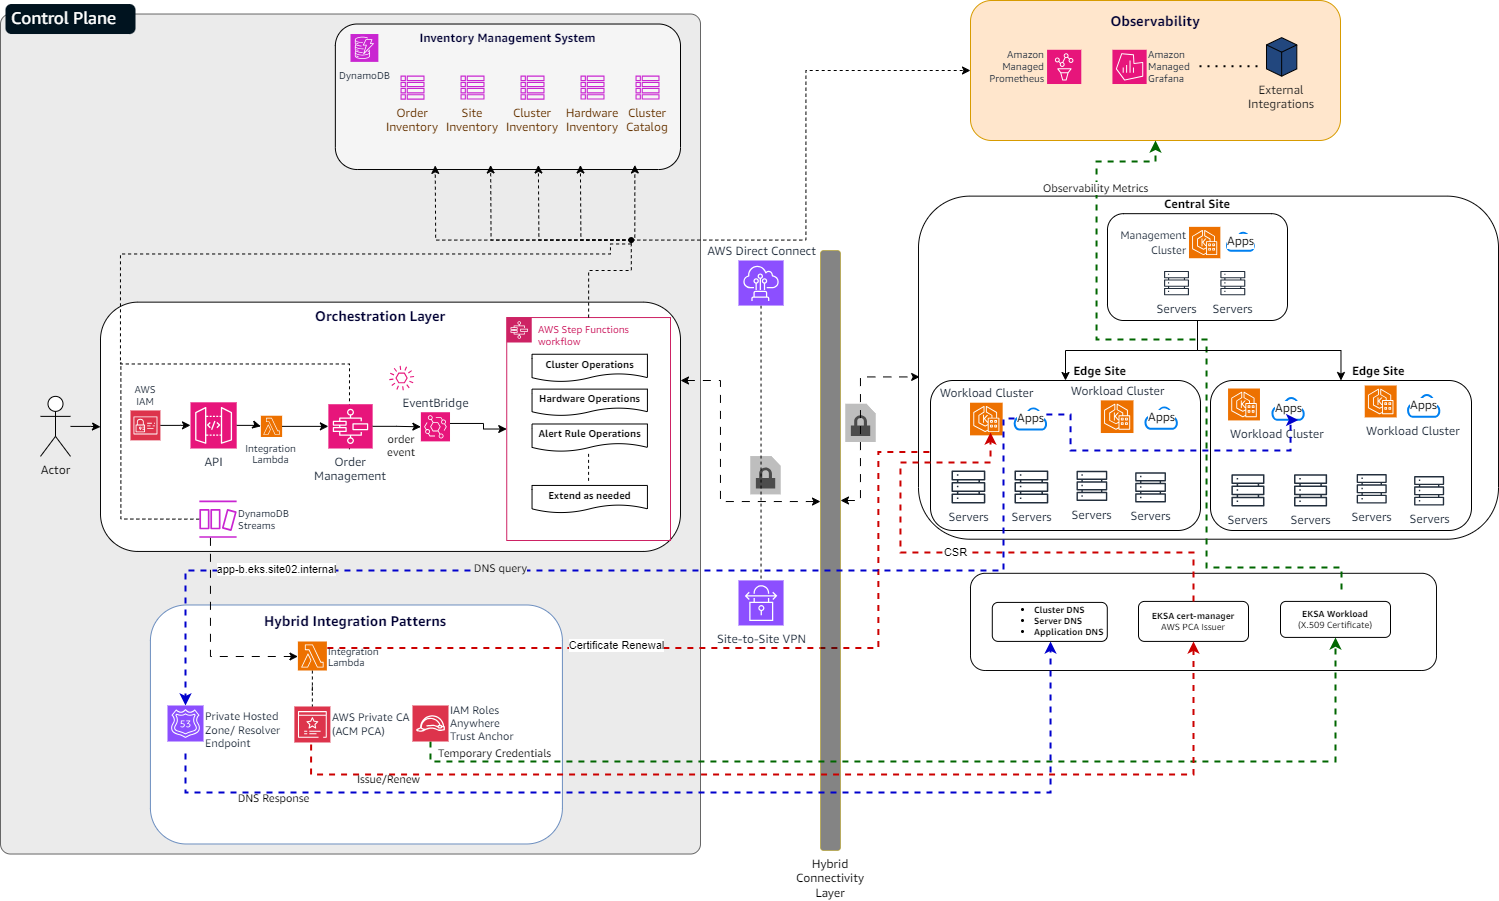
AWS展示了如何利用无服务器技术构建混合云编排解决方案,实现大规模本地基础设施的集中管理。
入选理由:使用AWS Lambda+Step Functions+DynamoDB构建事件驱动的编排引擎
Grafana Labs分享了如何扩展Alloy作为中央遥测网关的实践,涵盖容量规划、负载测试和生产经验。
入选理由:处理数千万级时间序列时需预留300%冗余容量
Grafana Cloud推出监控质量报告,通过自动化评估服务的遥测数据完整性,提升全栈可观测性。
入选理由:使用Grafana Cloud的Knowledge Graph仪表板可实时评估服务监控质量得分
企业级AI系统需构建包含计算、存储、服务和集成的四层架构,自托管与托管模式各有权衡。
入选理由:企业AI系统依赖四层基础设施:计算、模型存储、服务层和系统集成
企业级AI部署需权衡托管API与自托管模型,Red Hat提供集成解决方案。
入选理由:托管API降低运维成本但可能增加长期费用
开源是防止供应商锁定的运营策略,强调基础设施代码所有权对架构主权的决定性作用,AI模型临时性与控制平面战略价值成为核心议题。
入选理由:开源本质是基础设施层的所有权控制策略,非单纯道德选择
Verus通过形式化验证确保Rust代码的正确性,提升软件安全性。该工具可验证Rust unsafe代码和并发逻辑,已被Amazon和Kubernetes等项目采用。
入选理由:Verus支持Rust unsafe代码块的数学验证,确保性能关键模块安全