Apache Spark 实时模式助力游戏实时会话化:更高效的亚秒级会话管理
以 Apache Spark Real-Time Mode 和 transformWithState 构建统一、低延迟(亚秒级)架构,替代 Flink 或自研方案,支撑百万级玩家的个性化、推荐与内容调度。
入选理由:使用 transformWithState + Real-Time Mode 实现单引擎统一架构,输入处理与定时触发均可达亚秒级精度。
产品
别名:Apache Kafka
传统CDC方案常用的分布式消息系统
已跟踪 11 条高相关材料
最近变化
2026-11-05 · Zerobus Ingest 3.7版本支持直接推送CDC到Delta表,无需Kafka中间件
为什么值得关注
Kafka 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Apache Spark Real-Time Mode for Gaming: A Better Way to Do Real-Time Sessionization
Databricks · 8.7 分
以 Apache Spark Real-Time Mode 和 transformWithState 为核心,为游戏实时会话化提供统一、低延迟(亚秒级)架构,替代 Flink 或自研方案,支持百万级玩家的个性化、推荐与内容调度。
Push-based CDC into Unity Catalog with Zerobus Ingest and Debezium
Databricks · 8.5 分
Databricks通过Zerobus Ingest和Debezium实现无需Kafka的CDC推送,简化数据复制流程。
How we halved DNS build delay and cut memory use by 85%
The Cloudflare Blog · 8.5 分
Cloudflare通过引入目标构建计划器和新调度器,将DNS构建延迟减少50%,内存使用降低85%。
已收录 11 条与 Kafka 相关的内容,按评分排序。
以 Apache Spark Real-Time Mode 和 transformWithState 构建统一、低延迟(亚秒级)架构,替代 Flink 或自研方案,支撑百万级玩家的个性化、推荐与内容调度。
入选理由:使用 transformWithState + Real-Time Mode 实现单引擎统一架构,输入处理与定时触发均可达亚秒级精度。
Databricks通过Zerobus Ingest和Debezium实现无需Kafka的CDC推送,简化数据复制流程。
入选理由:Zerobus Ingest 3.7版本支持直接推送CDC到Delta表,无需Kafka中间件
Cloudflare通过引入目标构建计划器和新调度器,将DNS构建延迟减少50%,内存使用降低85%。
入选理由:目标构建计划器选择最小安全构建,减少内存使用85%
Uber通过归一化计算单元(NCUs)解决有状态工作负载的CPU分配问题,提升资源利用率。
入选理由:不同CPU核心性能差异可达2倍,传统分配方式导致资源浪费或不足
Grafana Tempo 3.1引入基于TraceQL查询的敏感数据擦除和采样感知指标,使查询性能提升近两倍。
入选理由:Tempo 3.1支持通过TraceQL查询自动擦除敏感数据,无需手动枚举trace ID
Apache Hudi数据湖管道需用时间在队列度量替代传统偏移量滞后指标,以精准保障数据新鲜度SLA。
入选理由:传统Kafka偏移量滞后无法反映数据实际新鲜度,可能导致SLA违规
云原生基础设施已成为可信代理AI的基石,Kubernetes等技术可支撑多代理系统的可观测性与弹性。
入选理由:Kubernetes提供自主AI系统所需的弹性与编排能力
Tempo 3.0 通过 Kafka 兼容架构和 TraceQL metrics GA 降低总拥有成本并提升可扩展性。
入选理由:Tempo 3.0 采用 Kafka 兼容架构,提升微服务部署的可扩展性。
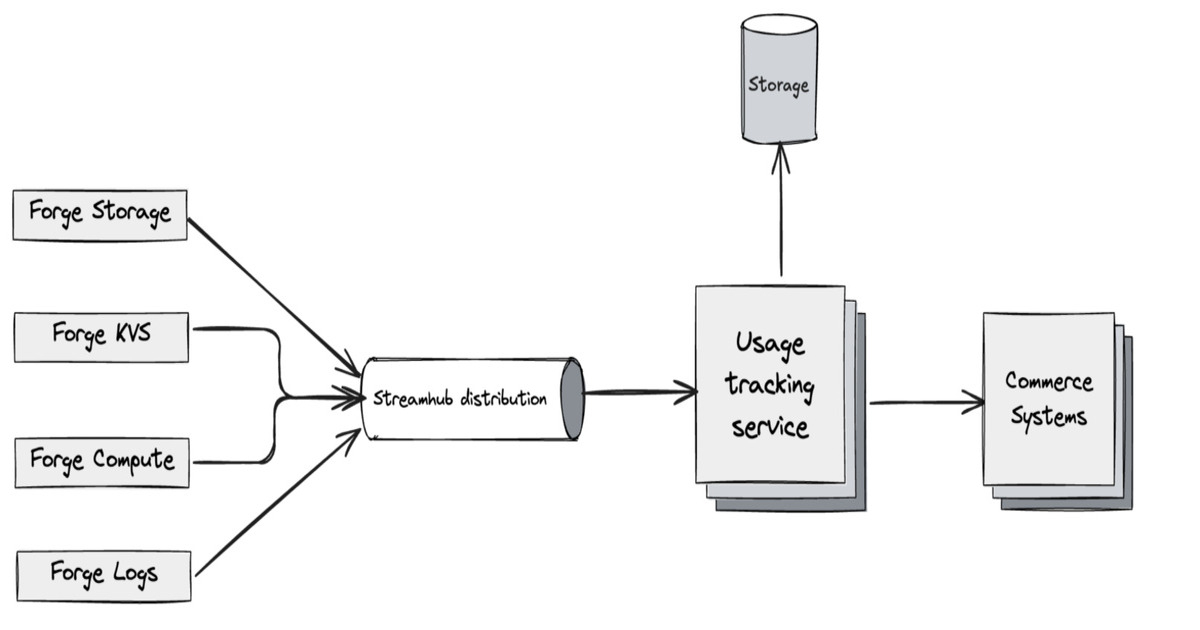
Atlassian 的 Forge 计费平台通过分布式使用追踪架构,实现了基于使用情况的定价模型,支持大规模扩展和实时可见性。
入选理由:Forge 使用 Kafka 构建的流基础设施实现事件的可靠传输。
LivePerson通过基准测试发现,GCP上的n4d-standard-2机器类型在Logstash和Kafka性能上表现最优,可将每千事件处理成本降低超过50%,显著优化了高吞吐量日志管道的基础设施。
入选理由:n4d-standard-2(AMD Milan架构)使Logstash吞吐量提升100%以上,每美元处理事件数达370个。
文章介绍了如何通过数学公式进行队列恢复容量规划,强调了理解队列深度、到达率和处理率之间的关系对于避免系统崩溃的重要性。
入选理由:系统在90%利用率时对突发流量更敏感。