What you give up swapping Jev AI for open source #JevAI
James Briggs168 字 (约 1 分钟)
85
Jev AI 的校准概率是其核心优势,而开源模型如 Glyna 2.5 缺乏这一特性,导致决策可靠性下降。
入选理由:Jev AI 提供 98% 置信度的校准概率,提升决策可靠性
精选视频#AI模型#校准概率#Jev AI#开源模型英文
产品
别名:Jev
提供校准概率的 AI 模型
已跟踪 12 条高相关材料
最近变化
2026-11-10 · Jev AI在guardrails场景性能优于LLM,可直接替代
为什么值得关注
Jev AI 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
What you give up swapping Jev AI for open source #JevAI
James Briggs · 8.5 分
Jev AI 的校准概率是其核心优势,而开源模型如 Glyna 2.5 缺乏这一特性,导致决策可靠性下降。
Why a local model beat Jev AI's API at Doom #JevAI
James Briggs · 8.5 分
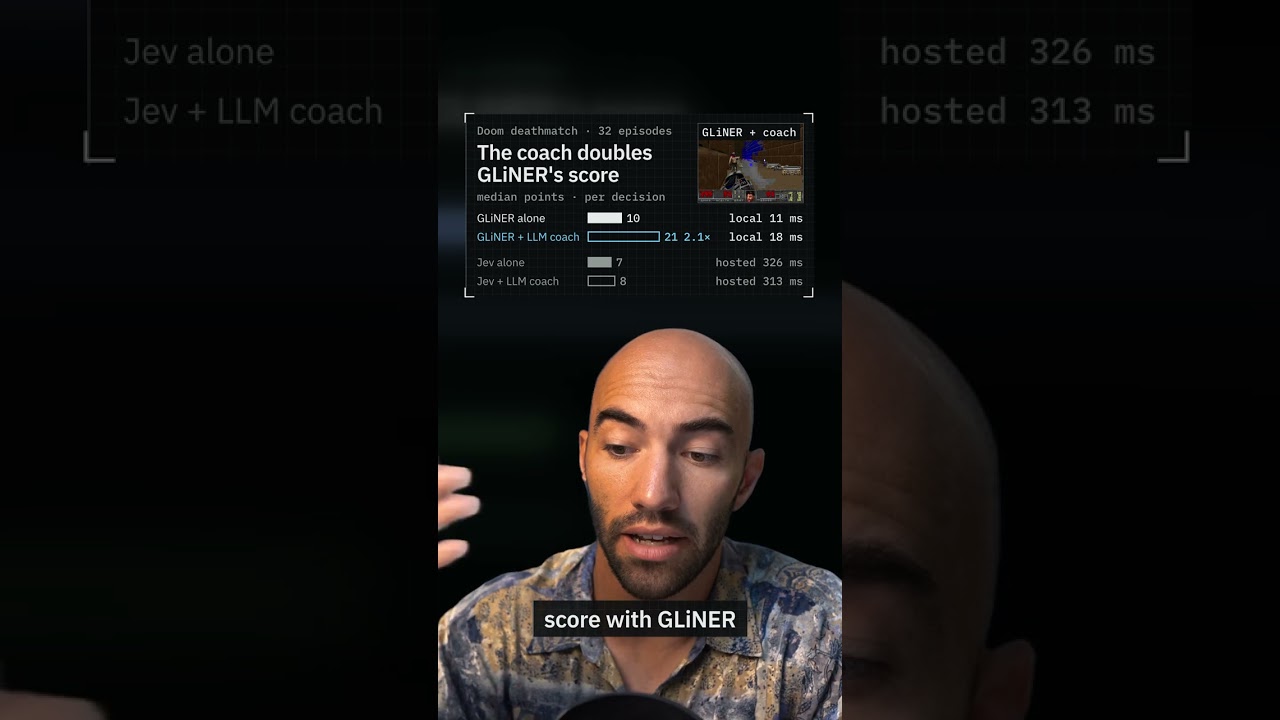
本地模型Glyna在Doom游戏中以12ms响应时间、8.8决策/秒的性能,使得分较Jev AI API方案提升超100%。
Why a local model beat Jev AI's API at Doom #JevAI
James Briggs · 8.5 分
本地模型Glyna在Doom游戏中表现优于Jev AI的API,响应时间快且得分提升显著。
已收录 12 条与 Jev AI 相关的内容,按评分排序。
Jev AI 的校准概率是其核心优势,而开源模型如 Glyna 2.5 缺乏这一特性,导致决策可靠性下降。
入选理由:Jev AI 提供 98% 置信度的校准概率,提升决策可靠性
本地模型Glyna在Doom游戏中以12ms响应时间、8.8决策/秒的性能,使得分较Jev AI API方案提升超100%。
入选理由:本地模型Glyna响应时间仅12ms,较Jev API快4倍以上
本地模型Glyna在Doom游戏中表现优于Jev AI的API,响应时间快且得分提升显著。
入选理由:Glyna本地模型响应时间仅12毫秒,是Jev API的4.8倍快
Jev AI在五个基准测试中表现优于或等于Luna,尤其在安全相关任务上显著领先。
入选理由:Jev AI在5/6基准测试中表现优于或等于Luna,仅在银行业务意图分类基准落后
Jev AI单次调用最多支持255个决策,状态长度限制为32k tokens,影响其在复杂任务中的应用。
入选理由:Jev AI单次调用最多支持255个并行决策
Jev AI存在决策数量和状态长度的硬性限制,影响其适用场景。
入选理由:单次调用最多支持255个并行决策
Jev AI在guardrails和tool selection场景表现突出,但需与LLM配合使用,适合特定工程场景优化。
入选理由:Jev AI在guardrails场景性能优于LLM,可直接替代
LLM在推理和计算资源利用上优于分类模型,但结合使用可发挥各自优势。视频对比了Jev等分类模型与LLM的差异,并提出混合使用策略。
入选理由:LLM能利用计算资源进行深度推理,但速度较慢
LLMs的置信度校准存在不足,Jeff模型在不确定时承认错误更具实用性。
入选理由:Luna模型输出的95%置信度可能未经过良好校准
74M参数的Glyna 2.5模型在Doom测试中击败Jev AI,且在部分安全指标表现更优。
入选理由:Glyna 2.5模型参数量为74-300百万,适合消费者设备运行
Jev AI是闭源的,其训练后处理使用RLCD,但信息有限。
入选理由:Jev AI采用闭源模式,限制了技术验证和社区参与。
该视频页面未提供实质技术内容,仅包含YouTube视频链接和播放器元素。
入选理由:视频内容缺失,无法获取技术细节