模型调度器:初创公司的真正优势
Jerry Liu(@jerryjliu0)213 字 (约 1 分钟)
90
Jerry Liu 认为,构建模型调度器比构建底层模型更具优势,特别是在成本-性能曲线上存在开放权重到闭合权重的健康谱时。这为初创公司提供了显著的竞争优势。
入选理由:构建模型调度器比构建底层模型更简单,初创公司可以利用这一优势获得竞争优势。
精选推文#AI#模型调度#成本优化#初创公司#技术架构中文
人物
别名:jerryjliu0
推文协作者
已跟踪 30 条高相关材料
最近变化
2026-11-17 · ParseBench-2将文档解析拆解为6个维度330个场景,错误权重由人类定义(如数字错误扣10+分)
为什么值得关注
Jerry Liu 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
This is actually one of the main advantages startups have over frontier labs, as long as there's a h...
Jerry Liu(@jerryjliu0) · 9 分
Jerry Liu 认为,初创公司比前沿实验室更具优势,尤其是在成本-性能曲线上存在开放权重到闭合权重的健康谱时。构建模型调度器本质上不同于构建底层模型,这为初创公司提供了显著的成本和延迟优势。
One of the hardest parts about building any benchmark that measures high-dimensional output is makin...
Jerry Liu(@jerryjliu0) · 8.5 分
构建高维输出基准需平衡粒度与人类偏好对齐,ParseBench-2和DPP通过细分维度和规则提升文档解析评估。
ParseBench-2 hit 30k monthly downloads in 3 days, and is #3 on @huggingface trending benchmarks! 📈 ...
Jerry Liu(@jerryjliu0) · 8.5 分
ParseBench-2 在发布三天内下载量达 3 万,成为 Hugging Face 热门基准榜第三,提供细粒度文档解析错误分类和与人工判断高度对齐的指标。
已收录 30 条与 Jerry Liu 相关的内容,按评分排序。
Jerry Liu 认为,构建模型调度器比构建底层模型更具优势,特别是在成本-性能曲线上存在开放权重到闭合权重的健康谱时。这为初创公司提供了显著的竞争优势。
入选理由:构建模型调度器比构建底层模型更简单,初创公司可以利用这一优势获得竞争优势。
构建高维输出基准需平衡粒度与人类偏好对齐,ParseBench-2和DPP通过细分维度和规则提升文档解析评估。
入选理由:ParseBench-2将文档解析拆解为6个维度330个场景,错误权重由人类定义(如数字错误扣10+分)
ParseBench-2 在发布三天内下载量达 3 万,成为 Hugging Face 热门基准榜第三,提供细粒度文档解析错误分类和与人工判断高度对齐的指标。
入选理由:ParseBench-2 提供细粒度的文档解析错误分类,便于精准评估模型性能。
解析复杂表格是文档解析中最困难的部分,ParseBench-2通过引入严重性策略,使错误评估更精准。
入选理由:ParseBench-2引入严重性策略,允许用户自定义错误权重,如金融场景中数字错误权重可设为25。
ParseBench-2 是一个全面的文档解析基准框架,允许用户根据自身需求定义解析偏好并自定义评估指标。
入选理由:ParseBench-2 允许用户根据使用场景定义解析偏好,而非依赖单一的基准指标。
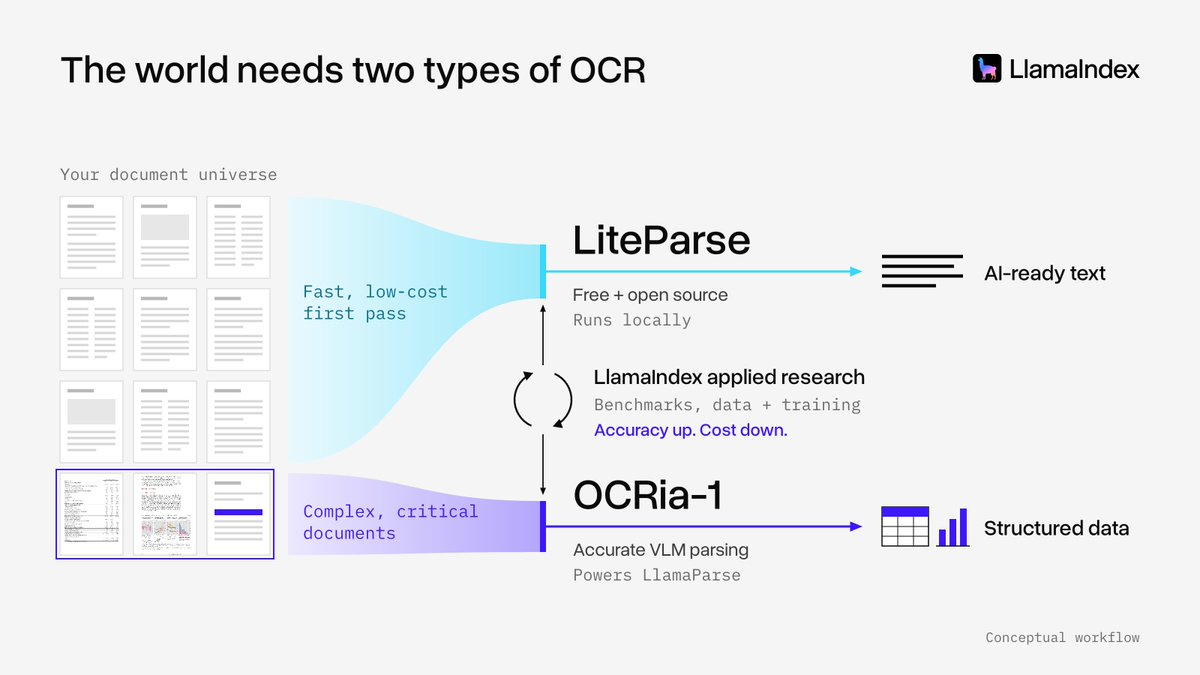
世界需要两种文档OCR:快速廉价的用于大规模预处理,高精度VLM-based OCR用于关键业务场景。LlamaParse推出OCRia-1模型,支持复杂文档解析。
入选理由:liteparse是最快的开源文档解析工具,集成5种OCR模型
每个任务都有其特定的准确性和成本的帕累托前沿,优化需结合具体任务需求。
入选理由:预加载上下文可减少70%的延迟和成本
ExtractBench Pro基准测试揭示当前AI在处理复杂文档时的显著短板,LlamaParse工具提供针对性解决方案。
入选理由:ExtractBench Pro是首个针对密集图表+文档推理的基准测试,暴露模型在复杂场景下的性能缺陷
LlamaParse的Agentic Plus模式可100%准确提取保险单54+字段,支持嵌套子限制和非覆盖内容审核。
入选理由:Agentic Plus模式可处理10-1000页文档的高精度字段提取
静态嵌入模型在速度和成本上优于密集嵌入,但存在长文本准确率下降问题,LlamaIndex通过MaxSim和适配器优化提升效果。
入选理由:静态嵌入比密集嵌入快10倍且成本降低70%
LlamaParse通过代理框架实现高精度表格提取,解决复杂Excel结构处理难题,支持任意行列数和非规范表格。
入选理由:LlamaParse新增表格提取功能,支持任意行列数和非规范表格结构
LlamaExtract Agentic Plus是首个在真实企业文档中实现高精度文档提取的模型,价格仅为Claude Code/Codex的25-50%。
入选理由:LlamaExtract Agentic Plus在ExtractBench基准测试中表现最优,支持复杂文档结构解析
文档OCR路由器通过智能路由实现多模式解析,显著提升复杂文档处理效率。
入选理由:使用LiteParse的is_complex参数可自动识别页面复杂度并路由解析模式
LlamaParse推出官方批量解析功能,支持一次处理10,000个文件,提升处理效率和代码可维护性。
入选理由:批量处理支持一次上传10,000个文件,减少API调用次数
Parse Gateway通过动态路由策略优化文档解析,根据页面复杂度选择不同解析模式,提升效率与成本控制。
入选理由:Parse Gateway根据页面复杂度动态选择cost-effective/agentic/agentic plus三种解析模式
构建高质量检索系统仍是2026年生产环境的核心挑战,需重点优化分块策略、混合搜索参数和权限管理,而非依赖革命性技术。
入选理由:生产级检索需精细调优分块策略与实时同步机制(如Slack线程拼接)
LlamaIndex推出2026年代理检索工具包,提供知识库自动索引和文件系统级检索功能,适用于法律和金融科技领域复杂任务处理。
入选理由:Retrieval Harness支持语义搜索、正则表达式匹配等文件系统操作级功能
LiteParse作为高效文件解析工具,显著提升代理循环中的处理效率与准确性。
入选理由:LiteParse在成本、准确性、速度和语义四方面优化文件解析流程
文档解析需兼顾准确率、成本和延迟,LlamaParse和LiteParse分别针对不同场景优化,适用于金融、保险等高要求领域及大规模处理需求。
入选理由:高精度解析要求99%+准确率,适用于金融和保险等监管行业
Markdown 正在成为新的编程语言,通过简单文件结构实现任务和技能的组织,极大降低了编程门槛。
入选理由:Markdown 文件可以作为任务和技能的容器,简化编程流程。
Agentic search现在采用灵活的代理框架,结合关键词和语义搜索工具,提升搜索效率。
入选理由:LlamaParse 提供 BM25、grep 正则表达式和语义搜索工具。
LiteParse v2 通过网格投影算法将复杂页面结构化为人类可读、代理可理解的文本,无需 LLM,性能超越 pymupdf 等开源工具。
入选理由:LiteParse v2 采用网格投影算法,不依赖 LLM,实现无模型 PDF 解析。
当前研究提出,grep 可能并非代理搜索的唯一工具。最新论文探讨了代理框架如何重塑搜索能力。
入选理由:最新论文探讨代理框架对搜索能力的影响
PDF文档解析是AI知识工作自动化的关键瓶颈,现有OCR和视觉语言模型在处理复杂布局和表格时仍存在严重不足,需专用工具链提升数据提取质量。
入选理由:当前主流OCR和VLM对PDF中的复杂排版与表格支持差,导致AI代理输入质量低下。
PDF解析仍属开放难题,因其本质是面向打印/显示的格式,缺乏语义结构与文本顺序保证,而AI Agent对高质量OCR和结构化提取的需求正急剧提升。
入选理由:PDF设计初衷非为机器可读,文本与表格以无序字符/线条堆叠方式存储
Jerry Liu提出文件系统正成为AI代理与文档交互的新默认抽象层,是2026年RAG架构演进方向;关键挑战在于产品化——需超越本地文件系统,融合Git式版本控制与语义能力。
入选理由:文件系统正取代传统RAG接口,成为AI代理操作文档的核心抽象
Jerry Liu指出2023年AI基建(如LlamaIndex)聚焦于底层工具建设,而当前重心已转向稳固的智能体抽象与编码能力;真正持久的护城河在于构建支持智能体行动的上下文层,尤其是复杂文档解析与结构化。
入选理由:2023年AI工作重心是打造‘铲子和镐’式基础设施,LlamaIndex早期即为此定位。
LlamaIndex CEO指出LLM栈的核心变革在于数据层:企业关键上下文仍锁在PDF、合同等文件中,框架抽象已成负担,真正护城河是高效提取与供给高质量上下文的能力。
入选理由:LLM应用成败取决于上下文质量,而非底层模型选择
ExtractBench是首个全面的复杂企业文档信息提取基准,揭示当前模型在生产环境中的局限性。
入选理由:ExtractBench包含36页详尽白皮书,覆盖真实场景文档提取评估
构建AI代理的文档上下文层需依赖OCR、提取工具及标准化格式,是解锁非结构化文档知识的关键。
入选理由:文档OCR仍是当前解锁上下文的核心难题,需持续优化