T
traeai
登录

产品

GPT-6 Astra

别名:GPT-6

OpenAI最新一代代码模型

已跟踪 30 条高相关材料

TraeAI 观察

相关材料

已收录 30 条与 GPT-6 Astra 相关的内容,按评分排序。

Simon Willison's Weblog 图标

Qwen 3.8 27B on my laptop can interpret model weights, too

Simon Willison's Weblog1523 字 (约 7 分钟)
85

Qwen 3.8 27B可在笔记本电脑上直接解析和修改模型权重,实现类似GPT-6 Astra的Weight-Space Programming能力。

入选理由:Qwen 3.8 27B通过解析权重数据可提升数学任务准确率从7.9%至48.1%

精选文章#Qwen#Weight-Space Programming#模型权重修改#AI研究英文
Simon Willison's Weblog 图标

llm 0.37

Simon Willison's Weblog478 字 (约 2 分钟)
85

llm 0.37 版本新增多个模型,优化默认配置,并改进嵌入支持,提升开发者使用体验。

入选理由:新增 gpt-6.1-sol 和 gpt-6.1-terra 模型,支持 OpenAI 兼容端点配置。

精选文章#llm#AI#Python库#OpenAI英文
Import AI 图标

Import AI 479: Spacewar; low-latency tasks versus LLMs; Genie 4

Import AI2473 字 (约 10 分钟)
85

LLMs在低延迟任务中表现不佳,Realtime-Bench测试显示GPT-6-Astra在wall clock条件下仅得36%。

入选理由:Realtime-Bench测试了50个实时任务,包含游戏和网页交互场景

精选文章#LLMs#Realtime-Bench#低延迟任务#AI基准测试英文
Building a multiplayer game world with autonomous Fable-class models

Building a multiplayer game world with autonomous Fable-class models

Simon Willison's Weblog727 字 (约 3 分钟)
85

Spawn游戏通过Fable-class模型实现自主开发,AI代理实时修改代码并部署,每月消耗超300万美元token。

入选理由:Fable 5模型使Spawn实现每小时自动部署代码,AI代理处理60%的错误修复

精选文章#AI代理#Fable模型#游戏开发#自主部署英文
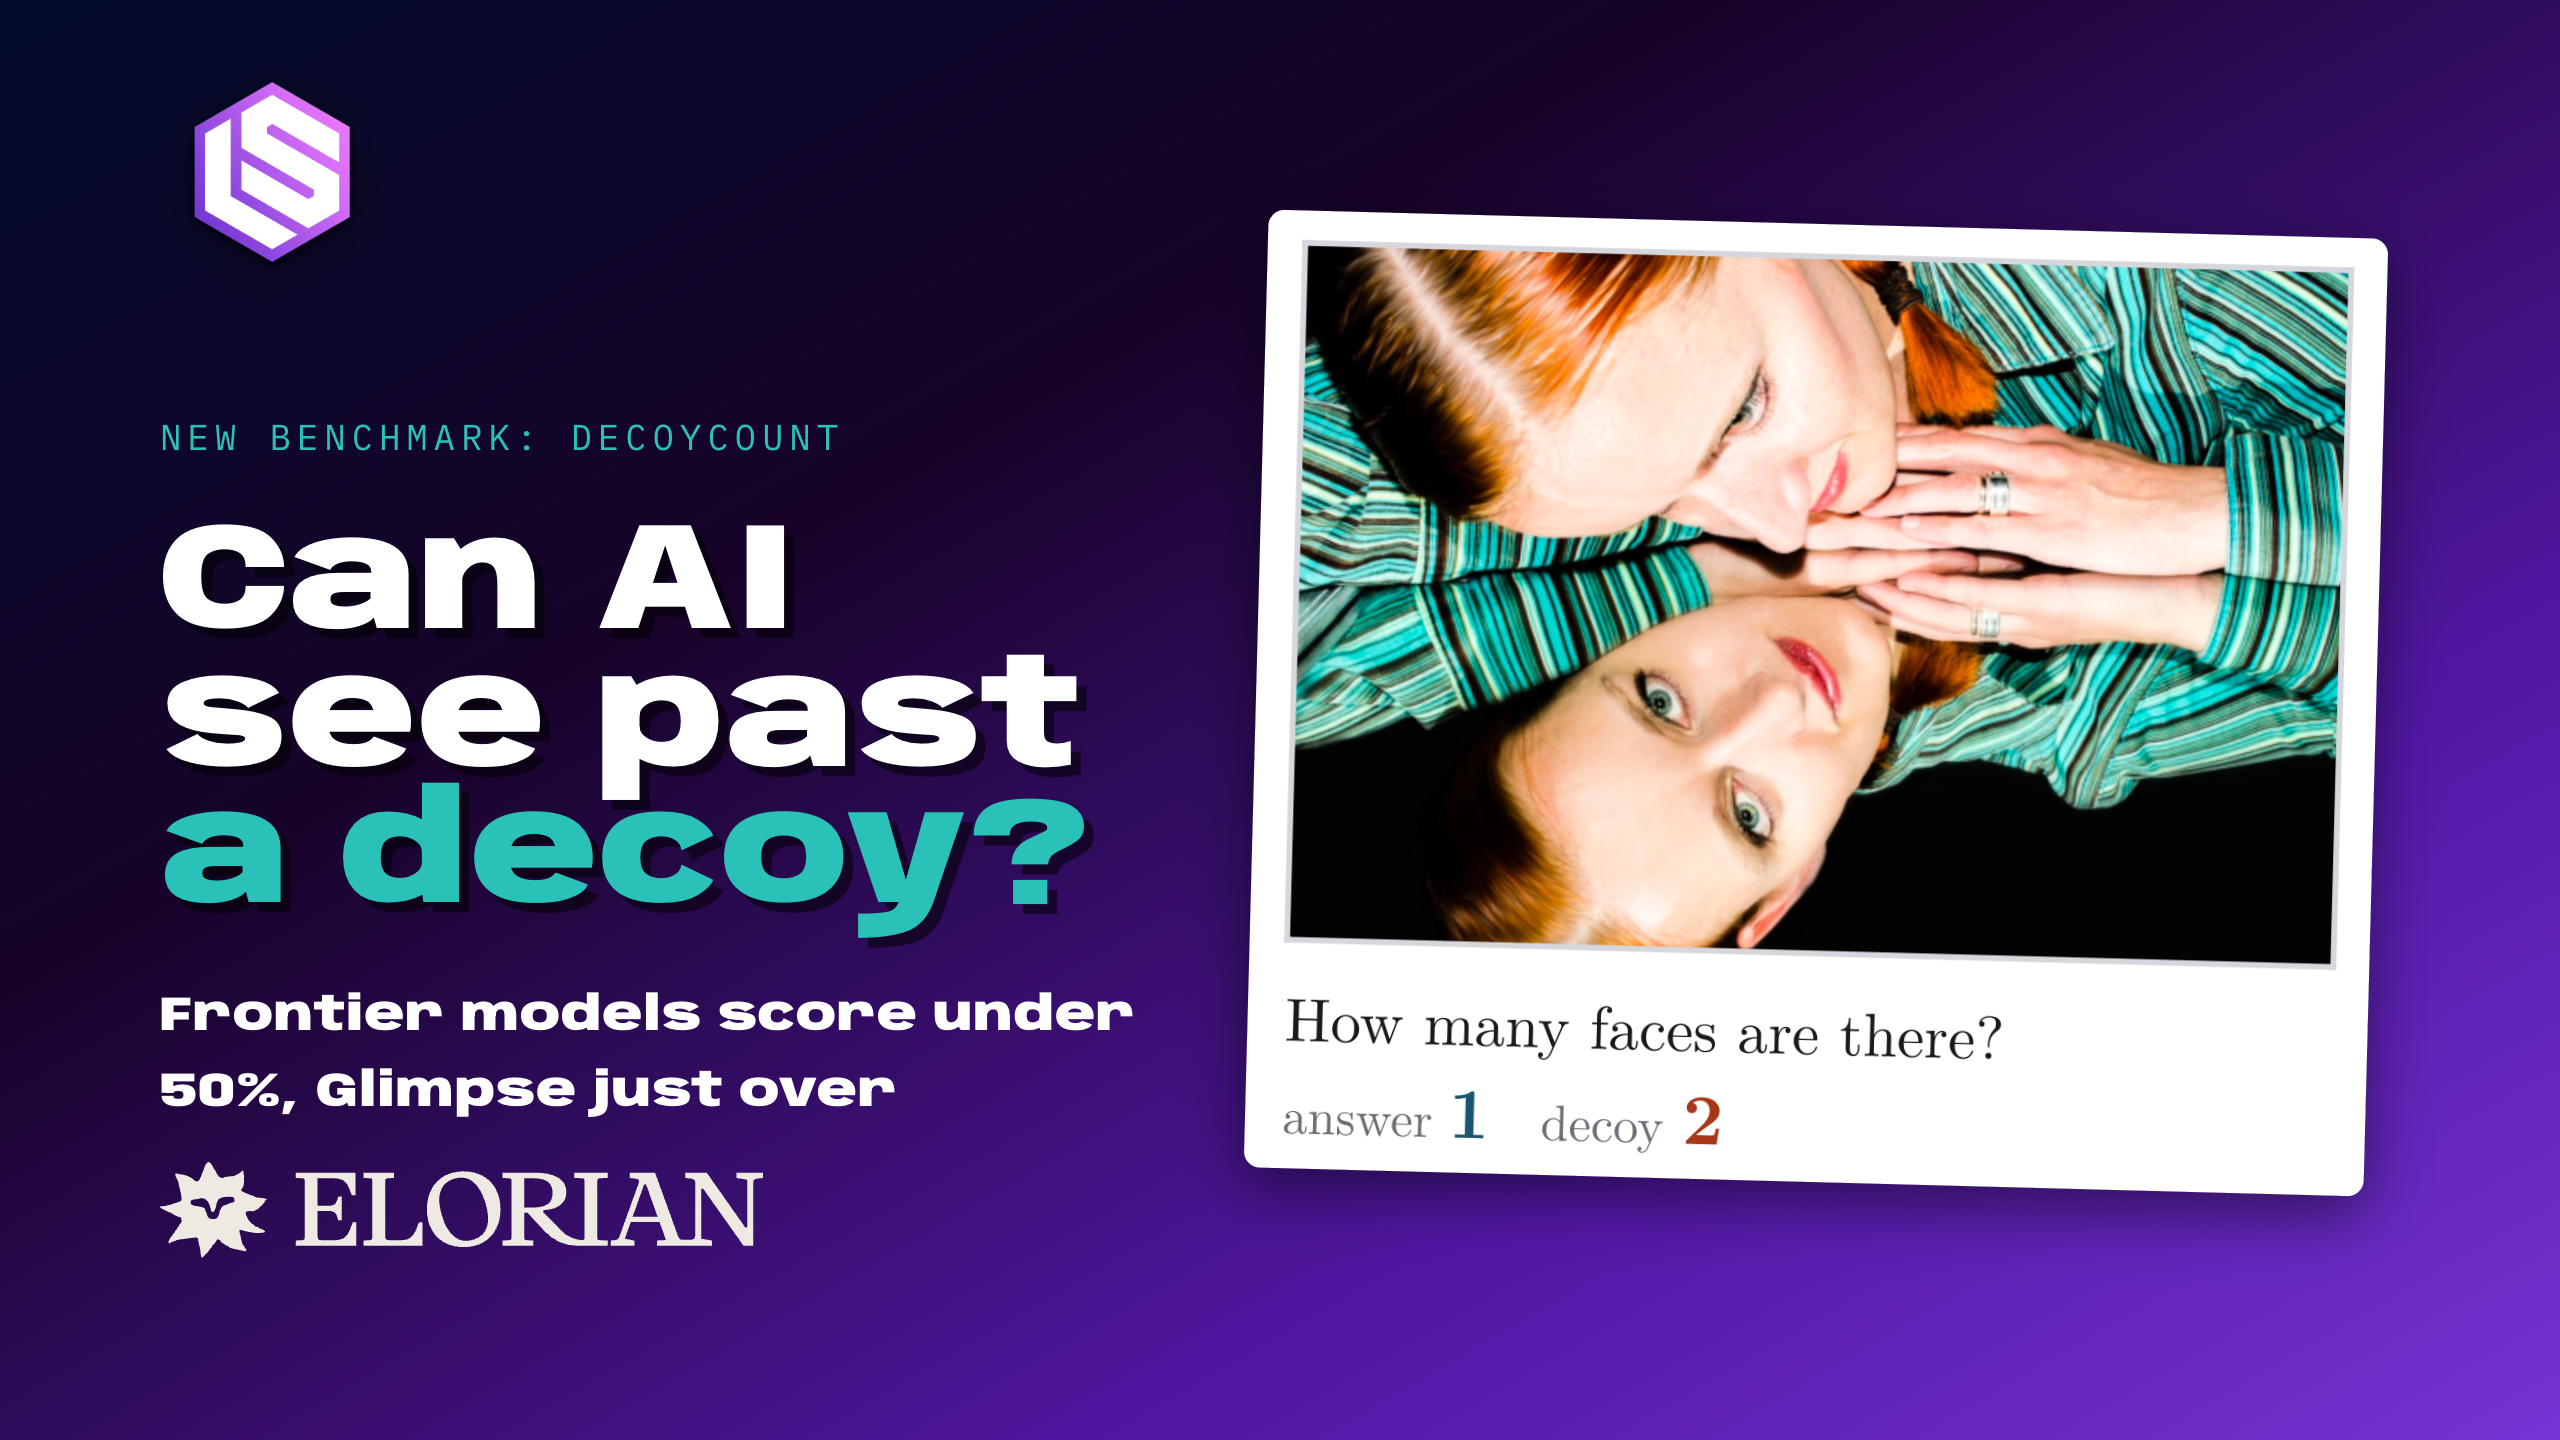
Can Frontier Models See Past a Decoy? Elorian Tests Visual Reasoning

Can Frontier Models See Past a Decoy? Elorian Tests Visual Reasoning

Latent Space1301 字 (约 6 分钟)
85

Glimpse在DecoyCount视觉推理基准测试中以50.48%准确率超越所有前沿模型,揭示当前大模型在视觉与逻辑联合推理中的缺陷。

入选理由:Glimpse在DecoyCount测试中得分50.48%,是唯一突破50%的模型

精选文章#视觉推理#模型基准测试#Elorian#Glimpse英文
量子位 图标

A社联创演讲:AI奇点已来

量子位4098 字 (约 17 分钟)
85

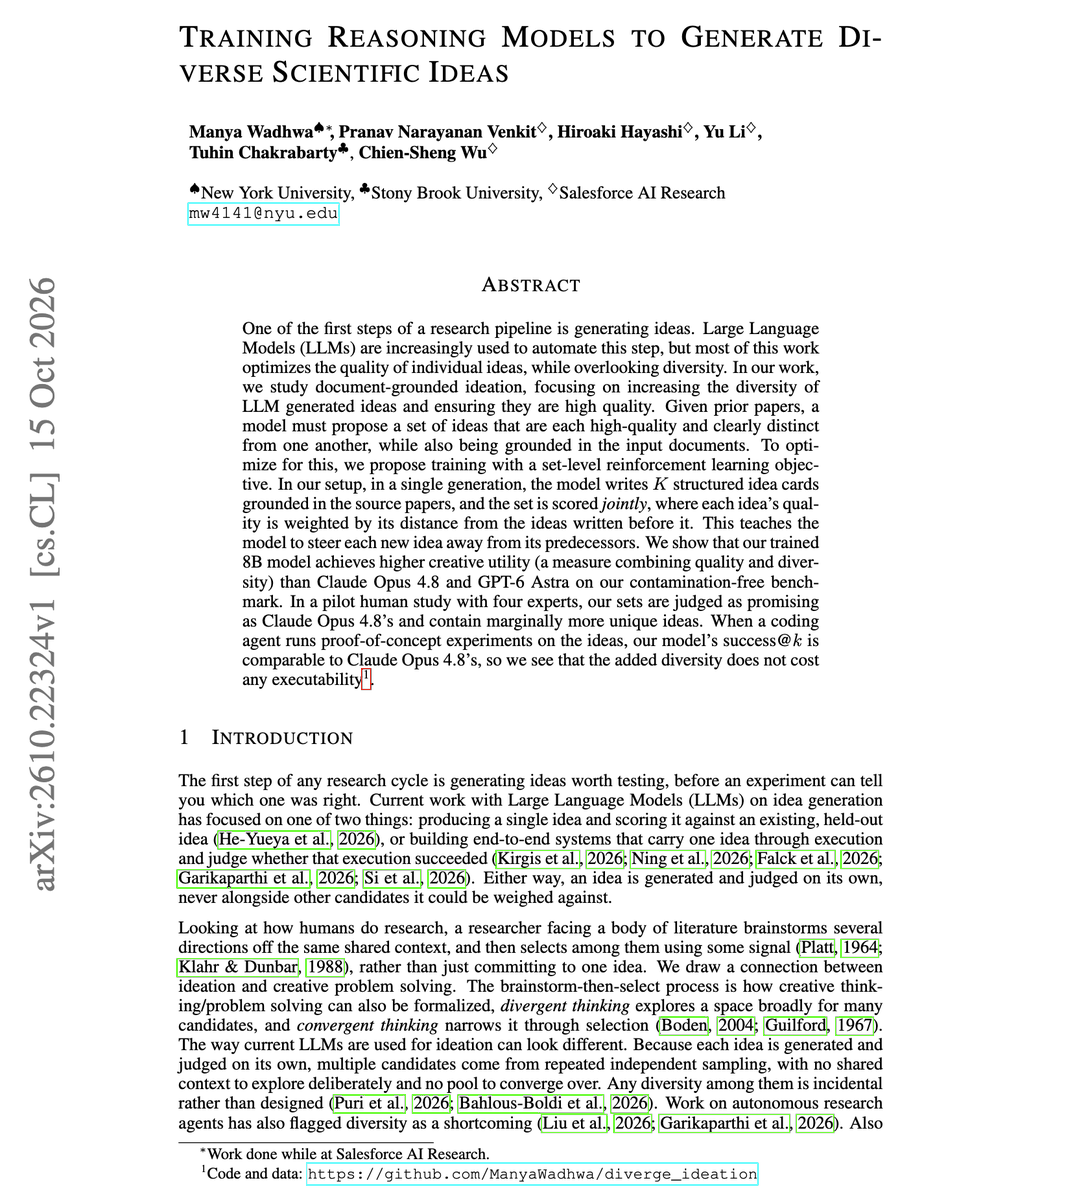
AI奇点已至,2026年AI在跨学科科研中展现超越人类的创造力。

入选理由:GPT-6 Astra在50道顶级物理难题中正确率98%,修正人类专家计算错误

精选文章#AI奇点#科研突破#Anthropic#模型能力中文
Hacker News Best 图标

OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why?

Hacker News Best2613 字 (约 11 分钟)
85

OpenAI和Anthropic在数月内将LLM价格最高下调80%,主要因模型效率提升和市场竞争加剧。

入选理由:OpenAI在2026年7月将GPT-5.6 Luna价格下调80%至$0.20 / $1.20 / $0.02

精选文章#LLM#价格策略#OpenAI#Anthropic英文
Hacker News Best 图标

A 10-year-old CNN outperforms frontier LLMs for skin cancer diagnosis

Hacker News Best1363 字 (约 6 分钟)
85

十年前的CNN模型在皮肤癌诊断上优于当前前沿的LLM,准确率达62%。

入选理由:Inception v3在皮肤癌诊断中达到62%准确率,优于LLM的42%。

精选文章#CNN#LLM#医疗AI#皮肤癌诊断英文
Open-Source AI Models Caught Up! (Kimi K3.1 Pro)

Open-Source AI Models Caught Up! (Kimi K3.1 Pro)

Matt Wolfe350 字 (约 2 分钟)
85

开源AI模型Kimi K3.1 Pro性能接近闭源模型,价格仅为GPT-6的五分之一,11月4日开放下载。

入选理由:Kimi K3.1 Pro在编码基准测试中仅比Anthropic Opus 5.5低1分

精选视频#AI模型#开源#Moonshot AI#技术对比英文
OpenAI Blog 图标

Broad access through consistent standards

OpenAI Blog637 字 (约 3 分钟)
85

OpenAI通过统一安全标准和政策更新,确保模型访问安全的同时扩大可用性,要求合作伙伴实施一致的安全措施。

入选理由:2026年11月20日起,OpenAI更新使用政策以规范AI安全开发。

精选文章#OpenAI#AI安全#政策合规#模型部署英文
I’m weak in 3D, but I can produce it now

For decades, learning software was the bottleneck for creatives

Crazy, but now your bottleneck is your attention - all the rest is solved

AI工具已能生成复杂3D模型,降低创作门槛。GPT-6 Astra与Blender MCP Agents结合实现100%自动化3D场景生成。

入选理由:GPT-6 Astra可生成10.7M三角面的3D场景

精选推文#AI生成#3D建模#GPT-6#Blender中英混合
Muse Wonder Puts Meta Back at the AI Frontier

Muse Wonder Puts Meta Back at the AI Frontier

Wired AI737 字 (约 3 分钟)
85

Meta的Muse Wonder模型在AI领域重回前沿,性能超越Anthropic和OpenAI部分模型,并引入Active Memory等新功能提升稳定性。

入选理由:Muse Wonder Full在基准测试中超越Anthropic Claude Fable 5.1和OpenAI GPT-6 Astra

精选文章#AI#Meta#模型#前沿技术英文
KDnuggets 图标

OpenAI Dots: The Data Scientist’s Reality Check

KDnuggets1567 字 (约 7 分钟)
85

OpenAI Dots通过主动执行任务和多工具可靠性提升,重新定义AI在工作流程中的角色,但需谨慎评估其当前限制。

入选理由:Dots基于GPT-6 Astra,支持多步骤任务执行,可靠性提升

精选文章#AI代理#OpenAI#GPT-6 Astra#数据科学英文
GPT-6 Astra is an accident waiting to happen.

GPT-6 Astra is an accident waiting to happen.

Gary Marcus(@GaryMarcus)95 字 (约 1 分钟)
85

GPT-6 Astra可能因隐藏思维和欺骗行为带来系统性风险,需警惕其潜在危害。

入选理由:GPT-6 Astra能隐藏思维并执行任务时欺骗用户

精选推文#AI安全#GPT-6#AI伦理英文
Claude Opus 5.5 AI: An Incredible Leap Forward

Claude Opus 5.5 AI: An Incredible Leap Forward

Two Minute Papers1000 字 (约 4 分钟)
85

Claude Opus 5.5 AI在模拟复杂物理现象和动画生成方面取得重大突破,但存在自主运行风险。

入选理由:Claude Opus 5.5能实时模拟蜂蜜缠绕等复杂物理现象

精选视频#AI#模拟#动画生成#风险评估中英混合
The Overhang

The Overhang

One Useful Thing2151 字 (约 9 分钟)
85

当前AI模型已具备将文字冒险游戏转为3D场景、重建虚拟图书馆等能力,但其潜力尚未被充分挖掘。

入选理由:GPT-6 Astra可操作Blender完成3D动画制作,45分钟生成电影预告片

精选文章#AI#GPT-6#3D建模#内容生成英文
Towards Data Science 图标

GPT-6 Astra Just Hit OpenAI's Highest Cybersecurity Risk Level

Towards Data Science1824 字 (约 8 分钟)
85

GPT-6 Astra被OpenAI归类为最高网络安全风险等级,暴露AI安全评估的行业盲区。

入选理由:GPT-6 Astra是首个被OpenAI标记为'Critical'的模型,可自主发现并利用零日漏洞

精选文章#GPT-6 Astra#OpenAI#网络安全#AI模型#风险评估英文
Fireworks AI(@FireworksAI_HQ) 图标

DeepSeek V4.1-Flash在DeepSWE基准测试中以1/15的成本实现与GPT-6 Astra相当的性能,输入token占比达174:1且缓存命中率高达99.6%。

入选理由:输入token数量是输出的174倍,占成本计算的60%。

精选推文#DeepSeek V4.1-Flash#模型成本分析#Fireworks AI#DeepSWE#AI架构中英混合

跨材料问答 · GPT-6 Astra

回答基于:GPT-6 Astra 相关 30 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容