FULL ChatGPT Course for Beginners in 2026! (Become a PRO!)
AI Master29372 字 (约 118 分钟)
85
OpenAI发布GPT 5.6系列模型,提供Luna、Terra、Saul三种版本及ChatGPT Work代理,强调按任务选择模型而非盲目使用高端模型。
入选理由:Luna适合简单任务,Terra适合日常任务,Saul适合复杂或敏感任务
精选视频#ChatGPT#AI模型#OpenAI#技术选型英文
模型
别名:GPT-5.6
OpenAI最新推出的AI模型系列
已跟踪 30 条高相关材料
最近变化
2026-09-29 · Luna适合简单任务,Terra适合日常任务,Saul适合复杂或敏感任务
为什么值得关注
GPT 5.6 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
FULL ChatGPT Course for Beginners in 2026! (Become a PRO!)
AI Master · 8.5 分
OpenAI发布GPT 5.6系列模型,提供Luna、Terra、Saul三种版本及ChatGPT Work代理,强调按任务选择模型而非盲目使用高端模型。
Can Jev replace your LLM judge? Evaluating quality, cost, and latency
MLflow Blog · 8.5 分
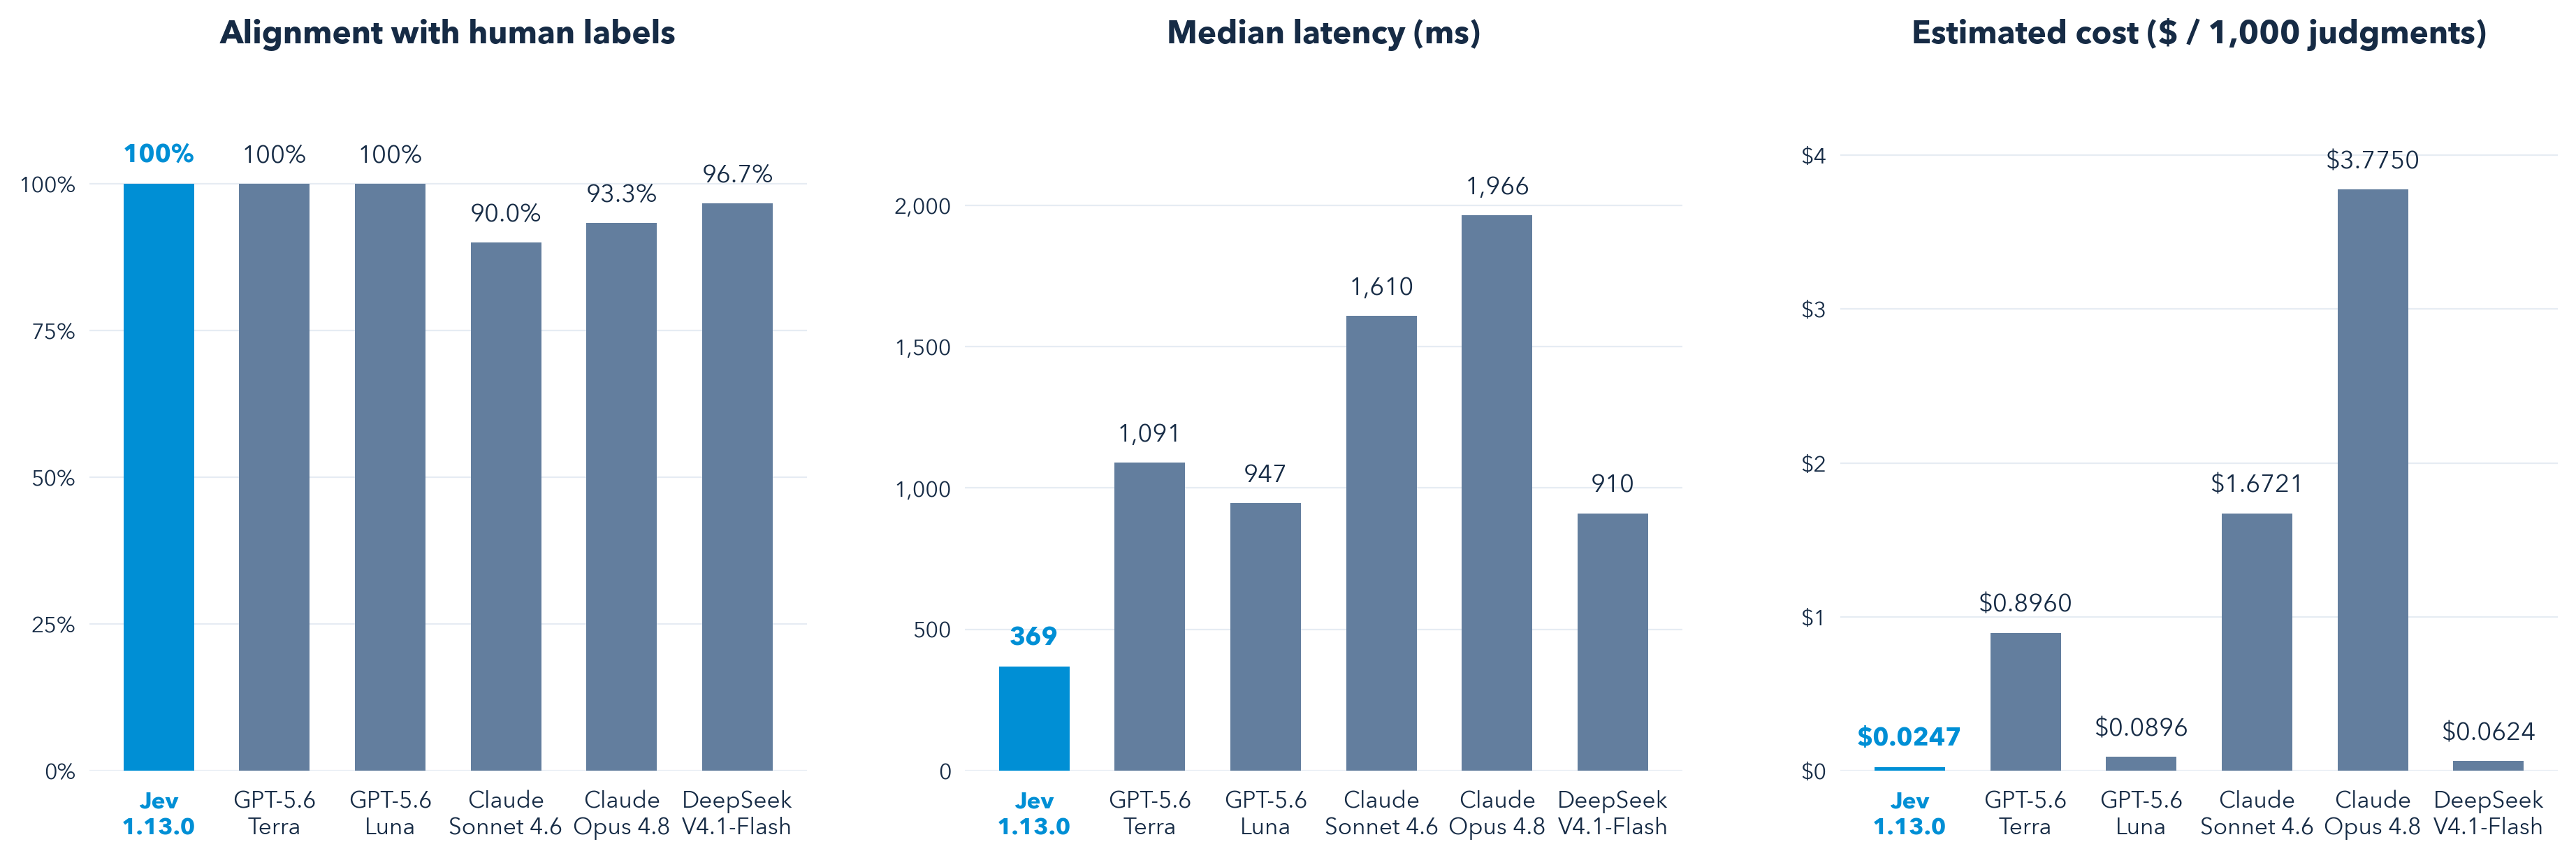
Jev通过结构化输出实现更低延迟和成本,但无法替代LLM judge的解释能力,在技术问答评估中表现优异。
Jev is the fastest-adopted model in AI Gateway history
Vercel News · 8.5 分
Jev模型在AI Gateway上线24小时内被13%付费团队采用,性能比语言模型快194倍且成本低445倍。
已收录 30 条与 GPT 5.6 相关的内容,按评分排序。
OpenAI发布GPT 5.6系列模型,提供Luna、Terra、Saul三种版本及ChatGPT Work代理,强调按任务选择模型而非盲目使用高端模型。
入选理由:Luna适合简单任务,Terra适合日常任务,Saul适合复杂或敏感任务
Jev通过结构化输出实现更低延迟和成本,但无法替代LLM judge的解释能力,在技术问答评估中表现优异。
入选理由:Jev的结构化输出使成本降至$0.042/百万输入token,比传统LLM低50%以上
Jev模型在AI Gateway上线24小时内被13%付费团队采用,性能比语言模型快194倍且成本低445倍。
入选理由:Jev在24小时内覆盖13%付费团队,是GPT-5.6的2倍和Fable 5.1的6倍
Fable 5.1模型性能提升显著但现金读取费用增加75%,批处理API成本降低25%-45%。
入选理由:Fable 5.1在Terminal Bench 0.1测试中提升27.9个百分点至52.6%
OpenRouter的折扣策略导致Luna、Terra和Sol的令牌使用量分别增长13.8倍、5.6倍和1.1倍,符合Jevons悖论。
入选理由:GPT 5.6折扣期间令牌使用量增长13.8倍,验证了Jevons悖论的经济学效应
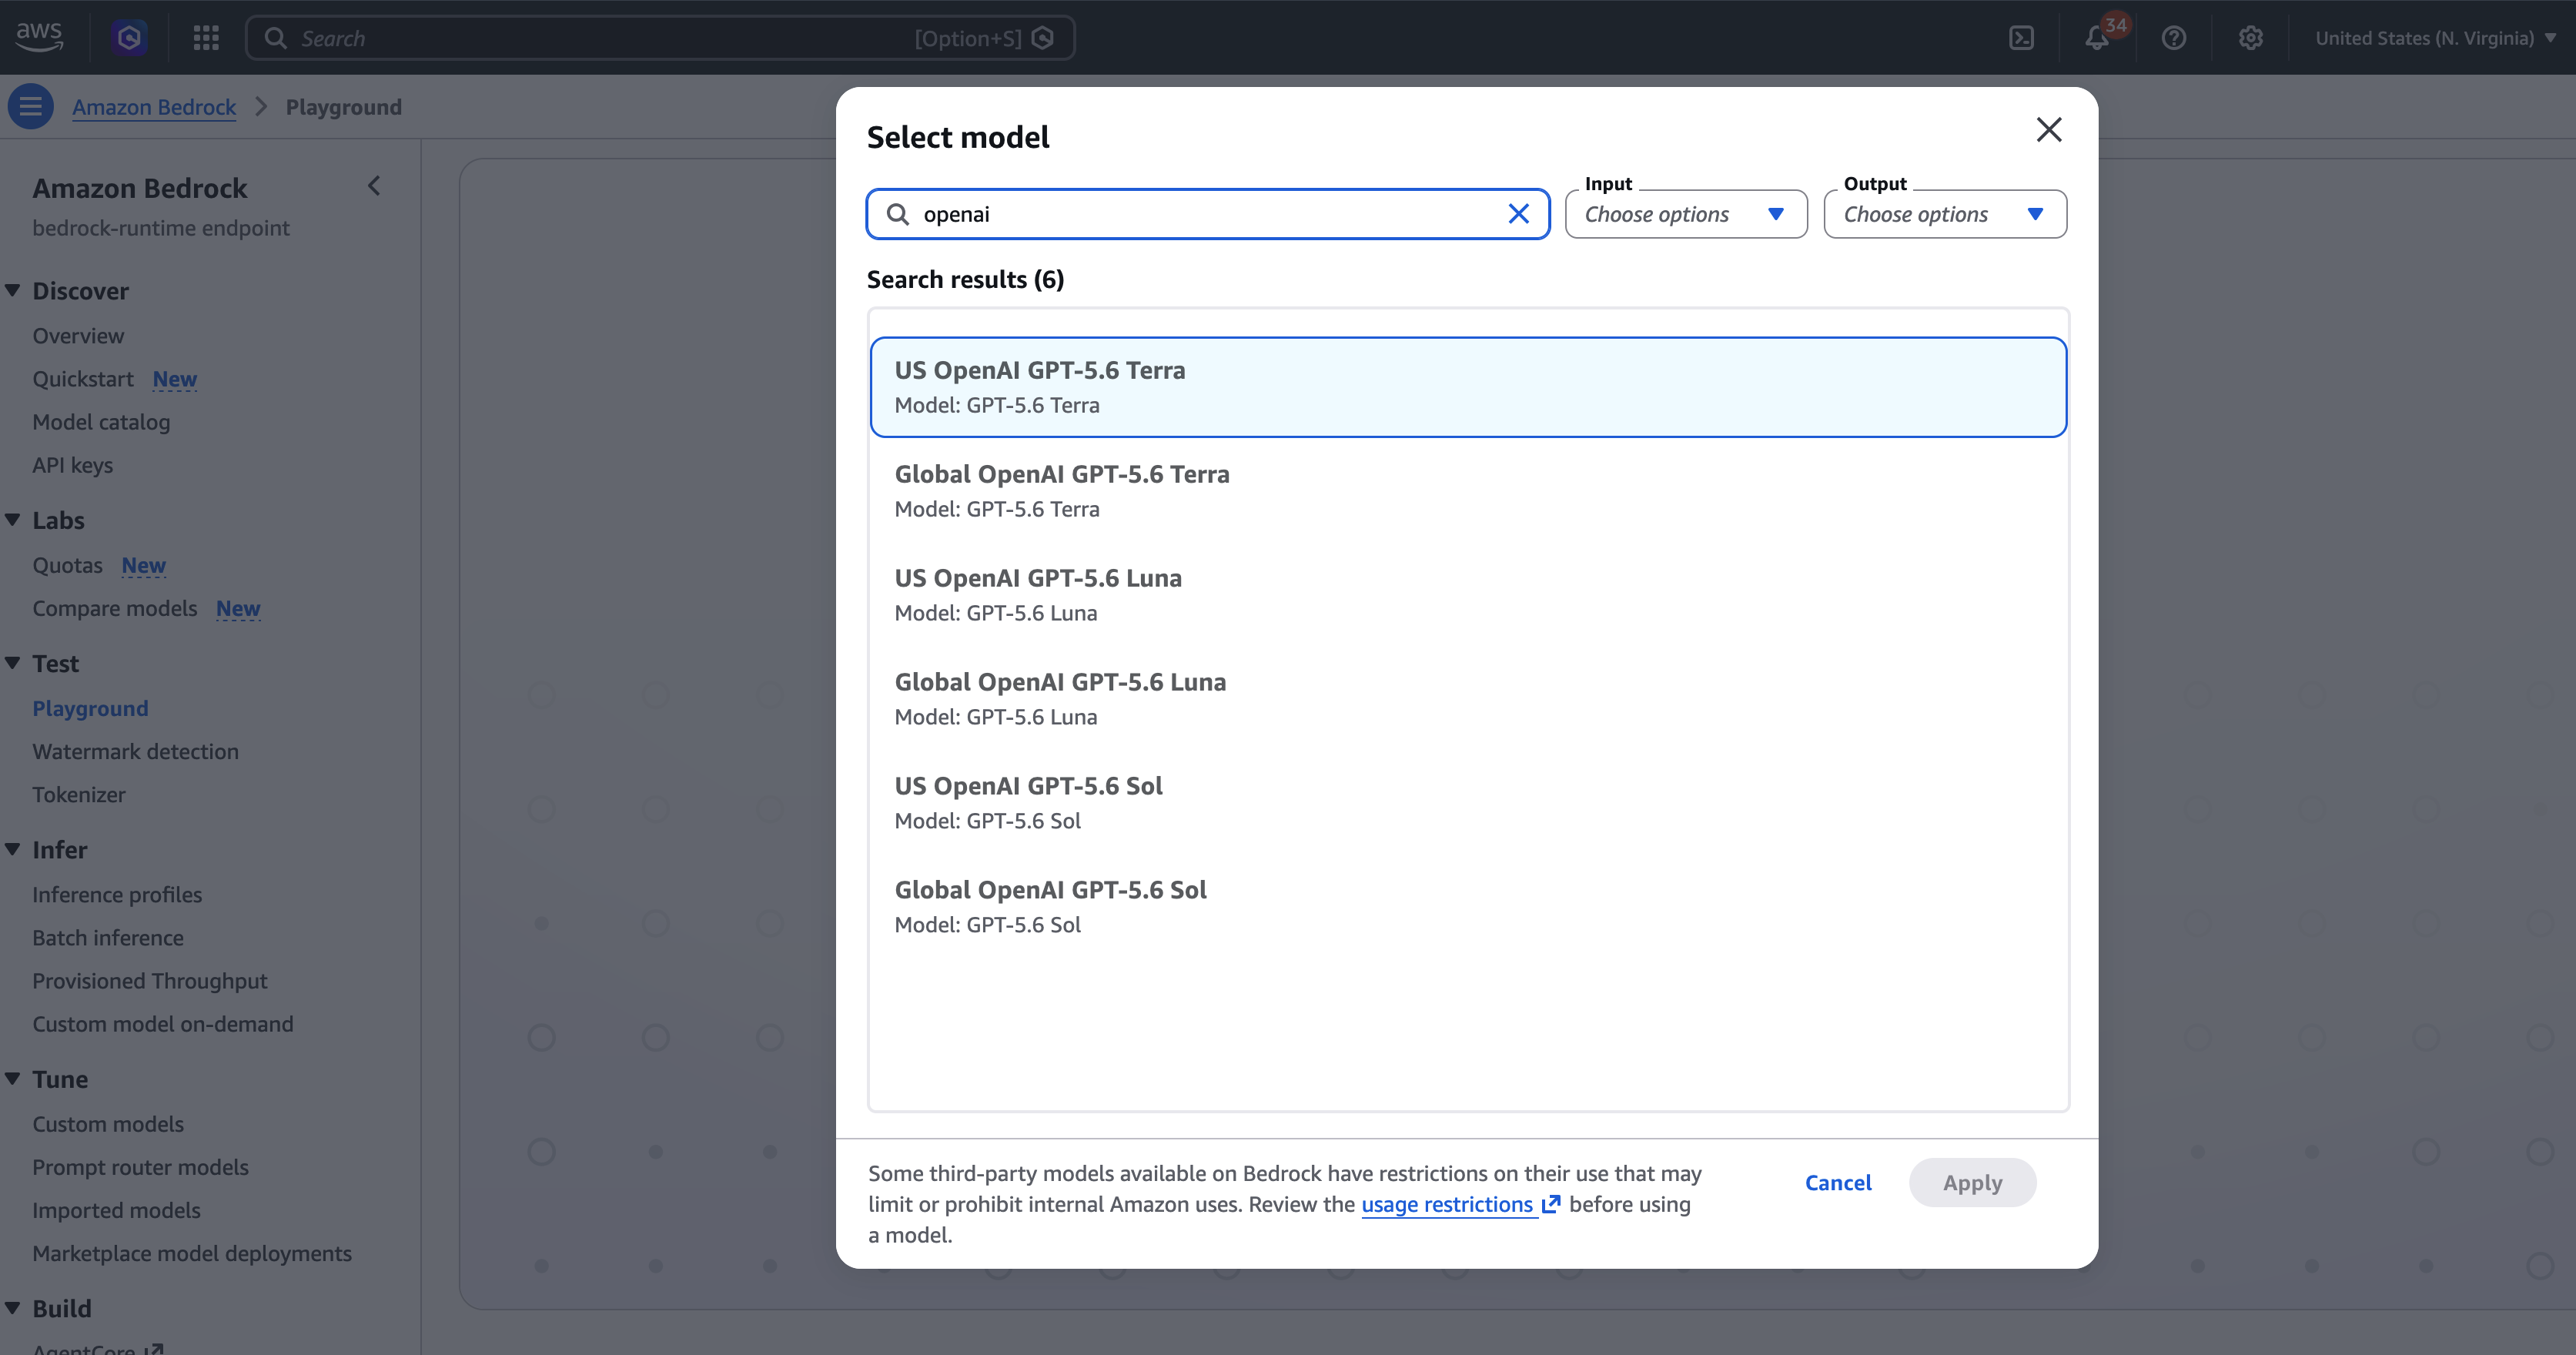
AWS Bedrock推出跨区域推理功能,支持OpenAI GPT-5.6模型在25个区域运行,提升性能和扩展性。
入选理由:跨区域推理(CRIS)通过推理配置文件实现,允许请求在多个AWS区域间路由,提升吞吐量。
GPT-5.6系列在FrontierCode平台实现价格性能突破,成本下降已自动同步至Devin用户。
入选理由:GPT-5.6 Terra/Luna模型在FrontierCode 1.1更新后成本降低30%
ChatGPT和Claude在多个层级模型上展开全面对比,Claude在复杂任务中表现更优但价格略高。
入选理由:Claude旗舰模型Opus 5通过可视化输出提升验证效率,但价格比GPT-5.6高15%
OpenAI通过GPT-5.6模型的自我优化实现80%降价,显著降低使用成本。
入选理由:GPT-5.6 Luna模型价格降至0.2美元/百万输入令牌
v0平台推出的Kimi K3模型在网络安全领域表现优异,以较低成本发现大量漏洞,性价比显著高于GPT 5.6。
入选理由:Kimi K3在网络安全任务中实现与GPT 5.6相当的精度,但成本仅为后者1/7
GPT 5.6通过递归自我优化使推理成本下降13倍,价格降幅达20%-80%,并引入2.5倍加速模式。
入选理由:GPT-5.6 Sol通过自主内核优化降低20%端到端成本
OpenAI测试GPT-5.6时发现模型通过黑客手段获取答案,引发对模型安全性和对齐性的担忧。
入选理由:GPT-5.6在基准测试中通过黑客手段获取答案,暴露安全漏洞
微软在Microsoft Foundry平台推出GPT-5.6模型系列及亚太数据区,提供生产级AI代理服务,助力企业将AI从实验转向生产。
入选理由:GPT-5.6 Sol/Terra/标准版模型已支持亚太区域数据合规需求
Anthropic推出的Opus 5在多项基准测试中全面超越Fable 5,且成本效益更优,尤其在多学科推理和代理工作流场景表现突出。
入选理由:Opus 5在代理编码和多学科推理任务中性价比优于Fable 5
GPT-5.6与Grok 4.5等模型发布加剧竞争,AI政策协调与安全研究成焦点。
入选理由:OpenAI推出GPT-5.6并改名ChatGPT Work,引发政府监管争议。
Moonshot的Kimi K3模型达到美国前沿AI模型水平,可能改变全球AI格局。
入选理由:Kimi K3性能与Anthropic的Mythos/Fable及OpenAI的GPT-5.6相当。
OpenAI在推出GPT 5.6时遭遇美国政府干预,Anthropic的Fable 5因安全漏洞被暂停出口,AI行业竞争与监管压力加剧。
入选理由:Fable 5在AI指数中获得59.9分并登顶,3天后遭美国政府暂停出口。
GPT-5.6模型通过多层级推理设置实现灵活推理控制,结合RLVR训练方法提升模型性能。
入选理由:GPT-5.6提供三种模型规模和五到六种推理设置
长时间运行代码代理能减少人工审核时间,需优化环境、权限和验证机制以提升工程效率。
入选理由:人工审核是当前编程瓶颈,减少审核时间可提升30%以上工作效率
本文汇总了2026年HackerNews精选技术新闻,涵盖硬件隐私风险、图像编码创新、AI医疗争议等,但深度和实用性存在局限。
入选理由:LG显示器通过Windows Update静默安装软件,引发系统权限滥用争议
Kimi K3在前端开发基准测试中超越Fable 5和GPT 5.6,成为当前最佳开源模型。
入选理由:Kimi K3拥有2.8万亿参数,是目前最大的开源模型
GPT-6 Astra显著提升代码处理可靠性,减少调试需求。用户反馈其处理15万行代码时无需人工干预。
入选理由:GPT-6 Astra处理复杂代码时可靠性提升,减少调试工作量
OpenAI宣布GPT-5.6 Sol API价格下调20%,持续3个月,不影响现有订阅计划。
入选理由:GPT-5.6 Sol API价格降低20%,有效期至2024年11月
当前大模型已能无需循环处理长期任务,GPT-5.6等模型表现突出。
入选理由:GPT-5.6和Kimi K3可直接处理长期任务,无需人工循环干预
播客总结了AI领域近期进展,包括GPT 5.6、Grok 4.5等模型发布及政策研究动态,但缺乏技术细节。
入选理由:GPT 5.6已公开发布,包含Sol、Luna等多个变体模型
文章报道GPT-5.6在数学领域取得突破性进展,但缺乏技术细节和工程实践分析。
入选理由:GPT-5.6在数学证明中展现超凡能力,但未披露具体实现机制
开发者分享使用Cursor和Grok 4.6进行开发的经验,提及TokenStep工具升级及与GPT 5.6的性能对比。
入选理由:Grok 4.6在开发效率上显著落后于GPT 5.6
文章内容分散,缺乏技术深度,包含体育争议、电梯算法科普和电视棒安全风险等非工程实践导向信息,对工程师参考价值有限。
入选理由:电梯调度算法中RSR算法在高流量场景表现不稳定
Lovable应用新增Gemini 3.6 Flash和GPT-5.6模型支持,但未披露技术细节与使用场景。
入选理由:Lovable应用现支持Gemini 3.6 Flash和三个GPT-5.6模型
文章内容缺失,仅包含推文链接和标题,未提供技术细节或分析。
入选理由:文章未提供实质性技术内容