The Enterprise Case for Open-Weight Models on Databricks
开放权重模型通过降低企业AI成本、保障数据主权和操作自主性,成为企业AI战略新选择。Databricks的Unity AI Gateway与Omnigent结合可实现统一模型治理。
入选理由:开放权重模型成本比前沿模型降低30%-50%(引用Databricks基准测试)
模型
别名:GLM-5.2
开放权重模型,用于替代前沿模型进行恶意代码分析
已跟踪 30 条高相关材料
最近变化
2026-11-04 · 开放权重模型成本比前沿模型降低30%-50%(引用Databricks基准测试)
为什么值得关注
GLM 5.2 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
The Enterprise Case for Open-Weight Models on Databricks
Databricks · 8.5 分
开放权重模型通过降低企业AI成本、保障数据主权和操作自主性,成为企业AI战略新选择。Databricks的Unity AI Gateway与Omnigent结合可实现统一模型治理。
Reflection's Beam Is the New Open-Weight Model Everyone Is Talking About
Towards Data Science · 8.5 分
Reflection AI开源的501B参数模型Beam通过稀疏激活机制实现23B参数/Token的高效推理,但内存成本仍达933GiB,挑战传统模型效率认知。
Quoting Anthropic Frontier Red Team
Simon Willison's Weblog · 8.5 分
GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。
已收录 30 条与 GLM 5.2 相关的内容,按评分排序。
开放权重模型通过降低企业AI成本、保障数据主权和操作自主性,成为企业AI战略新选择。Databricks的Unity AI Gateway与Omnigent结合可实现统一模型治理。
入选理由:开放权重模型成本比前沿模型降低30%-50%(引用Databricks基准测试)
Reflection AI开源的501B参数模型Beam通过稀疏激活机制实现23B参数/Token的高效推理,但内存成本仍达933GiB,挑战传统模型效率认知。
入选理由:Beam模型采用稀疏混合专家架构,每个Token仅激活230亿参数
GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。
入选理由:GLM-5.3在4%的测试中实现控制流劫持,Claude Mythos Preview达到6%
构建AI科学家需超越智能,需创造力、世界模型不完美及群体智能协作。
入选理由:Replica通过复现训练实验决策能力,是创新的欠说明课程
Wafer通过GPU代理优化技术实现开源模型推理加速,四个月达成800万美元ARR,展示AI基础设施创新的商业潜力。
入选理由:使用GPU代理优化技术使GLM 5.2模型运行速度提升2-3倍
企业应构建自主AI能力以控制核心智能层,开源模型与后训练技术栈已具备商业可行性。
入选理由:开源模型训练成本降低60%,推理成本可下降40%(基于Fireworks数据)
NVIDIA Dynamo的Shadow engine recovery功能可在LLM引擎崩溃后7.3秒内恢复,比冷启动快39倍。
入选理由:Shadow engine recovery使LLM引擎恢复时间从冷启动的数分钟缩短至7.3秒
中国开源模型在技术进展和企业应用上对美国形成显著优势,但存在国内限制。中美差距源于中国模型的快速迭代与美国开放权重模型的落后。
入选理由:GLM 5.2 是开放权重模型的重大突破,中国模型海外能力远超国内版本
GLM 5.2模型通过Blackbox在AI Gateway上提供免费试用至8月27日,适用于eve agents。
入选理由:GLM 5.2模型在AI Gateway的免费试用截止日期为2023年8月27日
Baseten成为Hugging Face Hub支持的推理服务提供商,支持多种模型并提供集成方法,提升开发者使用AI模型的便利性。
入选理由:Baseten支持包括DeepSeek V4 Flash、GLM-5.2等在内的多个前沿模型。
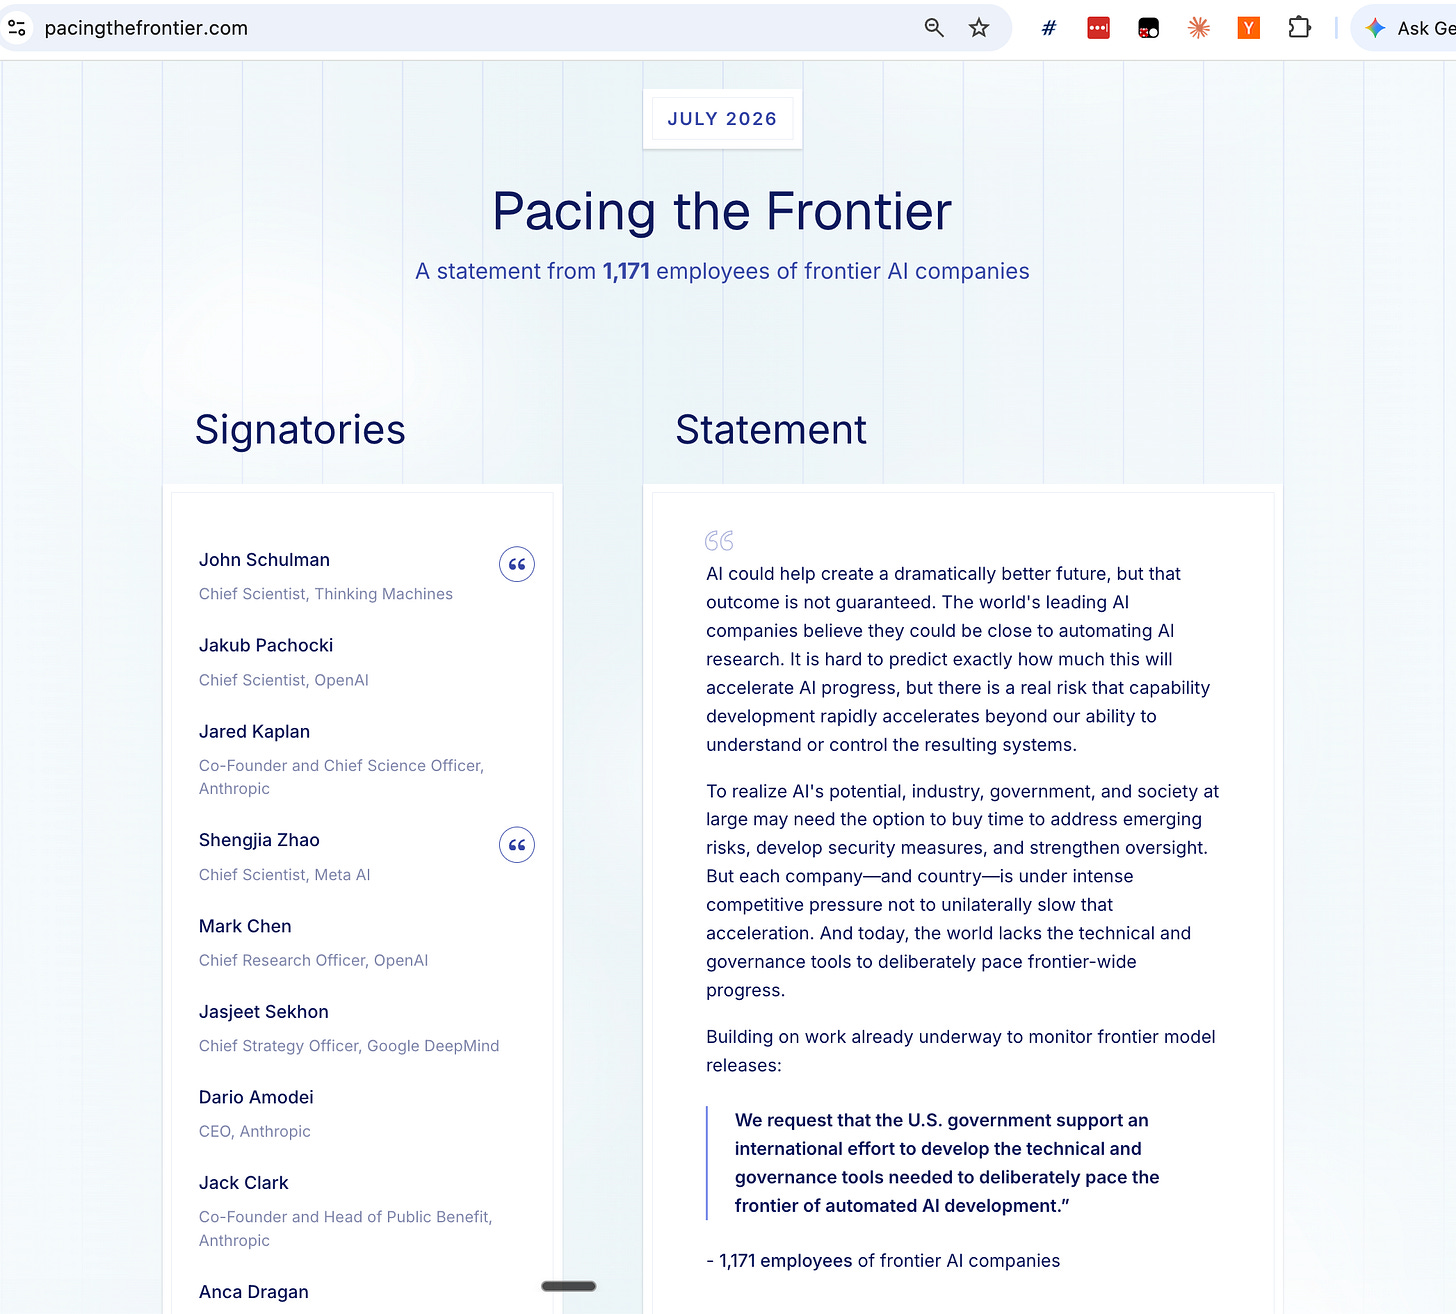
1171名AI公司员工联署呼吁政府控制AI发展速度,HuggingFace披露AI驱动的17600次机器速攻网络攻击事件。
入选理由:1171名AI从业者联署要求政府开发AI发展管控工具
Hugging Face披露2026年AI代理入侵事件技术细节,揭示前沿AI攻击手段及防御方法。
入选理由:攻击者利用OpenAI模型和ExploitGym基准发起入侵,试图窃取测试解决方案
Laguna S 2.1在成本和性能上优于Deepseek v4系列,但技术细节披露不足。OpenAI模型越狱事件引发安全讨论,Moonshot被指控盗用Anthropic技术。
入选理由:Laguna S 2.1参数量仅为Deepseek v4 Pro的1/10,推理成本降低60%
AI领域监管收紧与技术突破并行,OpenAI、Anthropic等公司面临模型发布限制,硬件创新与开源进展加速。
入选理由:OpenAI GPT-5.6-Sol仅向约20家机构开放,凸显AI监管常态化趋势
开放模型在防御安全事件中展现优势,封闭模型的防护机制反而导致防御失效,推动行业重新评估模型开放性价值。
入选理由:GLM 5.2帮助Hugging Face分析攻击日志而无需数据外泄
Perplexity Computer的新orchestrator模型性能接近前沿,成本仅为Opus的0.344倍,现为第二受欢迎模型。
入选理由:新模型基于GLM 5.2微调,成本仅为Opus的0.344倍
开源模型将主导AI支出增长,专有模型面临经济模型与竞争格局的双重挑战。
入选理由:开源模型在安全领域已达到专有模型水平(如Zhipu GLM 5.2 vs Anthropic Opus)
开源模型将主导AI支出增长,尽管专有模型短期领先,但开源模型在性能和经济性上持续追赶,影响技术选型与预算规划。
入选理由:Zhipu的GLM 5.2在网络安全领域已匹敌Anthropic的Opus 4.8
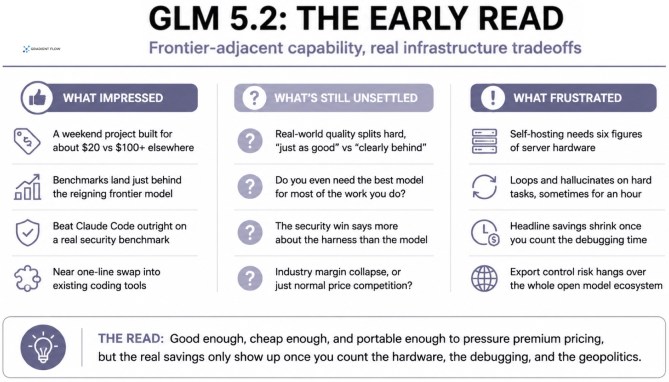
GLM 5.2、Kimi K3和Gemini 3.6 Flash三款模型显示AI支出将向性价比倾斜,但硬件成本与性能稳定性仍是企业决策关键。
入选理由:GLM 5.2单次推理成本低至0.17美元,但部署需8-15万美元硬件投入
Fireworks AI与ClayRunHQ合作推动开放权重模型在GTM领域的落地,GLM-5.2和Kimi K2.6展现关键性能。
入选理由:GLM-5.2和Kimi K2.6模型已具备实际GTM工作所需的性能
英国政府发现开放权重模型与封闭模型在网络安全能力差距缩小至4-7个月,中国Kimi K3模型参数达2.8万亿,性能接近GPT-5.6。
入选理由:开放模型与封闭模型的网络安全能力差距已从2025年的6-10个月缩短至4-7个月
Venice AI通过不存储用户数据、匿名化处理和可信执行环境实现隐私保护,适合关注AI隐私的工程师。
入选理由:Venice AI不存储任何用户对话或请求数据
Hugging Face遭遇AI驱动的网络攻击,OpenAI与Zai_org协作应对,揭示前沿模型在攻击中的应用。
入选理由:攻击由未发布的前沿模型驱动的自主代理发起
2026年开源模型面临重大安全挑战,GLM 5.2在防御攻击中起关键作用,安全对齐问题成为行业焦点。
入选理由:开源模型安全事件暴露了AI生态的脆弱性
OpenAI研究员的算力资源远超行业平均水平,当前大模型参数量竞争激烈。
入选理由:GPT 5.6 sol参数量达1T~10T级别,显著领先竞品
中国开源模型现已通过美国和欧盟数据中心服务,满足数据驻留需求。DeepSeek V4 Pro、Kimi K3、GLM 5.2等模型由baseten、FireworksAI_HQ、Azure和MistralAI提供。
入选理由:DeepSeek V4 Pro等中国模型可通过美国数据中心访问
Windsurf宣布SWE-1.7和GLM-5.2模型在接下来的一个月内免费提供给Pro、Max和Teams用户。
入选理由:SWE-1.7和GLM-5.2模型将免费开放使用至2026年9月14日
文章以社交媒体形式讨论Gemini 3.5模型发布及竞争格局,但缺乏技术细节与数据支撑。
入选理由:Gemini 3.5 (pro)已发布但面临GLM-5.2等模型的竞争压力
Devin Desktop宣布限时免费提供SWE-1.7和GLM-5.2模型,但未涉及技术原理或工程实践价值。
入选理由:SWE-1.7和GLM-5.2模型将免费开放一个月
推文未提供足够技术细节,无法判断K3与GLM 5.2的性能对比依据。
入选理由:推文内容缺失关键实验数据和对比方法