推出 GKE 待机缓冲区:以更低成本提升节点启动速度
Google Cloud Blog1565 字 (约 7 分钟)
92
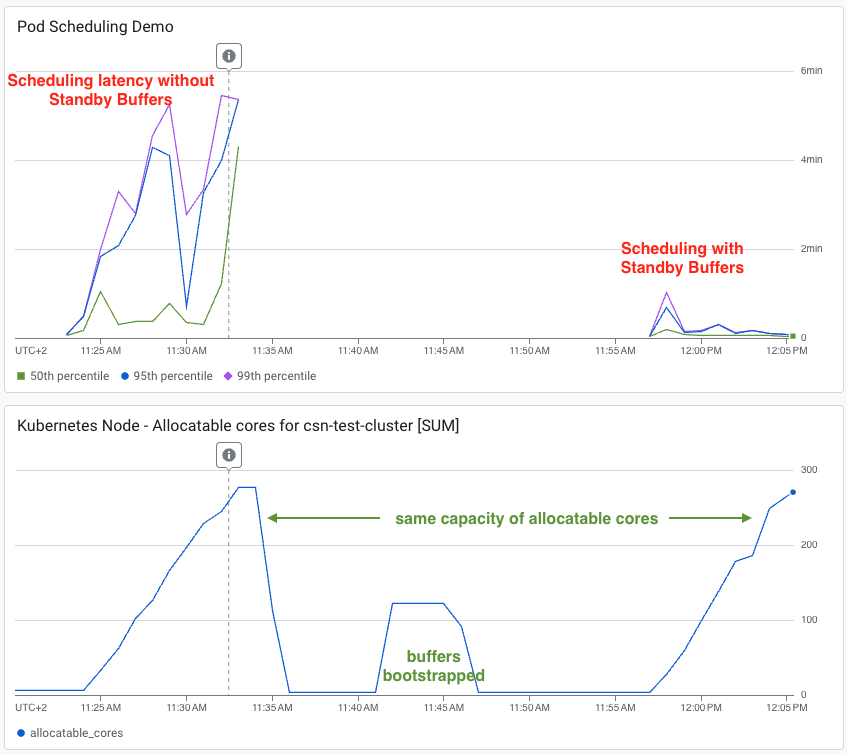
GKE standby buffers 可在几乎不增加成本的前提下将节点启动时间缩短至冷启动的2-3倍,P50延迟从分钟级降至秒级,适用于各类工作负载。
入选理由:GKE standby buffers 成本仅增加个位数百分比,却可使 P50 延迟从 4-6 分钟降至个位数秒。
精选文章#GKE#Kubernetes#自动扩缩容#谷歌云英文
产品
别名:Google Kubernetes Engine
Google Cloud的Kubernetes服务,支持TPU资源管理
已跟踪 17 条高相关材料
最近变化
2026-11-09 · 动态切片使TPU工作负载启动时间缩短5倍,恢复效率提升4.5倍
为什么值得关注
GKE 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
Introducing the GKE standby buffer: Improve node startup times without blowing your budget
Google Cloud Blog · 9.2 分
GKE standby buffers 可在几乎不增加成本的前提下将节点启动时间缩短至冷启动的2-3倍,P50延迟从分钟级降至秒级,适用于各类工作负载。
Now generally available: GKE dynamic slicing for higher resilience, and efficiency for TPUs
Google Cloud Blog · 8.5 分
GKE动态切片功能正式发布,通过解耦TPU物理节点与逻辑切片,使AI工作负载启动时间缩短5倍,恢复效率提升4.5倍。
Shopify Overexposed Scans GKE Ingresses and Cloud Run for Exposure
InfoQ · 8.5 分
Shopify推出的Overexposed工具通过GCP Cloud Asset Inventory和匿名HTTP探针,有效检测GKE和Cloud Run的暴露服务,减少80%的误报。
已收录 17 条与 GKE 相关的内容,按评分排序。
GKE standby buffers 可在几乎不增加成本的前提下将节点启动时间缩短至冷启动的2-3倍,P50延迟从分钟级降至秒级,适用于各类工作负载。
入选理由:GKE standby buffers 成本仅增加个位数百分比,却可使 P50 延迟从 4-6 分钟降至个位数秒。
GKE动态切片功能正式发布,通过解耦TPU物理节点与逻辑切片,使AI工作负载启动时间缩短5倍,恢复效率提升4.5倍。
入选理由:动态切片使TPU工作负载启动时间缩短5倍,恢复效率提升4.5倍
Shopify推出的Overexposed工具通过GCP Cloud Asset Inventory和匿名HTTP探针,有效检测GKE和Cloud Run的暴露服务,减少80%的误报。
入选理由:Overexposed利用GCP Cloud Asset Inventory减少80%的不确定Ingress结果
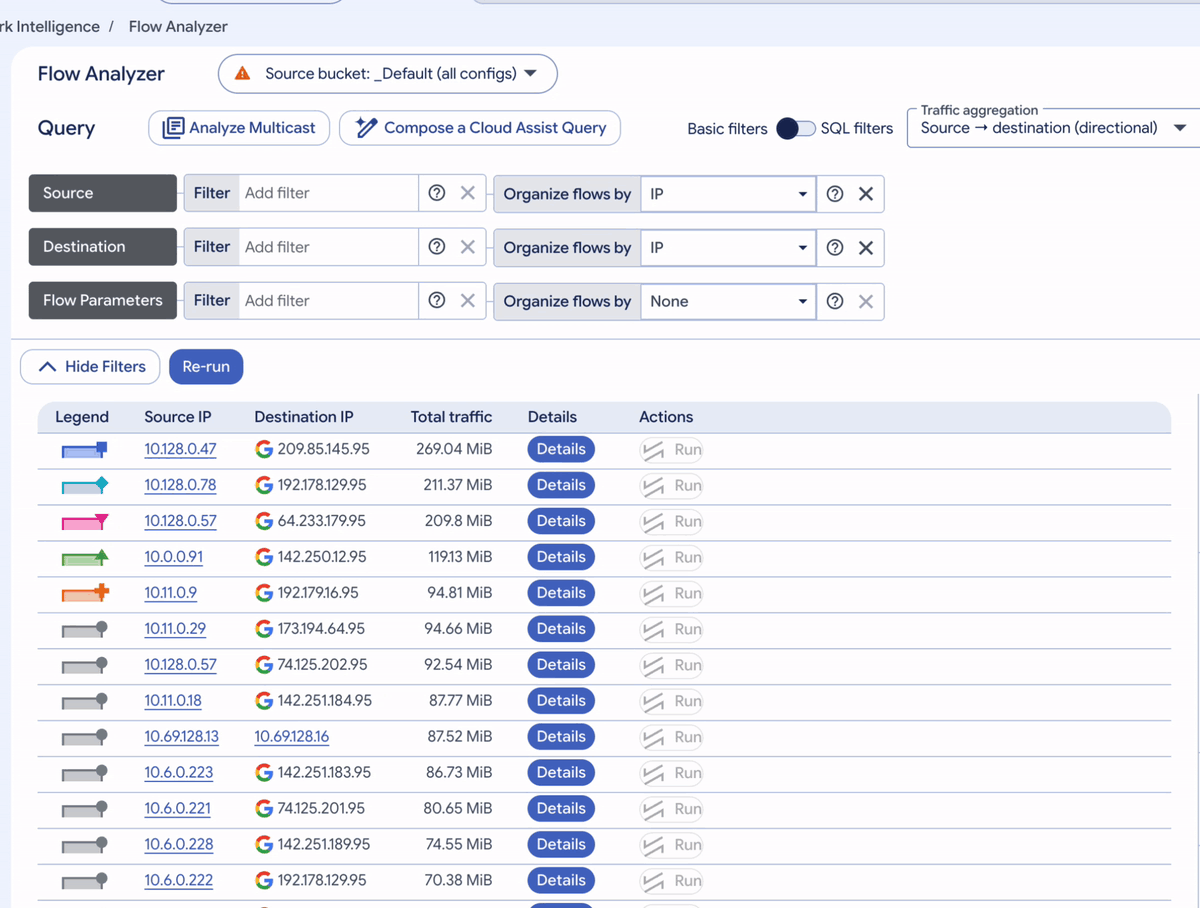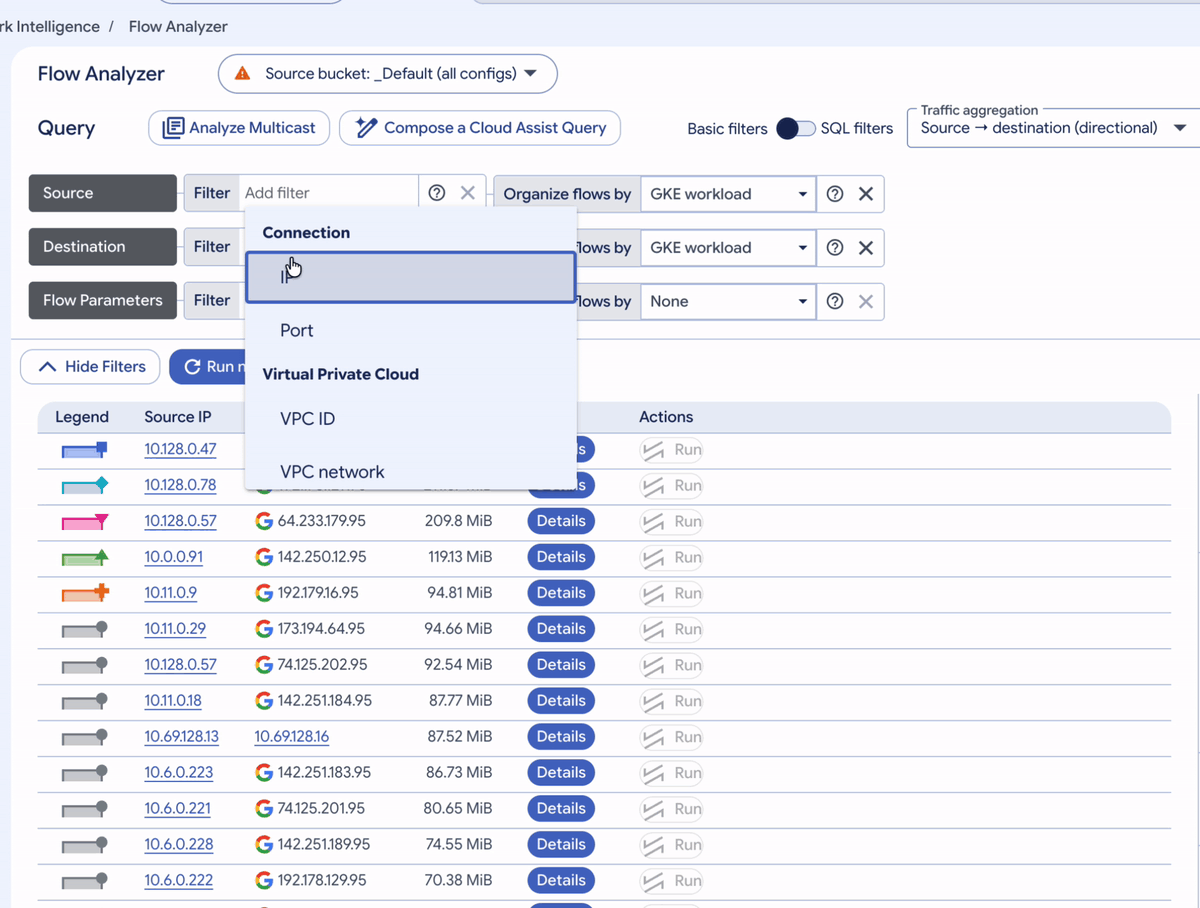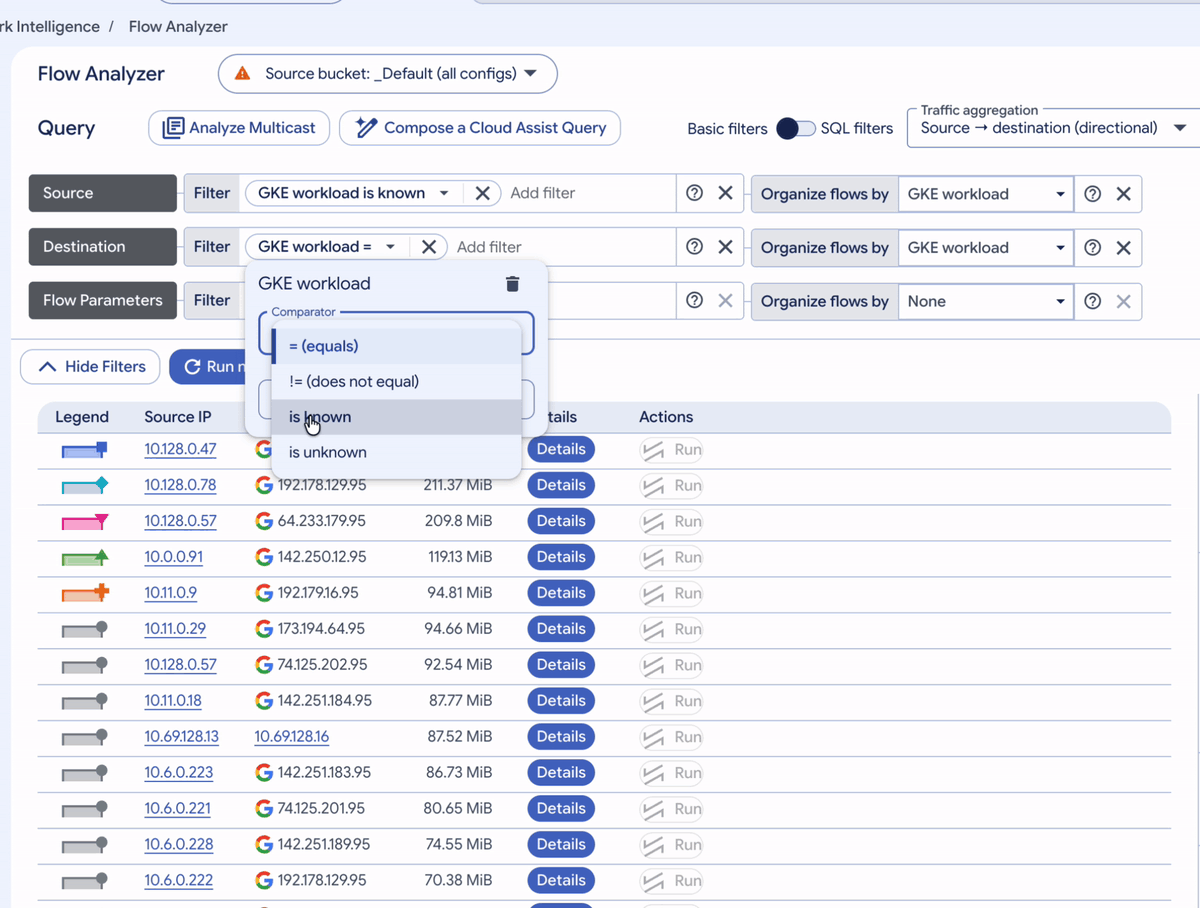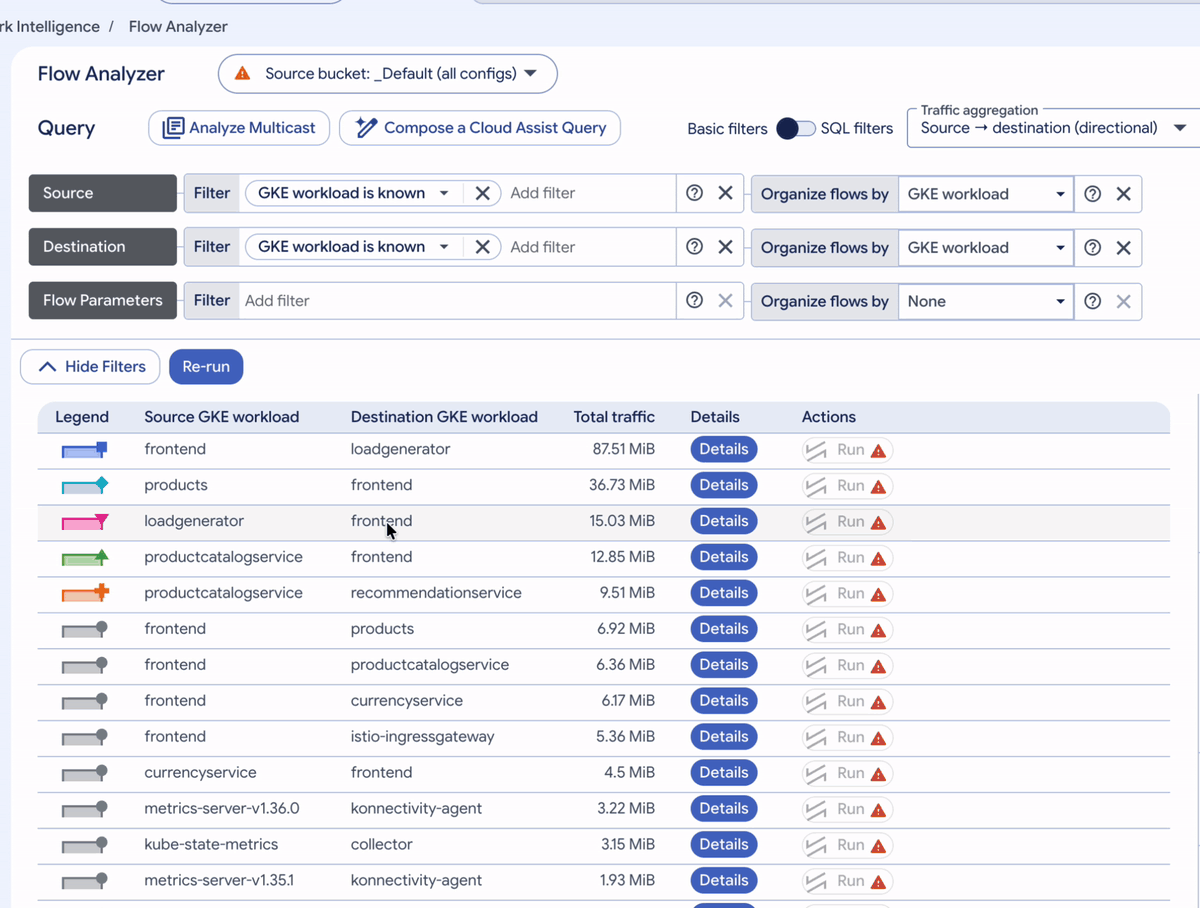
Google Cloud的VPC Flow Logs通过集成GKE元数据,显著提升排查GKE工作负载问题的效率。
入选理由:VPC Flow Logs可自动关联GKE元数据(如Pod名称、命名空间)实现网络流量溯源
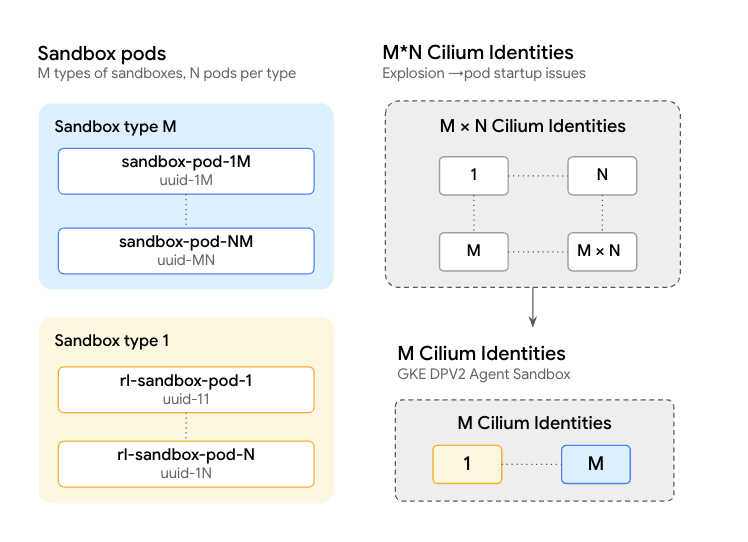
GKE Dataplane V2通过eBPF技术优化网络身份管理,实现亚秒级配置,支持高密度AI代理工作负载。
入选理由:GKE Dataplane V2使用eBPF将Pod标签映射为数字身份,提升网络安全性。
Google Cloud推出Wiz Runtime Sensor作为GKE附加组件,通过eBPF技术实现Kubernetes运行时威胁检测,解决凭证管理、自动化部署等安全难题。
入选理由:Wiz Runtime Sensor通过GKE Secret Manager集成,集中管理凭证降低安全风险
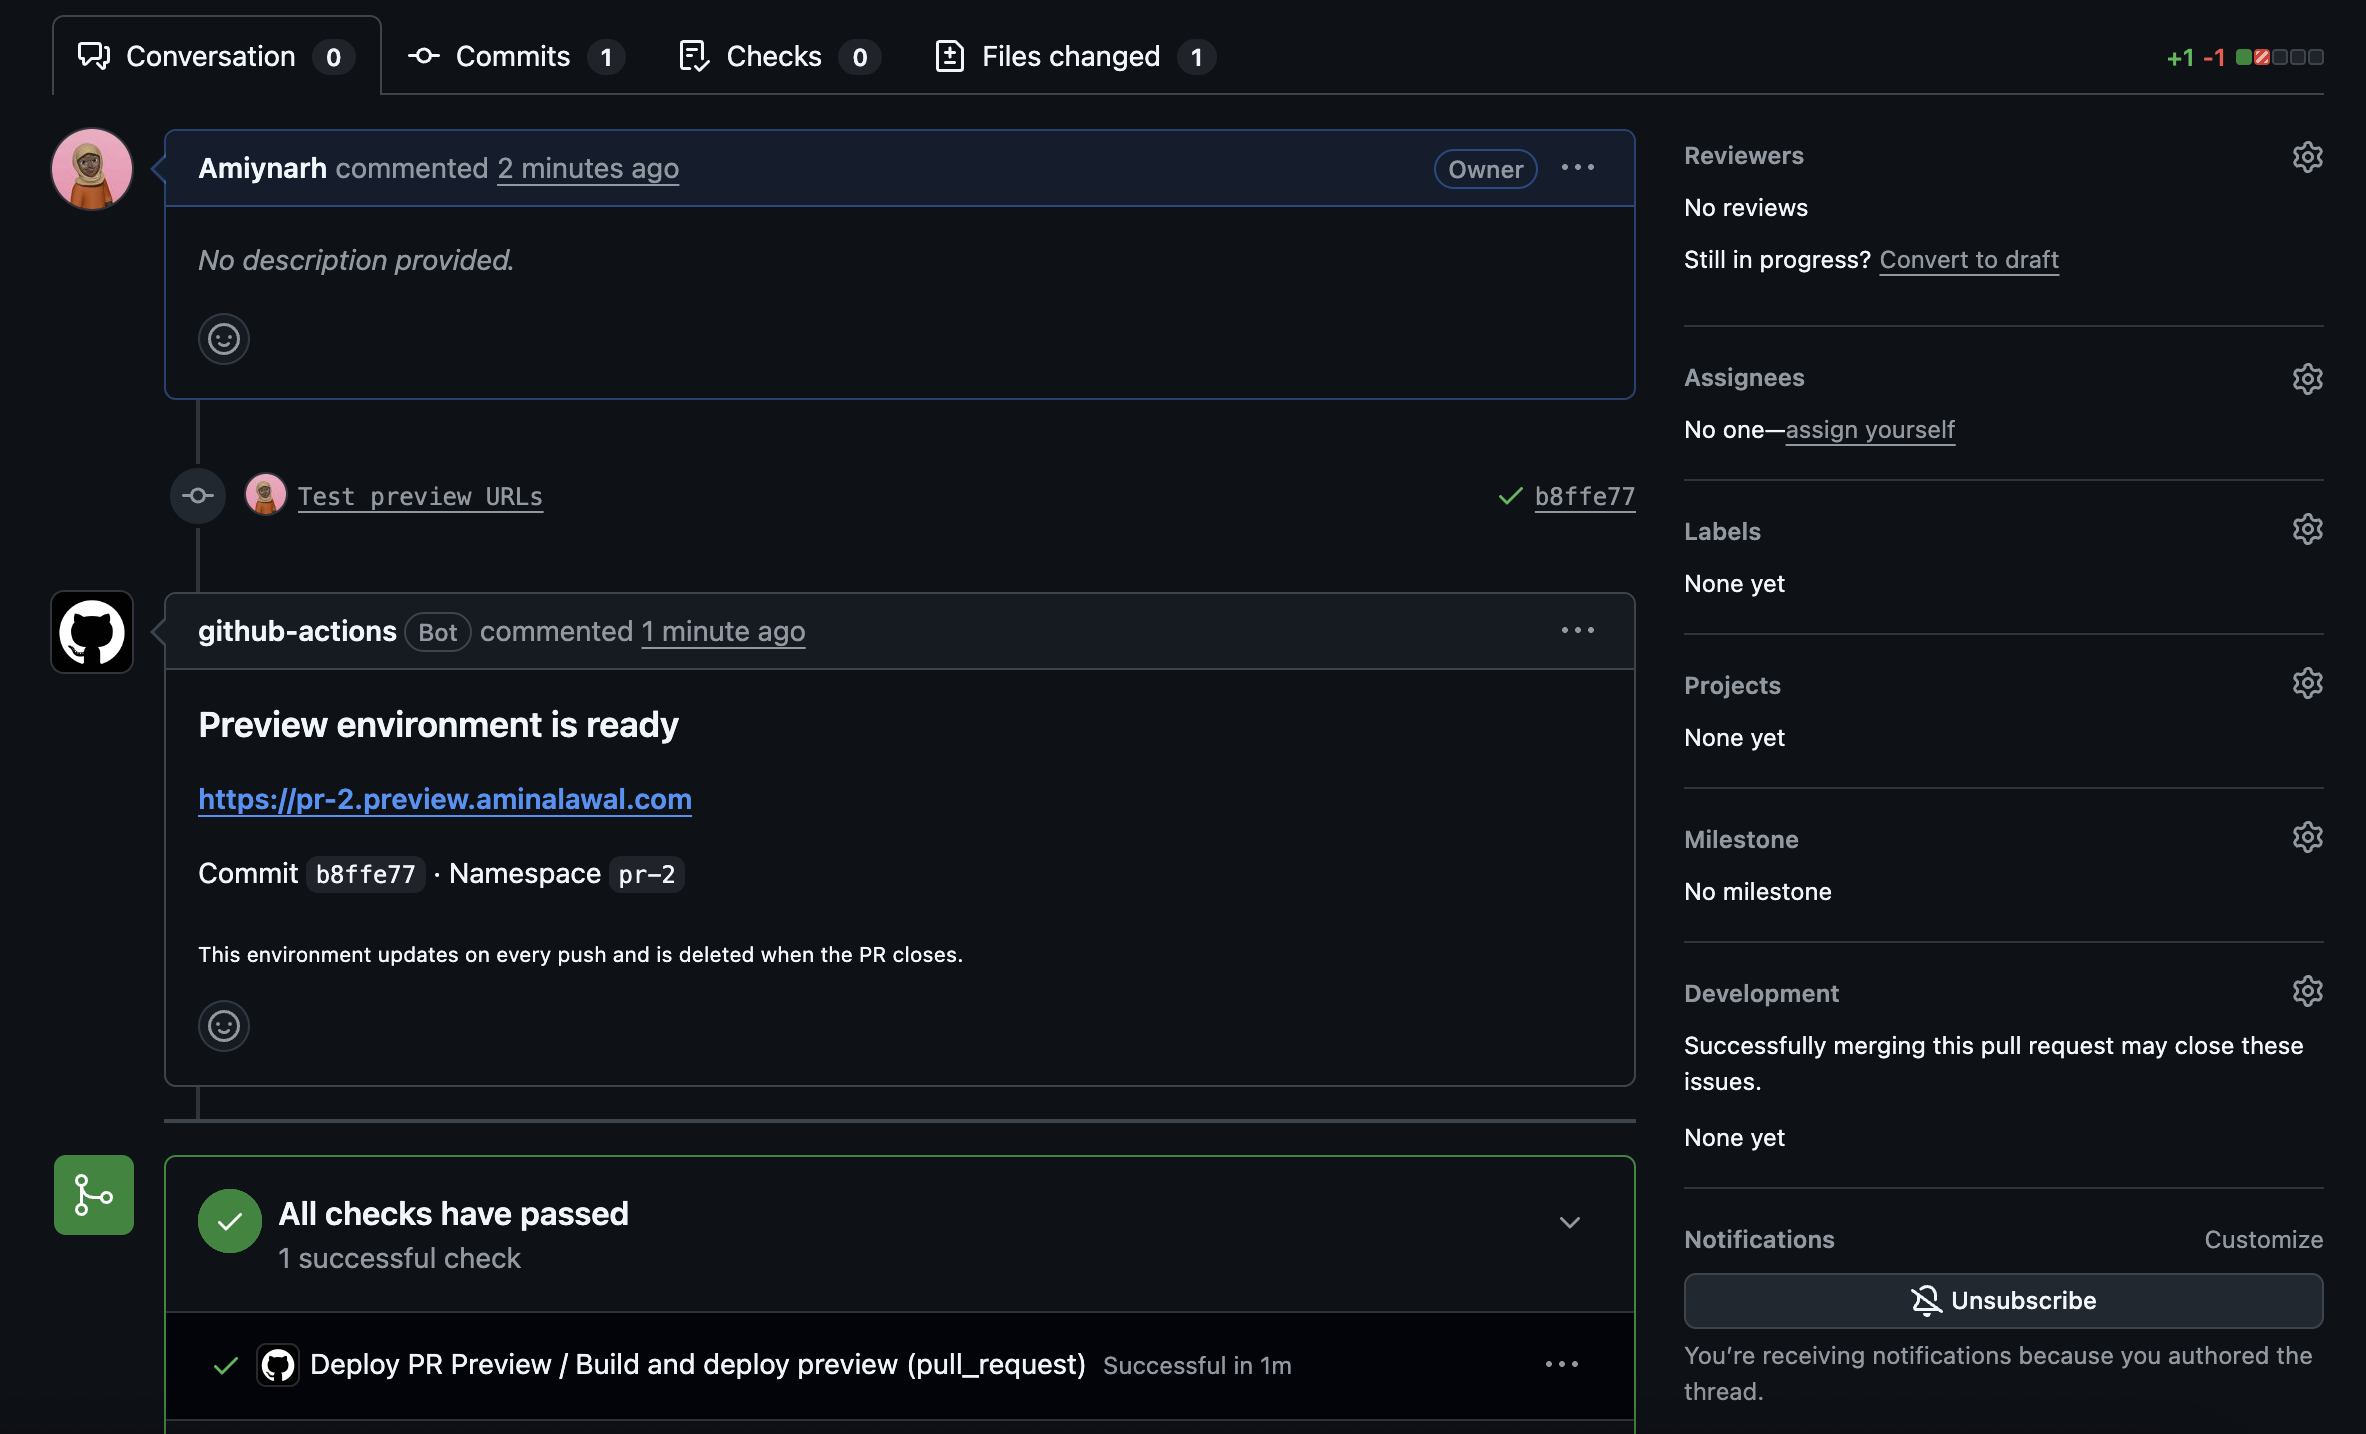
本文介绍如何使用GitHub Actions、Ingress和自动TLS在GKE上构建临时PR预览环境,实现每个PR独立部署和自动清理。
入选理由:每个PR触发GitHub Actions构建独立Kubernetes命名空间(如pr-42)
本文详解AI推理模型服务的两种网络架构设计,分别针对GKE和其他后端,涵盖入口点、通用服务及GKE专用组件,提升部署效率与安全性。
入选理由:GKE架构使用Inference Gateway和Inference pools实现动态负载均衡
Google Cloud推出Filestore agent volumes,提供全托管存储解决方案,解决AI代理工作负载的存储挑战。
入选理由:Filestore agent volumes自动分配存储,减少手动管理,提升效率。
Google Cloud 推出 Agent Substrate,为 GKE 提供高密度、可扩展且安全的代理执行基础设施,支持每秒 500 次挂起/恢复操作。
入选理由:Agent Substrate 在 GKE 上实现 10 倍于标准容器运行时的密度提升
Google Cloud通过vLLM-TPU和GKE实现高精度、可扩展的多模态嵌入推理,支持超长上下文处理。
入选理由:vLLM-TPU集成实现TPU弹性扩展,支持动态调整计算资源。
在TPU上部署Ray AI库需通过topology字段确保多主机模型正确分配资源,避免因跨slice通信失败导致部署停滞。
入选理由:设置topology字段可防止多主机模型跨slice部署,避免集体通信失败
Ray 2.55正式支持TPU加速,通过GKE和Ray Core协作实现TPU资源调度,开发者可复用现有API进行分布式训练。
入选理由:Ray 2.55版本将TPU纳入官方加速器支持体系,提供预构建镜像和全栈库支持
Google Cloud Blog详解GKE Autopilot集群配置DRANET支持GPU/TPU的完整流程,包含代码示例和参数说明。
入选理由:GKE Autopilot集群部署需指定VPC网络和预留资源URL
Google 与 Anyscale 合作优化 Ray Serve LLM 在 GKE 上的性能,实现吞吐量提升 5 倍、延迟降低 8 倍。
入选理由:通过 HAProxy 集成,减少代理开销并提升吞吐量。
GKE 节点启动时间缩短至平均 30 秒以内,显著降低冷启动延迟,提升容器化应用响应速度。
入选理由:GKE 节点启动时间从平均 60 秒降至 30 秒内,减少冷启动延迟。
Google Cloud x NVIDIA开发者社区成立一周年,宣布会员数量突破10万,并推出四条针对AI模型部署、机器学习加速、数据分析和GPU推理的精选学习路径,同时预告未来将聚焦代理式AI内容。
入选理由:社区成立于Google I/O '25,一年内达到10万成员,提供四条精选学习路径包括GKE上部署NVIDIA NIM、加速机器学习工作流、GPU数据分析加速和GPU上AI模型推理入门