当AI构建自身:我们迈向递归自我改进的进展
Hacker News Best5602 字 (约 23 分钟)
92
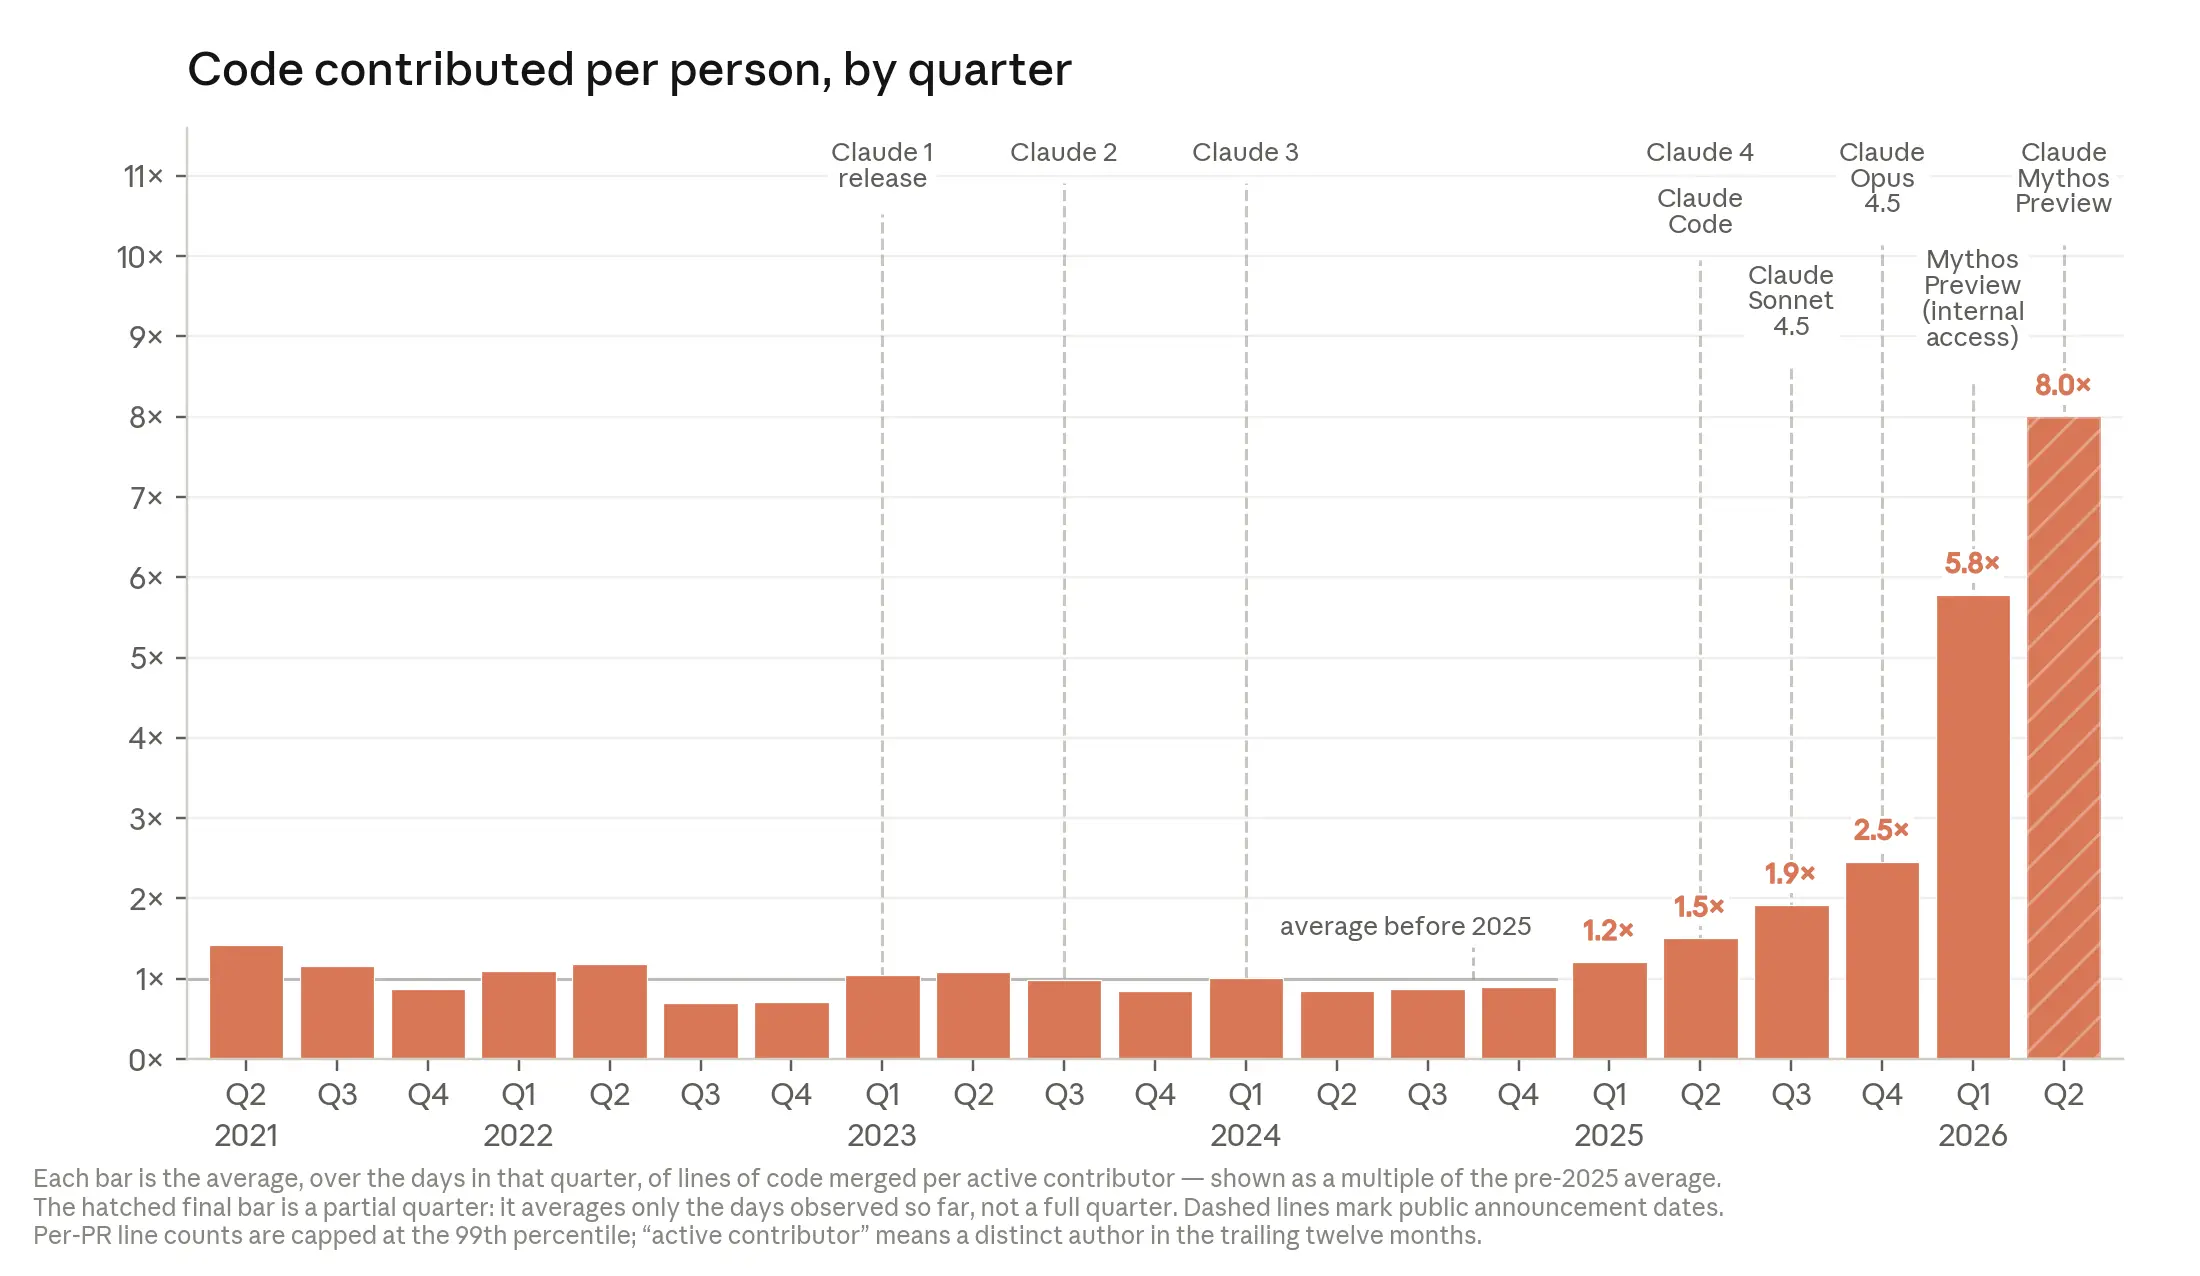
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
入选理由:Anthropic工程师季度代码产出较2021-2025年均值提升8倍,AI已实质性加速研发。
精选文章#递归自我改进#Anthropic#AI智能体#SWE-bench#METR英文
产品
测试AI复现已发表科学研究结果能力的基准测试。
已跟踪 2 条高相关材料
最近变化
2026-11-16 · 同一模型在不同评分标准下得分可能相差极大,如 Claude Opus 4.5 从 42% 提升至 95%。
为什么值得关注
CORE-Bench 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
When AI Builds Itself: Our progress toward recursive self-improvement
Hacker News Best · 9.2 分
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
TensorTonic「从第一性原理讲清评测」:同一模型换评分和配套,排行榜结论就可能翻转 来自 @TensorTonic 的分享,作者先读了 Anthropic、OpenAI 和 Google D...
meng shao(@shao__meng) · 8.5 分
模型评测结果可能因评分标准和配套工具变化而翻转,评测应关注真实结果而非预设路径。
已收录 2 条与 CORE-Bench 相关的内容,按评分排序。
AI递归自我改进正加速到来,Anthropic内部数据显示工程师代码产出提升8倍,模型可靠任务时长每4个月翻倍,预计2027年可处理周级任务。
入选理由:Anthropic工程师季度代码产出较2021-2025年均值提升8倍,AI已实质性加速研发。
模型评测结果可能因评分标准和配套工具变化而翻转,评测应关注真实结果而非预设路径。
入选理由:同一模型在不同评分标准下得分可能相差极大,如 Claude Opus 4.5 从 42% 提升至 95%。
