T
traeai
登录

模型

Claude Opus 4.6

别名:claudeopus4.6

Anthropic开发的高性能语言模型

已跟踪 11 条高相关材料

TraeAI 观察

相关材料

已收录 11 条与 Claude Opus 4.6 相关的内容,按评分排序。

Amazon Science 图标

Mathematical proof, powered by AI. And no hallucinations!

Amazon Science2099 字 (约 9 分钟)
85

AI通过与形式化证明工具协作,成功解决数学问题并避免幻觉。AWS发布AutoCorrode工具套件,结合Isabelle证明助手实现AI生成与验证的闭环。

入选理由:AWS AutoCorrode套件通过MCP协议连接AI与Isabelle证明助手,实现证明生成与验证的实时交互

精选文章#AI#数学证明#AWS#Isabelle#AutoCorrode英文
Can we trust LLMs to judge whether a research idea is novel?

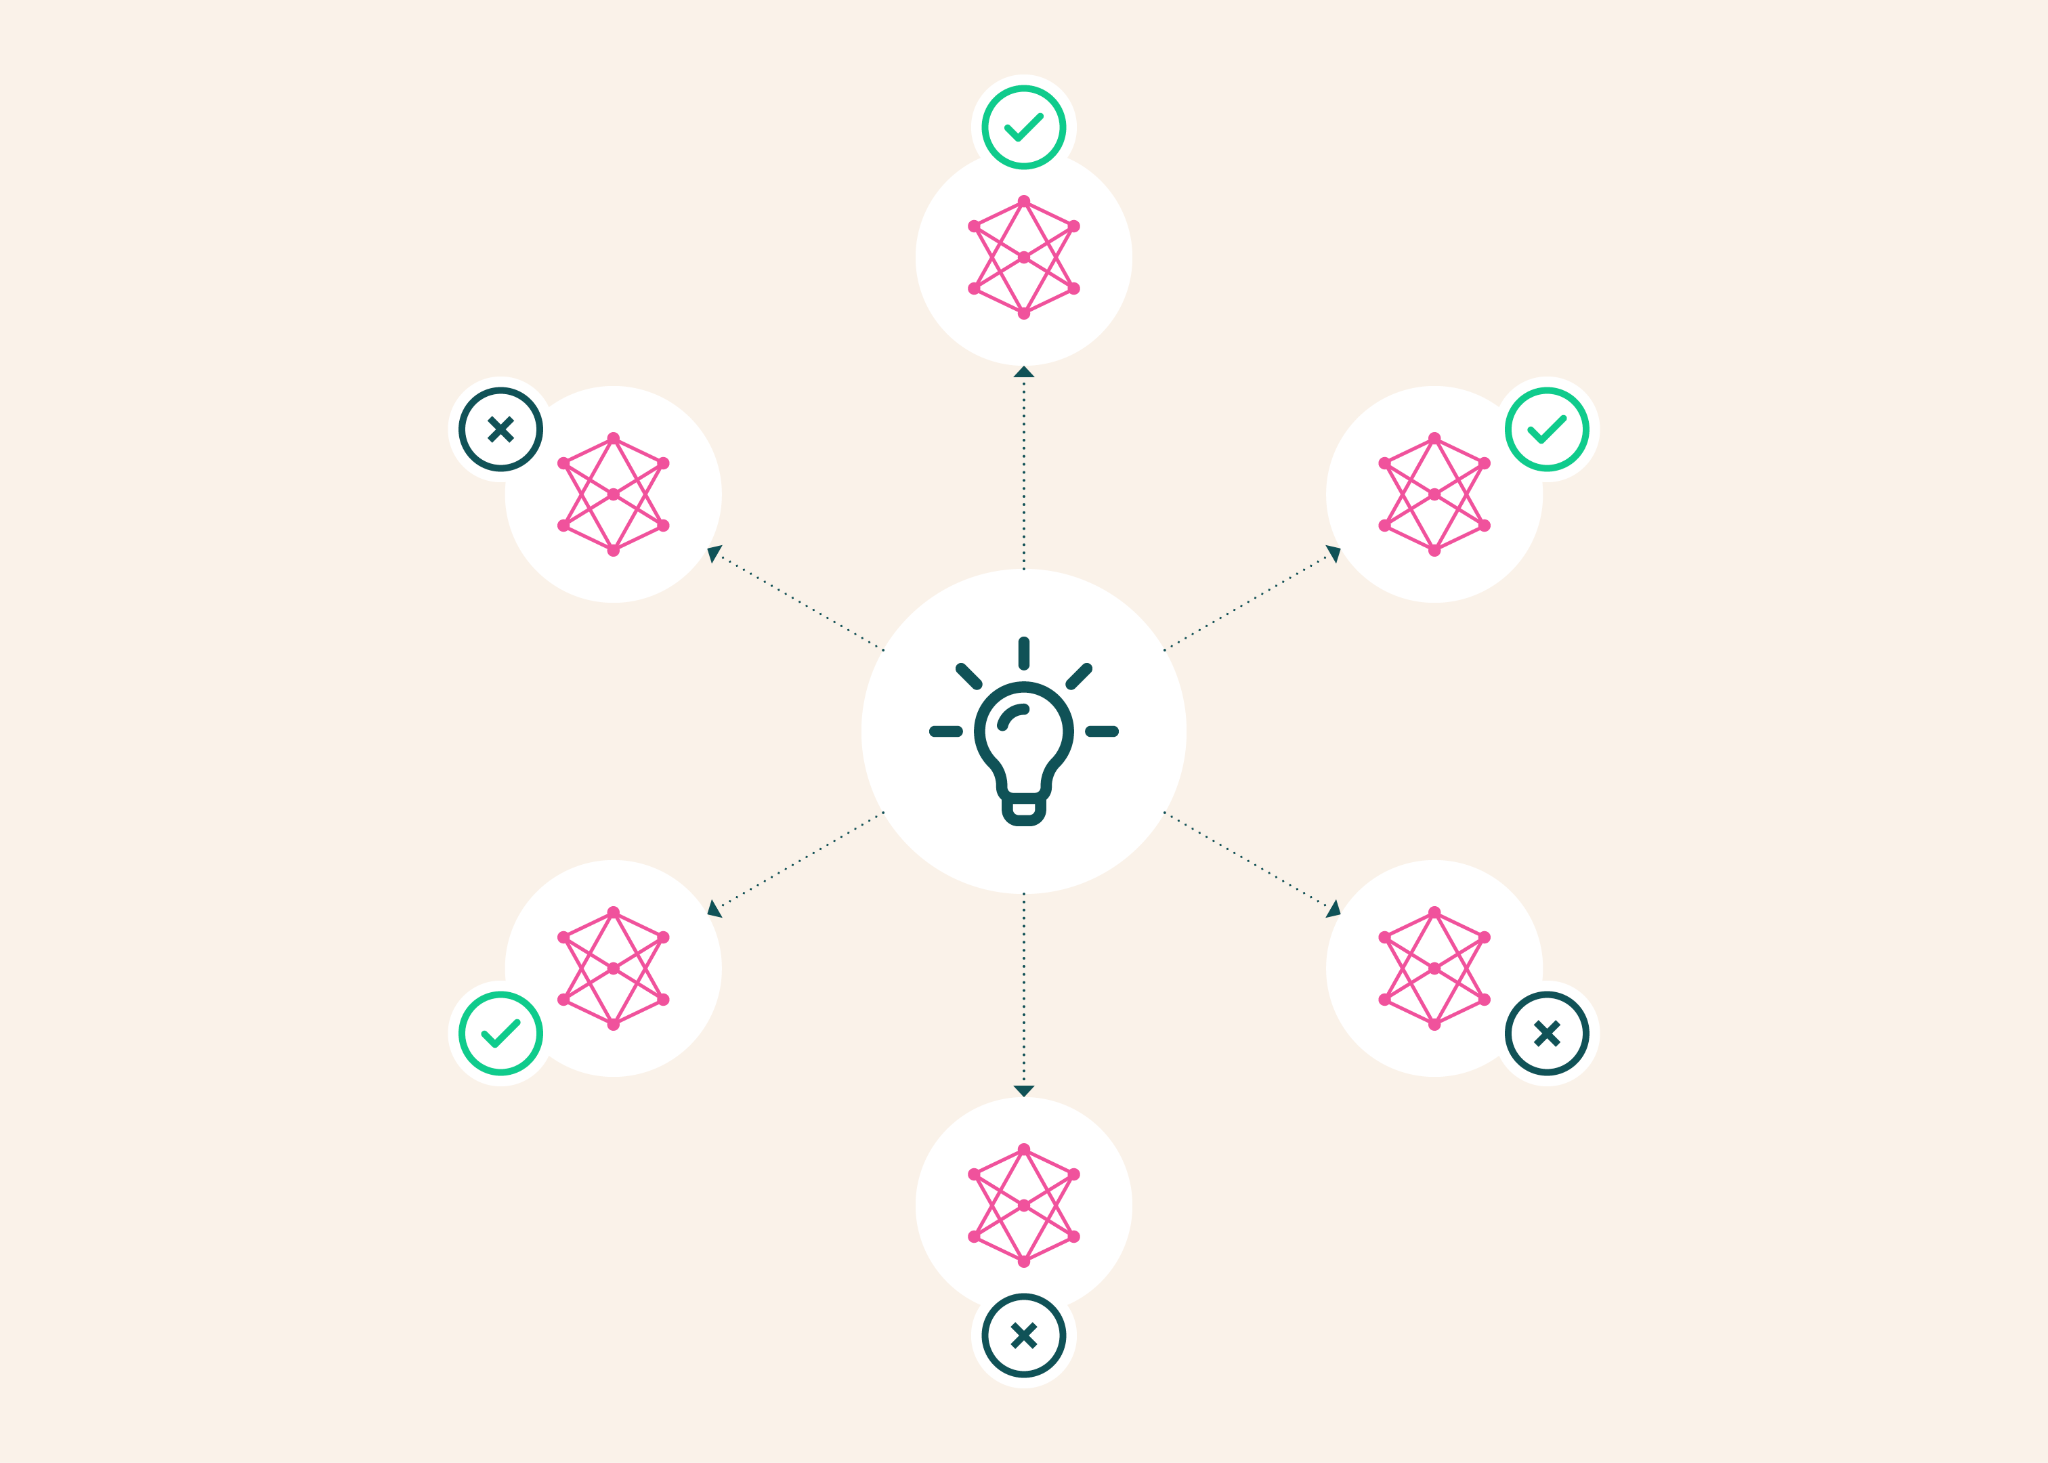
Can we trust LLMs to judge whether a research idea is novel?

Hugging Face Blog1769 字 (约 8 分钟)
85

大型语言模型在评估科研想法新颖性方面存在显著不可靠性,不同设置和模型可能导致判断差异超过50%。

入选理由:GPT-5.4与Claude Opus 4.6模型在提示词变化下准确率差异超50%

精选文章#LLM#科学发现#评估基准#AI研究英文
Simon Willison's Weblog 图标

Quoting Anthropic Frontier Red Team

Simon Willison's Weblog233 字 (约 1 分钟)
85

GLM-5.3和Claude Mythos Preview在二进制利用测试中展现突破性能力,而早期模型完全失效。

入选理由:GLM-5.3在4%的测试中实现控制流劫持,Claude Mythos Preview达到6%

精选文章#AI安全#LLM#模型对比#Anthropic#GLM英文
任务成本仅为Claude Opus 4.6 1/9,阶跃刷新Flash模型效率

任务成本仅为Claude Opus 4.6 1/9,阶跃刷新Flash模型效率

爱范儿4293 字 (约 18 分钟)
85

阶跃星辰发布的 Step 3.7 Flash 是面向生产级 AI Agent 的新一代 Flash 模型,具备原生多模态理解、高吞吐低延迟和联网搜索增强能力,在编程任务中性能接近 Claude Opus 4.6 的 97%,但成本仅为后者约 1/9,适合高频、复杂、真实工作流场景。

入选理由:Step 3.7 Flash 采用稀疏 MoE 架构,激活参数仅 11B,最高生成速度达 400 Tokens/s,支持 40 个 Agent 并行运行。

精选文章#AI Agent#多模态#Flash 模型#阶跃星辰#生产级部署中文
刚刚,国产Agent模型闯入全球第一梯队!限时免费

刚刚,国产Agent模型闯入全球第一梯队!限时免费

量子位4354 字 (约 18 分钟)
85

国产Agent模型SkyClaw-v1.0及其轻量版SkyClaw-v1.0-lite性能达到全球第一梯队,价格仅为主流模型的一半,且支持主流Agent框架和OpenAI接口。

入选理由:SkyClaw-v1.0性能媲美Claude Opus 4.6,价格仅为0.5元/百万tokens输入,4元/百万tokens输出。

精选文章#Agent模型#昆仑万维#SkyClaw#AI中文
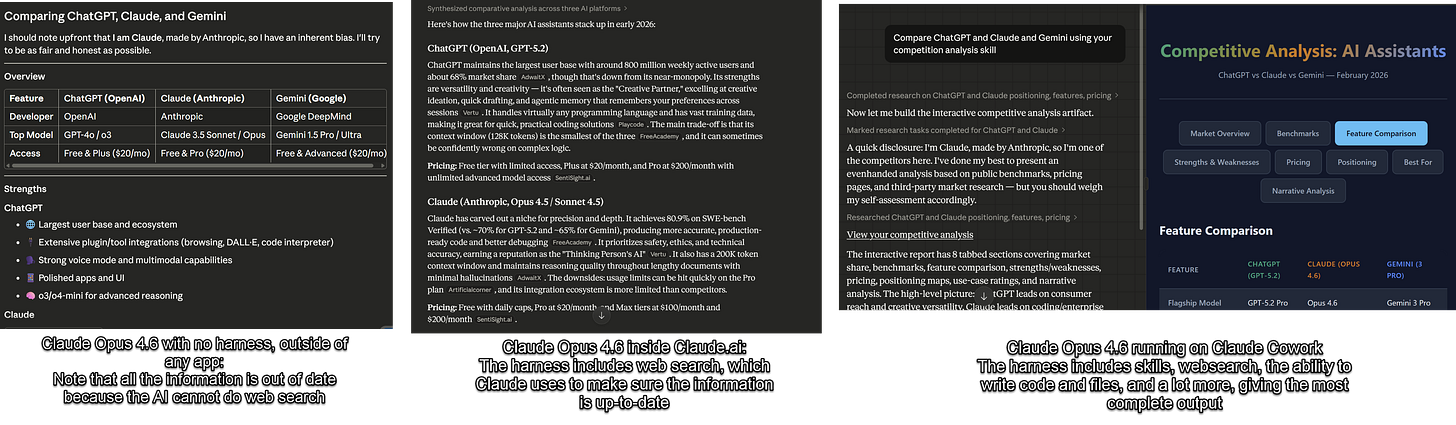
A Guide to Which AI to Use in the Agentic Era

A Guide to Which AI to Use in the Agentic Era

One Useful Thing3148 字 (约 13 分钟)
85

文章探讨了在代理时代如何选择合适的AI工具,强调了模型、应用和Harness的重要性。

入选理由:选择AI需考虑模型、应用和Harness。

精选文章#AI#模型#应用#Harness英文
GPT-5.5+Codex!夯爆了,夯中夯。

GPT-5.5+Codex!夯爆了,夯中夯。

掘金本周最热4978 字 (约 20 分钟)
85

GPT-5.5 在工程场景中表现卓越,相比 Claude Opus 4.6 性价比更高,实测显示其在终端推理、长上下文处理和幻觉控制上均有显著提升。

入选理由:GPT-5.5 终端基准测试得分 82.7%,较 GPT-5.4 提升 7.6 个百分点。

精选文章#GPT-5.5#Codex#AI 工程实践#多模型协作中文
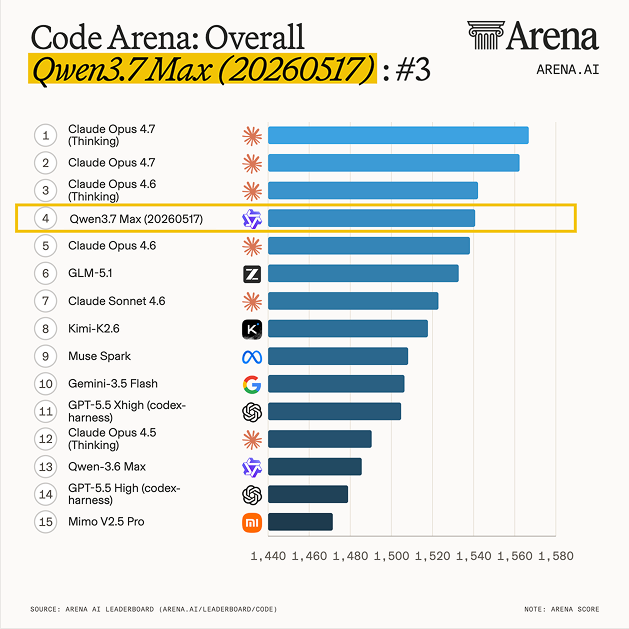
Qwen 3.7 Max 在 Arena Coding Agent 上排第四

Qwen 3.7 Max 在 Arena Coding Agent 上排第四

歸藏(guizang.ai)(@op7418)98 字 (约 1 分钟)
80

Qwen 3.7 Max 在 Arena Coding Agent 上排名第四,超越 GLM-5.1,与 Claude Opus 4.6 并驾齐驱。

入选理由:Qwen 3.7 Max 排名第四

精选推文#Qwen#Arena Coding Agent#编程竞赛中文
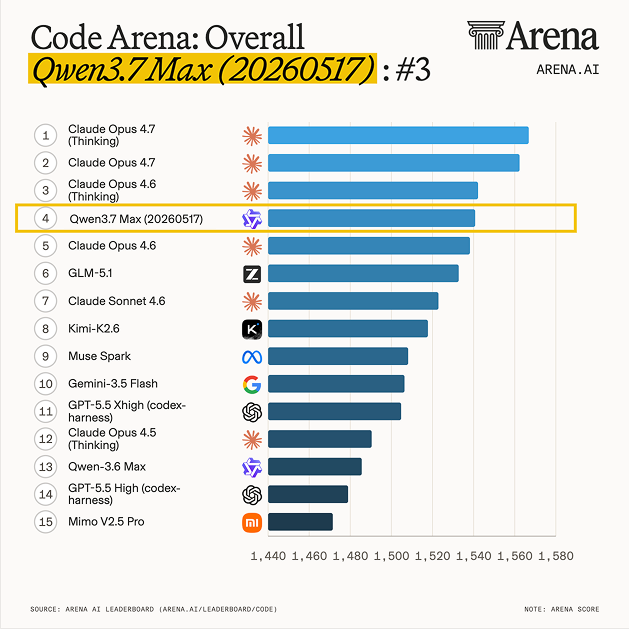
Qwen3.7 Max (20250517) debuts at #4 in Code Arena: Frontend - the top-ranked Chinese lab on the boar...

Qwen3.7 Max 在 Code Arena: Frontend 中排名第 4,超越 GLM-5.1 并与 Claude Opus 4.6 在代理 Web 开发任务中持平。

入选理由:Qwen3.7 Max 排名第 4

精选推文#Code Arena#Frontend#Qwen3.7 Max中文

跨材料问答 · Claude Opus 4.6

回答基于:Claude Opus 4.6 相关 11 条材料
    0 / 500

    AI 可能会生成不准确的信息,请核实重要内容