TensorTonic「从第一性原理讲清评测」:同一模型换评分和配套,排行榜结论就可能翻转 来自 @TensorTonic 的分享,作者先读了 Anthropic、OpenAI 和 Google D...
模型评测结果可能因评分标准和配套工具变化而翻转,评测应关注真实结果而非预设路径。
入选理由:同一模型在不同评分标准下得分可能相差极大,如 Claude Opus 4.5 从 42% 提升至 95%。
模型
别名:Claude Opus
用于生成地图的AI模型
已跟踪 7 条高相关材料
最近变化
2026-11-16 · 同一模型在不同评分标准下得分可能相差极大,如 Claude Opus 4.5 从 42% 提升至 95%。
为什么值得关注
Claude Opus 4.5 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
TensorTonic「从第一性原理讲清评测」:同一模型换评分和配套,排行榜结论就可能翻转 来自 @TensorTonic 的分享,作者先读了 Anthropic、OpenAI 和 Google D...
meng shao(@shao__meng) · 8.5 分
模型评测结果可能因评分标准和配套工具变化而翻转,评测应关注真实结果而非预设路径。
What the hell happened with AGI timelines in 2026? – Rob Wiblin
80,000 Hours Podcast · 8.5 分
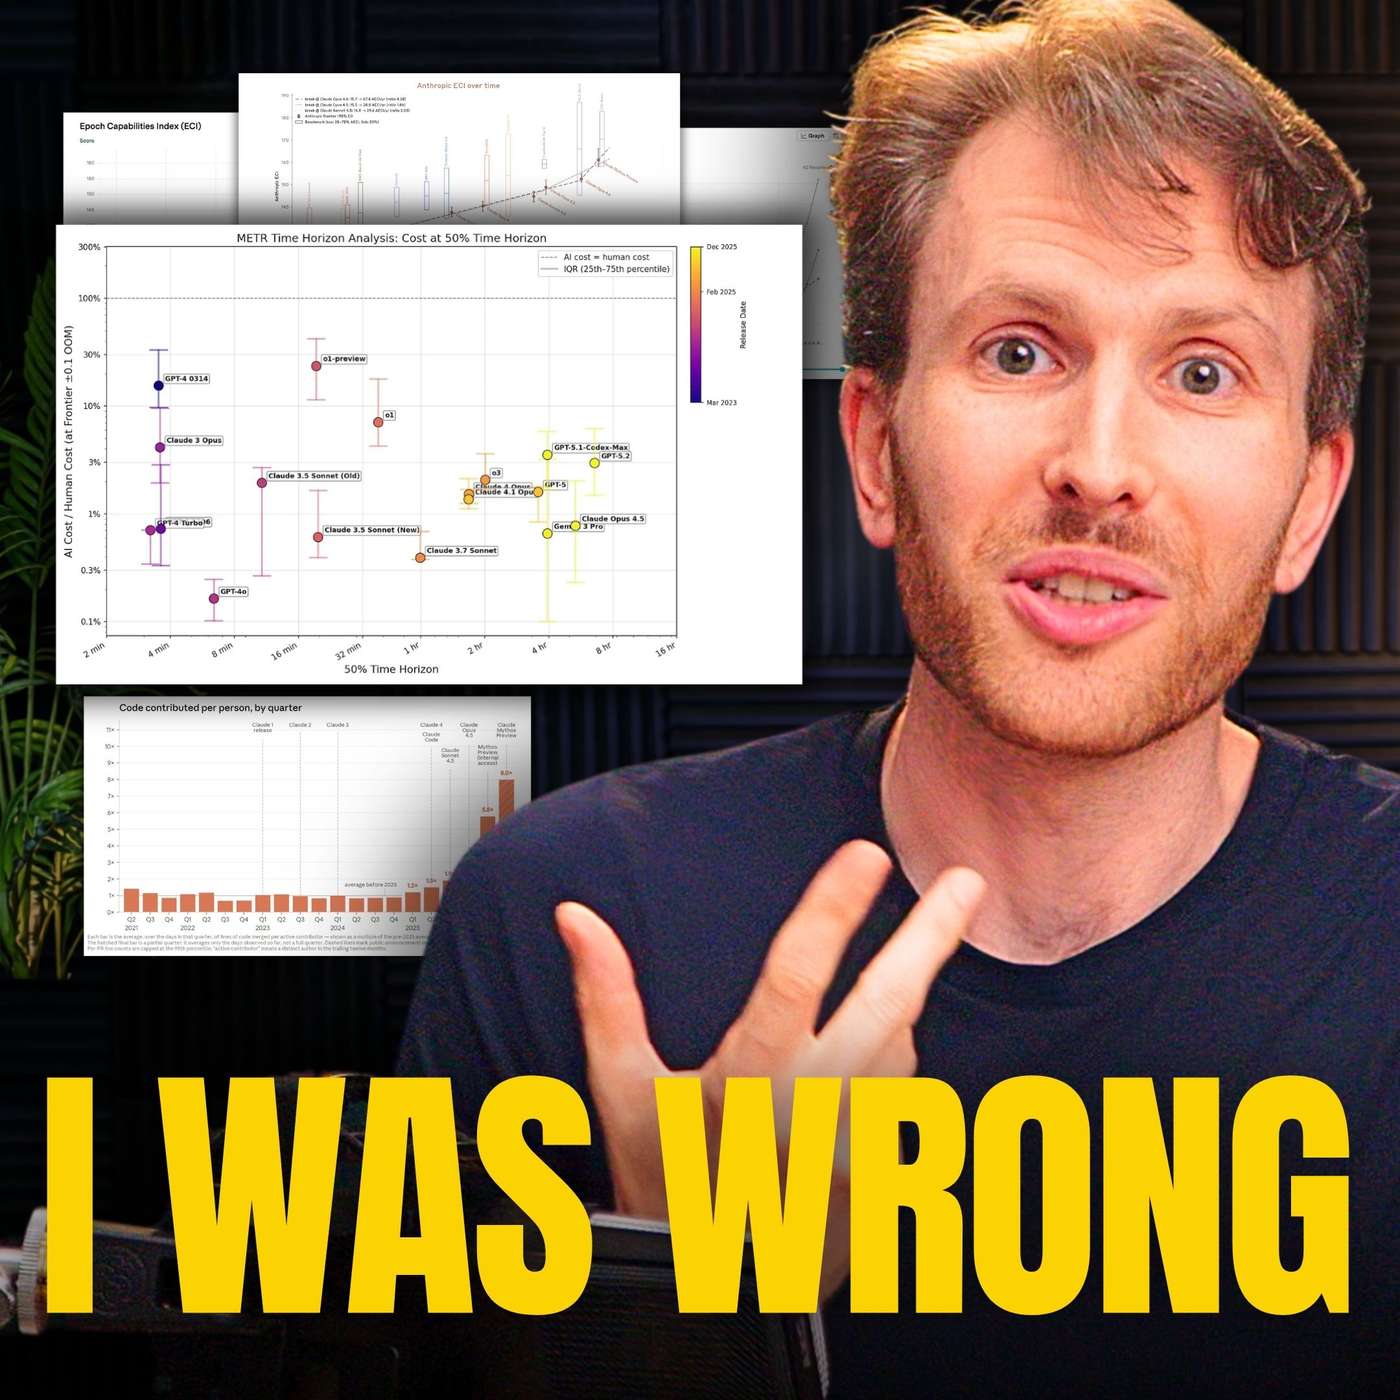
2026年AGI时间线因Claude Opus 4.5突破发生剧变,专家观点从悲观转向乐观,但核心分歧仍存。
Stripe Benchmark Shows AI Agents Build Integrations but Struggle with Validation
InfoQ · 8.5 分
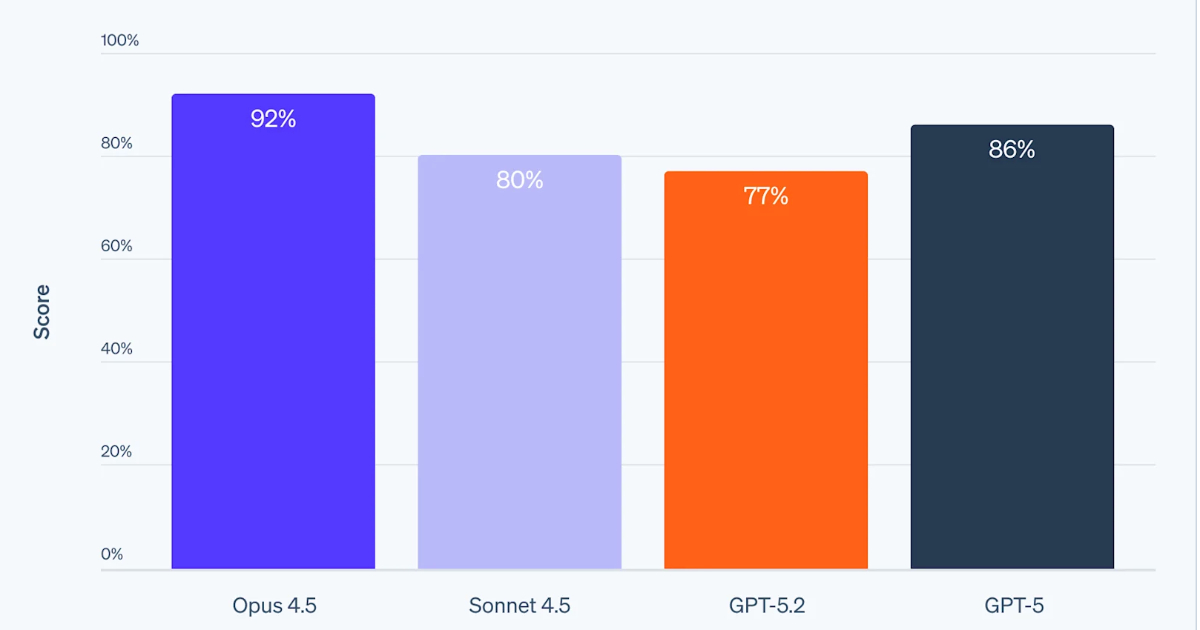
Stripe基准测试显示AI代理能构建集成但验证环节表现不足,正确性仍是金融系统关键挑战。
已收录 7 条与 Claude Opus 4.5 相关的内容,按评分排序。
模型评测结果可能因评分标准和配套工具变化而翻转,评测应关注真实结果而非预设路径。
入选理由:同一模型在不同评分标准下得分可能相差极大,如 Claude Opus 4.5 从 42% 提升至 95%。
2026年AGI时间线因Claude Opus 4.5突破发生剧变,专家观点从悲观转向乐观,但核心分歧仍存。
入选理由:Claude Opus 4.5的发布使AI能力实现数量级提升,引发行业震动
Stripe基准测试显示AI代理能构建集成但验证环节表现不足,正确性仍是金融系统关键挑战。
入选理由:Claude Opus 4.5在全栈API任务中平均得分92%,显著优于GPT 5.2的73%
VibeThinker 3B 是 Weibo AI 发布的模型,性能接近 Kimmy 2.5、Claude Opus 4.5 等大模型,但参数量仅为它们的 1/300。
入选理由:VibeThinker 3B 在特定任务上可与 Kimmy 2.5、Claude Opus 4.5 等大模型竞争。
2025年11月是LLM发展的关键转折点,三大厂商的模型性能在六个月内五次易主,编码代理实现质的飞跃达到日常可用水平,同时Warelay等新兴工具开始出现。
入选理由:2025年11月三大厂商模型性能排名变化5次,Claude Opus 4.5最终胜出
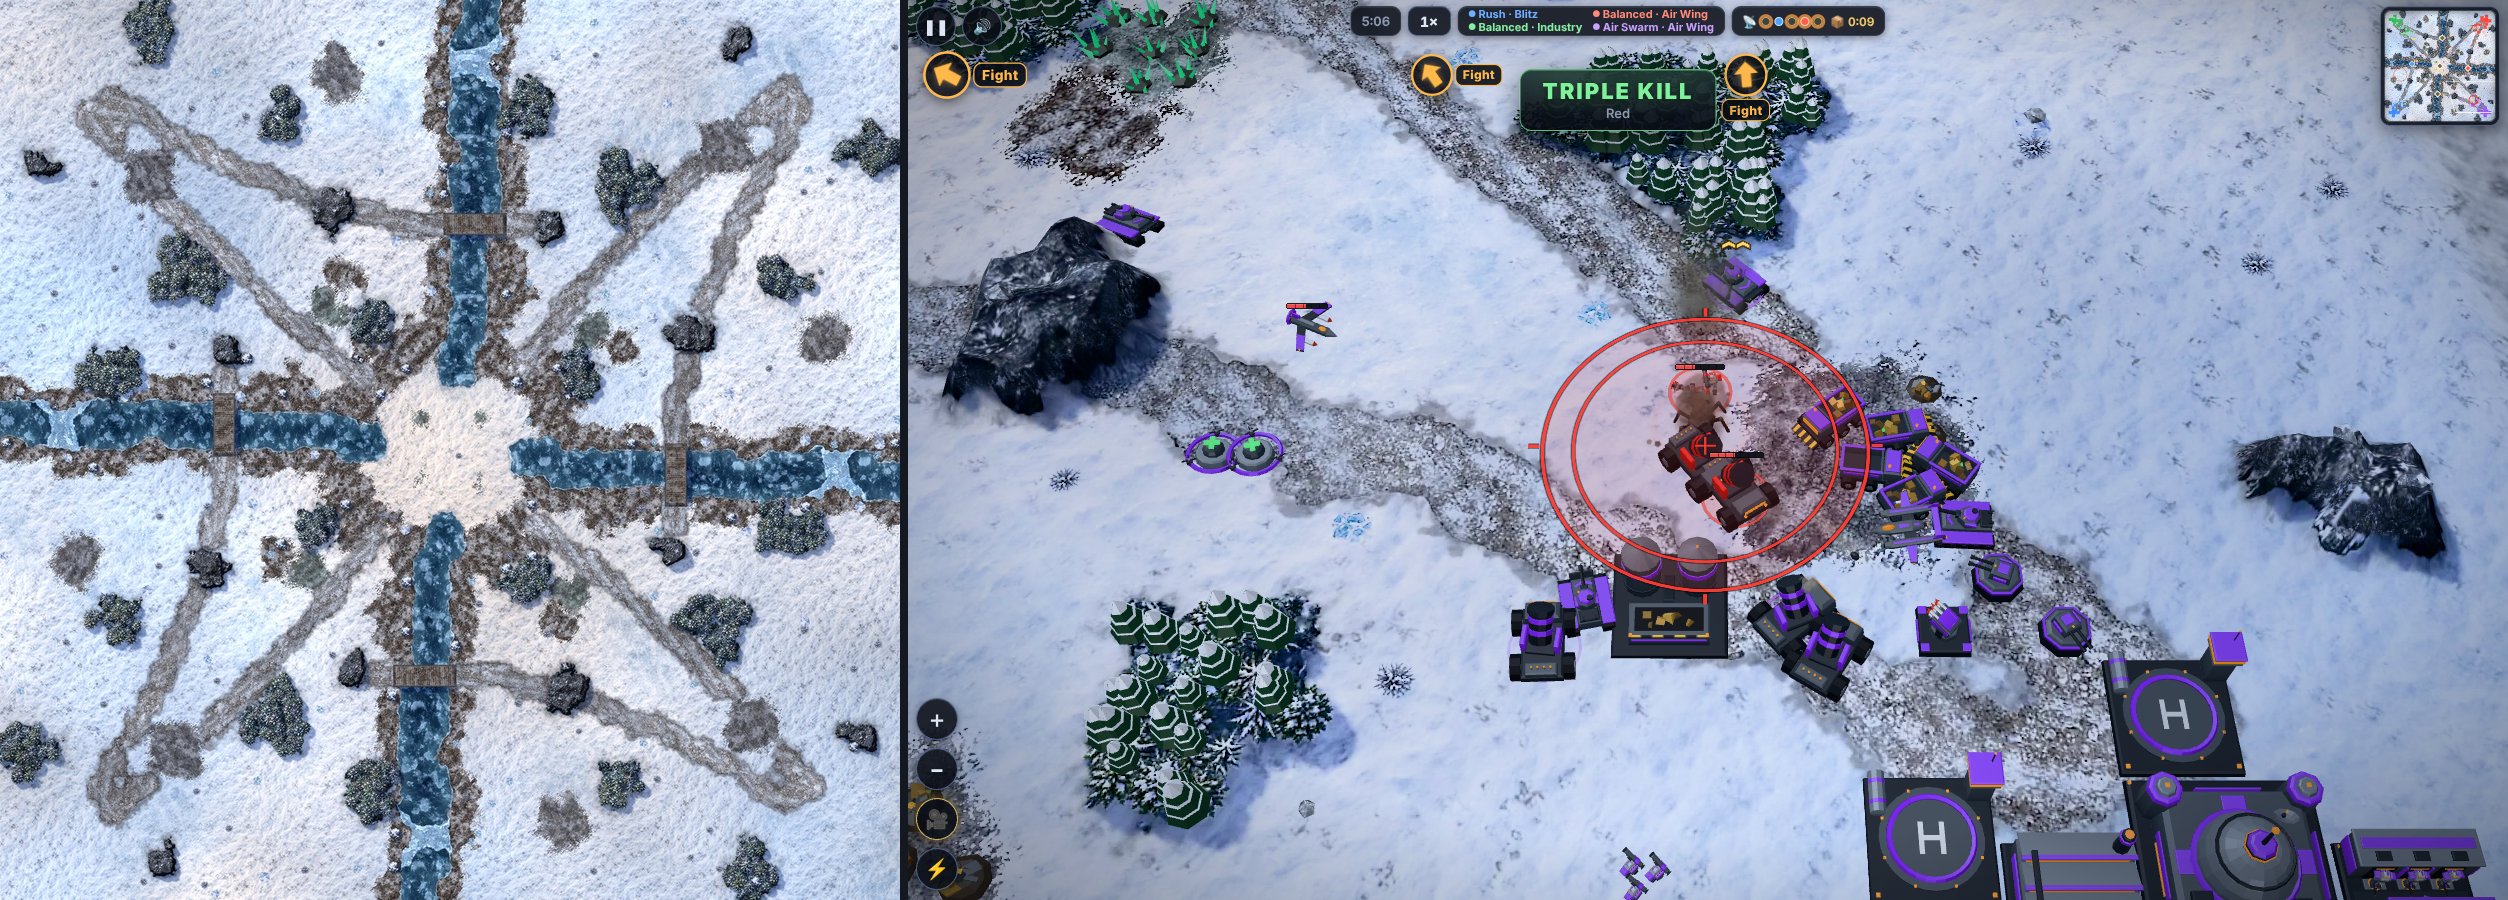
Battledrones v14新增四人在线模式,支持WebSocket多玩家和AI对战。
入选理由:四人模式通过WebSocket实现非音频多玩家连接
Milvus宣布与The Modern Software Developer合作,但文章缺乏技术细节和工程实践价值。
入选理由:Milvus与The Modern Software Developer建立OSS合作伙伴关系