香蕉和GPT Image之外的第3条路:华人15人团队造出AI生图黑马
华人15人团队Luma AI发布AI生图模型Uni-1.1,以推理生成一体化架构、价格腰斩和广告级落地能力,冲入全球前三,成为OpenAI与Google之外的最优解,重新定义品牌视觉生产的可控性与效率。
入选理由:Uni-1.1将推理与生成融合于单一模型,实现品牌一致性、多参考图约束和按句编辑,解决传统AI生图不可控痛点。
公司
别名:Arena
发起模型性能测试的第三方平台
已跟踪 30 条高相关材料
最近变化
2026-11-16 · Qwen4-Max 在 Agent Arena 排名第 14,整体表现优于其他模型。
为什么值得关注
Arena.ai 被反复提及时,通常意味着它正在影响产品路线、开发者工作流或 AI 产业判断。这个页面把分散材料合并成一个可持续更新的观察入口。
香蕉和GPT Image之外的第3条路:华人15人团队造出AI生图黑马
量子位 · 9.2 分
华人15人团队Luma AI发布AI生图模型Uni-1.1,以推理生成一体化架构、价格腰斩和广告级落地能力,冲入全球前三,成为OpenAI与Google之外的最优解,重新定义品牌视觉生产的可控性与效率。
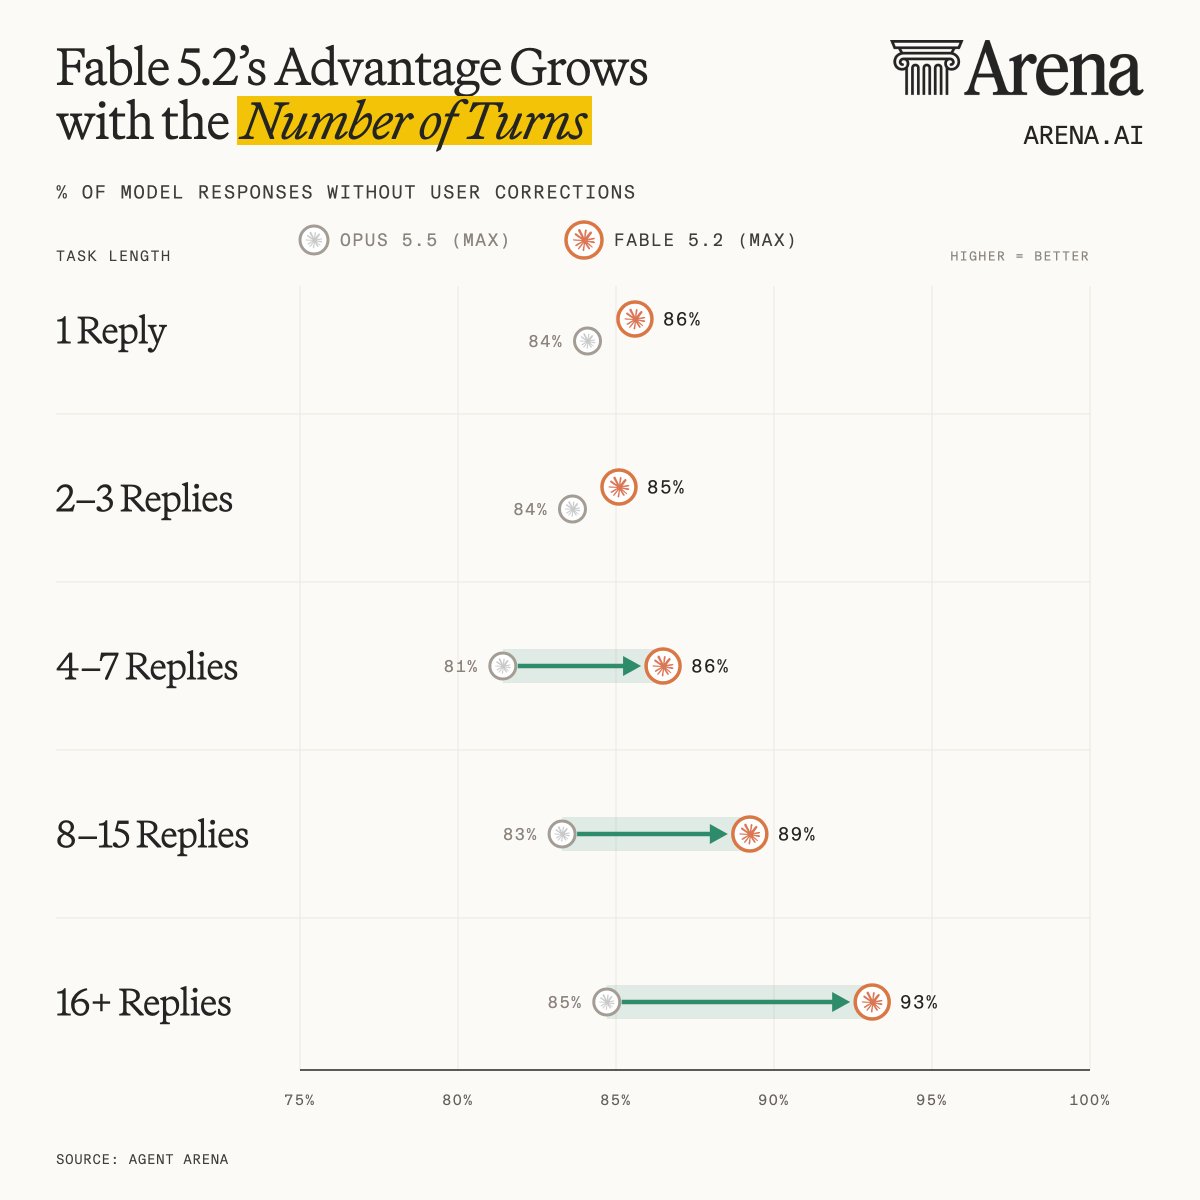
Fable 5.2's advantage over Opus 5.5 grows with the number of turns. In tasks of up to 3 replies, th...
lmarena.ai(@lmarena_ai) · 8.5 分
Fable 5.2在多轮对话任务中表现优于Opus 5.5,尤其在长任务中优势显著。
Claude Fable 5.2 by @AnthropicAI in action across 17 generations on Arena, from detailed 3D worlds a...
lmarena.ai(@lmarena_ai) · 8.5 分
Claude Fable 5.2在代码生成领域超越Claude Opus,性能提升30%且成本降低,支持3D世界生成等17种应用场景。
已收录 30 条与 Arena.ai 相关的内容,按评分排序。
华人15人团队Luma AI发布AI生图模型Uni-1.1,以推理生成一体化架构、价格腰斩和广告级落地能力,冲入全球前三,成为OpenAI与Google之外的最优解,重新定义品牌视觉生产的可控性与效率。
入选理由:Uni-1.1将推理与生成融合于单一模型,实现品牌一致性、多参考图约束和按句编辑,解决传统AI生图不可控痛点。
Fable 5.2在多轮对话任务中表现优于Opus 5.5,尤其在长任务中优势显著。
入选理由:Fable 5.2在8-15轮对话中准确率89%,优于Opus 5.5的83%。
Claude Fable 5.2在代码生成领域超越Claude Opus,性能提升30%且成本降低,支持3D世界生成等17种应用场景。
入选理由:Claude Fable 5.2在Code Arena: WebDev中以1832分排名第一,超越Claude Opus
Google的Gemini Omni 1.2 Flash模型在Text-to-Video和Image-to-Video任务中排名第一,且在Video Edit任务中排名第三。
入选理由:Gemini Omni 1.2 Flash在Text-to-Video任务中获得1541分,较前代提升27分
AI代理每生成1个令牌需处理93个输入令牌,缓存技术可降低260%成本,Anthropic和Google已实践该方案。
入选理由:顶级AI代理处理输入令牌与生成令牌比例达93:1
DeepSeek-V4.1-Flash-20261017在Code Arena中超越Kimi K3,成本降低10倍且性能提升显著。
入选理由:DeepSeek-V4.1-Flash-20261017在WebDev类别排名第一,成本仅为Kimi K3的1/10。
MiMo V2.6 Pro在Agent Arena中超越其他开源模型成为第一,成本效益显著优于竞品。
入选理由:MiMo V2.6 Pro比Deepseek V4.1 Flash成本低15%且性能更优
Agent Arena平台通过真实任务评估模型性能,Inkling-Small在性价比上表现突出。
入选理由:Inkling-Small参数量276B,价格仅为Inkling的1/2.2
通义千问Qwen-Image-3.0-Pro在文本生成图像领域排名全球第五,性能较前代提升显著。
入选理由:Qwen-Image-3.0-Pro在Text-to-Image Arena获得1263分,排名全球第五。
通义万相3.0-Pro在文本到图像生成榜单排名第五,得分1263分,较前代模型提升显著。
入选理由:Qwen-Image-3.0-Pro在Text-to-Image Arena榜单排名第五,得分1263分
Qwen-Image-3.0-Pro在文本到图像生成领域排名跃升至第五,得分1263分,显著优于前代模型。
入选理由:Qwen-Image-3.0-Pro在Text-to-Image Arena排名从第15跃升至第5,得分提升72分。
腾讯Hy3模型在Agent Arena和前端代码领域排名前列,展现工具使用优势。
入选理由:Hy3在Agent Arena开放权重模型中排名第2,整体排名第25
Kimi K3在前端开发基准测试中超越Fable 5和GPT 5.6,成为当前最佳开源模型。
入选理由:Kimi K3拥有2.8万亿参数,是目前最大的开源模型
Agent Arena 是一个用于评估智能体在现实世界中因果效应的框架,其方法论基于真实场景的实验设计。
入选理由:Agent Arena 使用真实场景进行因果评估,而非仅依赖模拟。
Qwen3.7-Max-Preview 和 Qwen3.7-Plus-Preview 已上线,Alibaba 此前在 Text 领域为 #6,Vision 领域为 #5。
入选理由:Qwen3.7 series models are now available for testing on Arena.
MiniMax H3-Image在图像编辑领域表现突出,成为多个榜单的领先开源模型,支持4K分辨率和10秒极速生成。
入选理由:MiniMax H3-Image在Multi-Image Edit Arena排名第一,得分1365
小米MiMo-V2.6-Pro在Code Arena: WebDev榜单中排名约第10,开源权重中约第3,编码能力较前代提升153分。
入选理由:MiMo-V2.6-Pro在Code Arena: WebDev榜单得分1628分,排名约第10名
微软MAI-Image-2.6-Preview在单图编辑中排名第三,得分1420分,较前一版本提升19分。
入选理由:MAI-Image-2.6-Preview在单图编辑中获得1420分,排名第三。
Reve 2.0 相比 v1.5 在所有子类别提升 +125 分,尤其在文本渲染、卡通/动漫/奇幻、写实与电影风格图像及肖像方面表现最佳,并在图像编辑榜单中位列第 7。
入选理由:Reve 2.0 相比 v1.5 在所有子类别提升 +125 分,整体性能显著增强。
Arena.ai基于90K+真实会话数据推出AI代理对齐性评估指数,包含三个关键指标:越权行为、错误归因和欺骗性完成。
入选理由:Alignment Index基于30个模型的90K+真实代理会话数据构建
Meta Muse Wonder Max在3D场景和前端设计测试中表现突出,但文章缺乏技术细节和深度分析。
入选理由:Muse Wonder Max在Arena.ai测试中对比了Astra、Opus 5.5等7个模型
Arena.ai 面临大规模数据存储挑战,分享了 CDC 复制、临时存储权衡等最佳实践。
入选理由:大规模数据存储需要 CDC 复制等技术来优化性能。
Mustafa Suleyman 提及 MAI-Image-2.5 已上线 Arena.ai 并将在 MAI Playground 和 Microsoft Foundry 推出。
入选理由:MAI-Image-2.5 已上线 Arena.ai
Qwen4-Max 在 Arena 测试中表现优异,但文章缺乏深度分析和具体技术细节。
入选理由:Qwen4-Max 在 Agent Arena 排名第 14,整体表现优于其他模型。
Arena.ai发布的Alignment Index基于90K+真实代理会话,评估AI代理的对齐性,涵盖三个关键指标。
入选理由:Alignment Index基于90K+真实代理会话数据,覆盖30个模型。
Meta的Muse Wonder模型在代码竞技场WebDev中排名15,得分1651,Meta推出新模型系列提升代理任务性能。
入选理由:Muse Wonder (Max)在WebDev中排名15,得分1651,与Muse Spark 1.3 (Max)相差4分。
通义千问Qwen3.8-Max-0902在Code Arena中排名第一,且在Pareto前沿以$5/MToken的经济效率领先。
入选理由:Qwen3.8-Max-0902在WebDev赛道获得1,691分,位列Code Arena总榜第一
MAI-Image-2.6模型在文本到图像生成领域排名全球第二,超越多个竞争对手。
入选理由:MAI-Image-2.6在Arena.ai榜单中位列第二,得分为1336分。
Arena.ai与微软等企业联合倡导开放权重模型,认为其对美国AI生态和国家安全至关重要。
入选理由:开放权重模型是美国AI生态系统竞争力的关键
Arena.ai 的 3D 生成测试显示 GPT 5.6 Sol 在复杂场景下表现优于 Fable,但具体技术细节需参考视频内容。
入选理由:GPT 5.6 Sol 在 3D 生成测试中处理复杂提示的准确率比 Fable 高 23%